
Self-Hosted Deployment
ओपन सोर्स computer vision deployment framework Inference के साथ अपने स्वयं के hardware पर Roboflow models और Workflows चलाएँ।
इन्फ़रेंस एक ओपन सोर्स कंप्यूटर विज़न डिप्लॉयमेंट हब है। यह मॉडल और वर्कफ़्लोज़ को सर्व करता है, वीडियो स्ट्रीम्स को मैनेज करता है, और CPUs तथा GPUs के लिए इन्फ़रेंस को ऑप्टिमाइज़ करता है। जब आपको लोकल प्रोसेसिंग, लेटेंसी और संसाधनों पर नियंत्रण, या ऑफ़लाइन डिप्लॉयमेंट की आवश्यकता हो, तो इसे स्वयं होस्ट करें। Apache 2.0 लाइसेंस वाला कोर Roboflow के होस्टेड APIs को भी शक्ति देता है।
एक मार्ग चुनें
अपने खुद के हार्डवेयर पर मॉडल चलाने के तीन तरीके हैं। अधिकांश प्रोजेक्ट्स Inference Server का उपयोग करते हैं।


जब एक से अधिक क्लाइंट या भाषा को प्रेडिक्शन की आवश्यकता हो, जब आप चाहते हों कि मॉडल आपकी ऐप्लिकेशन डिपेंडेंसीज़ से अलग रहें, या जब आप edge डिवाइसों पर डिप्लॉय करें, तब सर्वर का उपयोग करें।

मॉडल को लोकली चलाएँ
अधिकांश प्रोजेक्ट्स के लिए, Docker में Inference Server चलाएँ और inference-sdkके साथ अनुरोध भेजें। SDK एक Python HTTP क्लाइंट है जो आपकी ऐप्लिकेशन को Inference Server से जोड़ता है। जब आपको अपने Python प्रोसेस के अंदर सीधे मॉडल लोड और चलाने हों, तब Inference Library का उपयोग करें। दोनों पथ समान model_id मान स्वीकार करते हैं, इसलिए आप बाद में इनके बीच स्विच कर सकते हैं।
Model IDs
द model_id पैरामीटर हो सकता है:
एक प्रशिक्षित मॉडल उपनाम, उदाहरण के लिए
rfdetr-smallयाrfdetr-largeआपका अपना Roboflow से fine-tuned मॉडल, उदाहरण के लिए
my-project/1एक Universe मॉडल, उदाहरण के लिए
soccer-players-xy9vk/2
Fine-tuned मॉडल्स और Universe मॉडल्स के लिए एक API key.
इंस्टॉल करें
सर्वर को शुरू करें Inference CLIके साथ। यह आपके हार्डवेयर का पता लगाता है और सुरक्षित डिफ़ॉल्ट्स के साथ सही Docker इमेज खींचता है:
फिर HTTP क्लाइंट इंस्टॉल करें:
हार्डवेयर आवश्यकताओं, प्रति-डिवाइस गाइड्स, और मैनुअल docker run कमांड्स के लिए, देखें इन्फ़रेंस सर्वर इंस्टॉल करें। वही क्लाइंट सर्वरलेस क्लाउड API और समर्पित डिप्लॉयमेंट्सके साथ भी काम करता है: केवल api_url बदलता है।
इन्फ़रेंस चलाएँ
द api_key_transport="header" सेटिंग कुंजी को केवल एक Authorization: Bearer हेडर के रूप में भेजती है, जिससे यह URLs और लॉग्स में नहीं जाती। इसके लिए release 1.5.0 या नए का inference server चाहिए; उपयोग करें api_key_transport="both" जब तक आप पुराने सर्वरों को कॉल करते रहते हैं। देखें API key transport.
बदलें api_url को https://serverless.roboflow.com का उपयोग करने के लिए सर्वरलेस क्लाउड API इसके बजाय, बिना किसी अन्य कोड परिवर्तन के। देखें Inference SDK संदर्भ विवरण के लिए।
परिणामों का विज़ुअलाइज़ करें
इंस्टॉल करें Supervision:
इंस्टॉल करें
इंस्टॉल करें इन्फ़रेंस पैकेज को अपने खुद के Python वातावरण में:
यदि आपके पास NVIDIA GPU है, तो इसके बजाय inference-gpu इंस्टॉल करें, और index URL को आपके OS में इंस्टॉल CUDA संस्करण से मिलाएँ:
देखें इन्फ़रेंस लाइब्रेरी backend extras और GPU सेटअप विवरण के लिए।
इन्फ़रेंस चलाएँ
get_model() पहली बार उपयोग पर model weights डाउनलोड और cache करता है, फिर लोकली inference चलाता है। देखें Inference Python Package संदर्भ विवरण के लिए।
परिणामों का विज़ुअलाइज़ करें
इंस्टॉल करें Supervision:
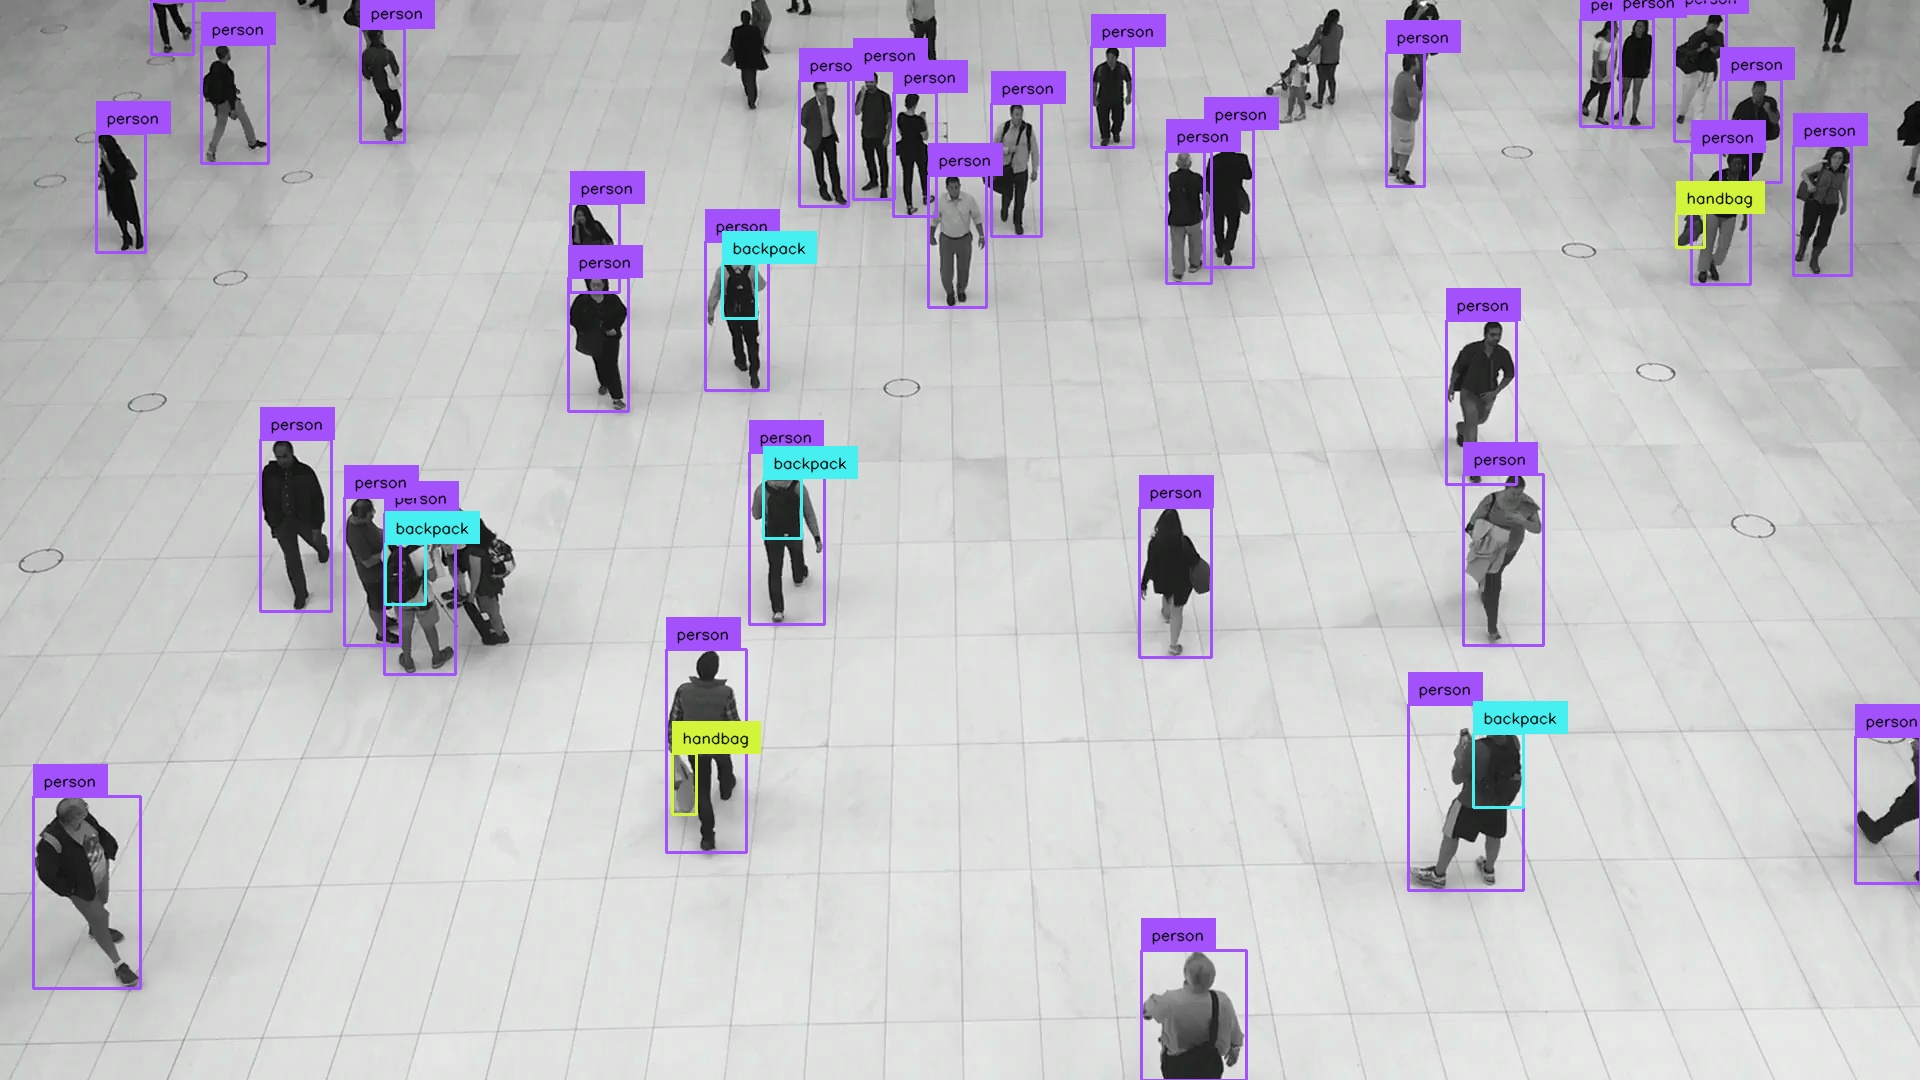
सावधान रहें कि अपनी API key बाहरी उपयोगकर्ताओं को उजागर न करें। इसे सार्वजनिक-उपयोग वाले frontend ऐप में एम्बेड न करें; इसके बजाय अनुरोध को अपने backend के माध्यम से proxy करें।
आप एक वर्कफ़्लो इसी तरह, सर्वर पर या अपने खुद के प्रोसेस में चला सकते हैं: देखें वर्कफ़्लो डिप्लॉय करें.
अंतिम अपडेट
क्या यह उपयोगी था?