> For the complete documentation index, see [llms.txt](https://docs.roboflow.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.roboflow.com/deployment/ja/self-hosted/self-hosted.md).

# Self-Hosted デプロイメント

オープンソースのコンピュータビジョンデプロイメントフレームワークである Inference を使って、自分のハードウェア上で Roboflow のモデルと Workflow を実行します。

[推論](https://github.com/roboflow/inference) は、オープンソースのコンピュータビジョン向けデプロイメントハブです。モデルとワークフローを提供し、動画ストリームを管理し、CPU と GPU 向けに推論を最適化します。ローカル処理、レイテンシとリソースの制御、またはオフラインでのデプロイが必要な場合は、セルフホストしてください。Apache 2.0 ライセンスのコアは、Roboflow のホスト型 API も支えています。

セルフホスト型の推論ではクレジットを使用しません。自分のハードウェアで実行する画像および動画ストリームは無料であり、［Credit Usage］ページではそのメーターが請求なしのレガシーとして表示されます。

一部のモデルには制限的なライセンスが適用されています（例: YOLO11 と YOLO26 は AGPL-3.0、RF-DETR XL と 2XL は PML 1.0 を使用しています）。Roboflow クラウドでこれらをデプロイする場合、すべてのユーザーに商用ライセンスが含まれますが、商用のセルフホスティングには Enterprise ライセンスのアドオンが必要です。Apache 2.0 の RF-DETR モデル（XL および 2XL の検出モデルを除くすべてのサイズ）は、商用でセルフホストするための追加ライセンスを必要としません。参照: [モデルライセンス](https://docs.roboflow.com/models/model-licenses).

{% hint style="info" %}
セルフホスティングでは、インフラストラクチャを自分で管理します。Roboflow にサーバーを運用してもらいたい場合は、 [専用デプロイメント](/deployment/ja/roboflow-cloud/dedicated-deployments.md) または [サーバーレス Cloud API](/deployment/ja/roboflow-cloud/serverless-api.md)、および完全な [オプションの比較](/deployment/ja/choosing-a-deployment.md).
{% endhint %}

## パスを選択

独自のハードウェアでモデルを実行する方法は 3 つあります。ほとんどのプロジェクトでは Inference Server を使用します。

<table data-view="cards" data-search="false"><thead><tr><th></th><th></th><th data-hidden data-card-cover data-type="image">カバー画像</th><th data-hidden data-card-target data-type="content-ref"></th></tr></thead><tbody><tr><td><strong>Inference Server</strong></td><td>HTTP 経由でモデルとワークフローを提供する Docker コンテナです。</td><td><a href="https://970637113-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FoksNmwps1HmYr8TqHDnX%2Fuploads%2Fgit-blob-0882029be46bf9b5f51ed63153561ef9b1601c81%2Fimg-card-selfhosted-server.svg?alt=media">img-card-selfhosted-server.svg</a></td><td><a href="/deployment/ja/self-hosted/inference-server.md">Inference Server</a></td></tr><tr><td><strong>Inference Library</strong></td><td>この <code>inference</code> プロセス内でモデルを実行するための Python パッケージです。</td><td><a href="https://970637113-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FoksNmwps1HmYr8TqHDnX%2Fuploads%2Fgit-blob-ad7692de6027c75ce46a265215e508f4fa769512%2Fimg-card-selfhosted-library.svg?alt=media">img-card-selfhosted-library.svg</a></td><td><a href="/deployment/ja/self-hosted/inference-library.md">Inference ライブラリ</a></td></tr><tr><td><strong>その他の SDK</strong></td><td>Web ブラウザ、iOS、または組み込みデバイス上でモデルを実行します。</td><td><a href="https://970637113-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FoksNmwps1HmYr8TqHDnX%2Fuploads%2Fgit-blob-1acbee3acb1b452e7e4c1a82cf4186704a455d88%2Fimg-card-sdks-more.svg?alt=media">img-card-sdks-more.svg</a></td><td><a href="/deployment/ja/self-hosted/sdks.md">その他の SDK</a></td></tr></tbody></table>

複数のクライアントまたは言語で予測が必要な場合、アプリケーションの依存関係からモデルを分離したい場合、またはエッジデバイスにデプロイする場合は、サーバーを使用してください。

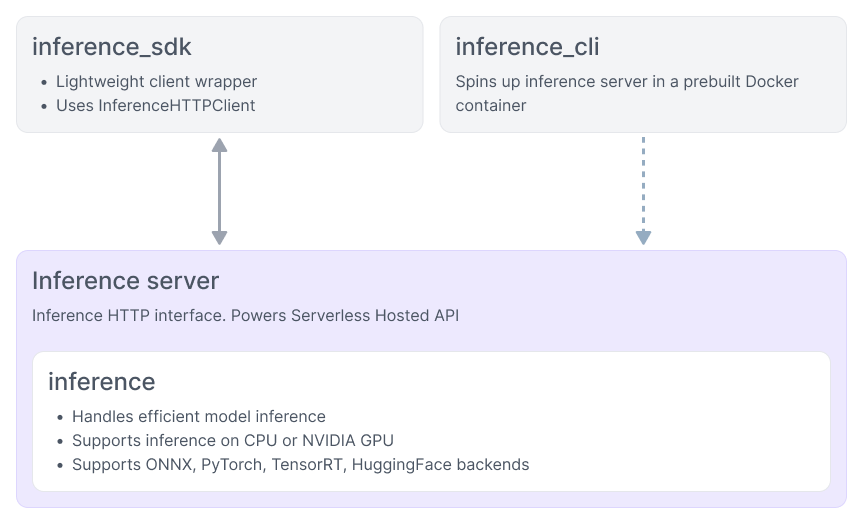
<figure><img src="https://970637113-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FoksNmwps1HmYr8TqHDnX%2Fuploads%2Fgit-blob-9c74d4545aec14d51322649264d3a34526a3cc24%2Fimg-inference-diagram-v1.png?alt=media" alt="Roboflow Inference architecture diagram"><figcaption><p>Inference がアプリケーション、モデル、Roboflow プラットフォームの間に位置する場所</p></figcaption></figure>

## モデルをローカルで実行

ほとんどのプロジェクトでは、Inference Server を Docker で実行し、以下を使用してリクエストを送信します: `inference-sdk`。SDK は、アプリケーションを Inference Server に接続する Python HTTP クライアントです。Python プロセス内で直接モデルを読み込んで実行する必要がある場合は、Inference Library を使用します。どちらの方法でも同じ `model_id` 値を受け付けるため、後から切り替えることができます。

### モデル ID

この `model_id` パラメータには次を指定できます:

* 1 つの [事前学習済みモデルのエイリアス](/models/ja/pretrained-aliases.md)、たとえば `rfdetr-small` または `rfdetr-large`
* 独自の [Roboflow でファインチューニングしたモデル](https://app.gitbook.com/s/wdr4k0gUcsVnXVoafYcQ/train/model-ids)、たとえば `my-project/1`
* 1 つの [Universe モデル](https://docs.roboflow.com/datasets/universe/universe/find-a-model-on-universe)、たとえば `soccer-players-xy9vk/2`

ファインチューニング済みモデルと Universe モデルには、次が必要です: [API キー](https://docs.roboflow.com/reference/authentication/authentication/find-your-roboflow-api-key).

{% tabs %}
{% tab title="Inference Server" icon="docker" %}

### インストール

以下を使用してサーバーを起動します: [Inference CLI](https://docs.roboflow.com/reference/inference/inference-cli)。ハードウェアを検出し、安全なデフォルト設定で適切な Docker イメージを取得します:

```bash
pip install inference-cli && inference server start
```

次に、HTTP クライアントをインストールします:

```bash
pip install inference-sdk
```

ハードウェア要件、デバイスごとのガイド、および手動の `docker run` コマンドについては、以下を参照してください: [Inference Server のインストール](/deployment/ja/self-hosted/inference-server/install.md)。同じクライアントは以下に対しても動作します: [サーバーレス Cloud API](/deployment/ja/roboflow-cloud/serverless-api.md) および [専用デプロイメント](/deployment/ja/roboflow-cloud/dedicated-deployments.md): 変更が必要なのは `api_url` のみです。

### 推論を実行

```python
from inference_sdk import InferenceHTTPClient, InferenceConfiguration

image = "https://media.roboflow.com/inference/people-walking.jpg"
client = InferenceHTTPClient(
    api_url="http://localhost:9001",  # セルフホスト型サーバー
    api_key="YOUR_API_KEY",
).configure(InferenceConfiguration(api_key_transport="header"))
results = client.infer(image, model_id="rfdetr-small")
```

この `api_key_transport="header"` 設定では、キーは次のものとしてのみ送信されます: `Authorization: Bearer` ヘッダーに含めるため、URL やログにキーが残りません。リリース 1.5.0 以降の inference server が必要です。古いサーバーを呼び出す場合は、次を使用してください: `api_key_transport="both"` 。参照: [API キーの転送](https://docs.roboflow.com/reference/inference/inference-sdk/configuration#api-key-transport).

置き換え `api_url` を次のものに `https://serverless.roboflow.com` 以下を使用するには [サーバーレス Cloud API](/deployment/ja/roboflow-cloud/serverless-api.md) に置き換えてください。ほかのコード変更は不要です。詳細は、 [Inference SDK リファレンス](https://docs.roboflow.com/reference/inference/inference-sdk) を参照してください。

### 結果を可視化

インストール [Supervision](https://supervision.roboflow.com):

```bash
pip install -U supervision
```

```python
import supervision as sv
from inference_sdk import InferenceHTTPClient, InferenceConfiguration

image = sv.load_image_from_url("https://media.roboflow.com/inference/people-walking.jpg")

client = InferenceHTTPClient(
    api_url="http://localhost:9001",
    api_key="YOUR_API_KEY",
).configure(InferenceConfiguration(api_key_transport="header"))
results = client.infer(image, model_id="rfdetr-medium")

detections = sv.Detections.from_inference(results)

annotated_image = sv.BoxAnnotator().annotate(scene=image, detections=detections)
annotated_image = sv.LabelAnnotator().annotate(scene=annotated_image, detections=detections)

sv.plot_image(annotated_image)
```

{% endtab %}

{% tab title="Inference Library" icon="python" %}

### インストール

次のものをインストールします: `inference` パッケージを独自の Python 環境に:

```bash
pip install inference
```

NVIDIA GPU を使用している場合は、 `inference-gpu` を代わりにインストールし、インデックス URL を OS にインストールされている CUDA バージョンに合わせてください:

```bash
pip install --extra-index-url https://download.pytorch.org/whl/cu124 inference-gpu
```

参照: [Inference Library](/deployment/ja/self-hosted/inference-library.md) バックエンドの追加機能と GPU セットアップの詳細については、こちらを参照してください。

### 推論を実行

```python
from inference import get_model

image = "https://media.roboflow.com/inference/people-walking.jpg"
model = get_model(model_id="rfdetr-small")
results = model.infer(image)
```

`get_model()` は、初回使用時にモデルの重みをダウンロードしてキャッシュし、その後ローカルで推論を実行します。以下を参照してください: [Inference Python パッケージのリファレンス](https://docs.roboflow.com/reference/inference/inference-python) を参照してください。

### 結果を可視化

インストール [Supervision](https://supervision.roboflow.com):

```bash
pip install -U supervision
```

```python
import supervision as sv
from inference import get_model

image = sv.load_image_from_url("https://media.roboflow.com/inference/people-walking.jpg")

model = get_model(model_id="rfdetr-medium")
results = model.infer(image)[0]

detections = sv.Detections.from_inference(results)

annotated_image = sv.BoxAnnotator().annotate(scene=image, detections=detections)
annotated_image = sv.LabelAnnotator().annotate(scene=annotated_image, detections=detections)

sv.plot_image(annotated_image)
```

{% endtab %}
{% endtabs %}

![検出結果で注釈付けされた歩行者](https://storage.googleapis.com/com-roboflow-marketing/inference/people-walking-annotated.jpg)

{% hint style="warning" %}
API キーを外部ユーザーに公開しないよう注意してください。公開フロントエンドアプリに埋め込まず、代わりに独自のバックエンド経由でリクエストをプロキシしてください。
{% endhint %}

次のものを実行できます: [ワークフロー](https://docs.roboflow.com/workflows) も同じ方法で、サーバー上または独自のプロセス内で実行できます。以下を参照してください: [ワークフローをデプロイ](https://docs.roboflow.com/workflows/deploy/deploy-a-workflow).

{% hint style="info" %}
プライベートモデル向けの TensorRT 最適化モデルパッケージは、Roboflow プラットフォーム外で Inference を実行する場合、以下でのみ利用できます: [Enterprise プラン](/deployment/ja/self-hosted/enterprise.md) パブリックモデルには、すべてのプランで TensorRT パッケージが含まれます。
{% endhint %}
