> For the complete documentation index, see [llms.txt](https://docs.roboflow.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.roboflow.com/get-started/hi/guides/run-a-model-locally.md).
# स्थानीय रूप से मॉडल चलाएँ
Docker inference server के साथ अपने स्वयं के hardware पर Roboflow models चलाएँ, पाँच मिनट में।
[Roboflow Inference](https://docs.roboflow.com/deployment/self-hosted/self-hosted) Roboflow के होस्ट किए गए मॉडलों के पीछे का मुफ़्त, ओपन-सोर्स इंजन है। आप वही मॉडल अपने कंप्यूटर पर चला सकते हैं: Docker कंटेनर में inference server शुरू करें, फिर HTTP या Python के माध्यम से इसे इमेज भेजें [Inference SDK](https://docs.roboflow.com/reference/inference/inference-sdk). इसे स्वयं चलाने से आपकी इमेज आपके अपने मशीन पर ही रहती हैं और आपको अपने सेटअप पर पूरा नियंत्रण मिलता है। लोकल inference क्रेडिट्स का उपयोग नहीं करता।
## अपने मशीन पर एक मॉडल चलाएँ
{% tabs %}
{% tab title="HTTP (Python)" icon="webhook" %}
{% stepper %}
{% step %}
### Inference server शुरू करें
`inference server start` चालू करता है [Inference Server](https://docs.roboflow.com/deployment/self-hosted/inference-server) Docker कंटेनर में और आपके हार्डवेयर के लिए सही संस्करण चुनता है: CPU, NVIDIA GPU, या Jetson. [Docker](https://docs.docker.com/get-docker/) स्थापित और चल रहा होना चाहिए।
```bash
pip install inference-cli && inference server start
```
सर्वर इस पर सुनता है `http://localhost:9001`. डिवाइस-विशिष्ट सेटअप और समस्या-समाधान के लिए देखें [Inference इंस्टॉल गाइड](https://docs.roboflow.com/deployment/self-hosted/inference-server/install).
{% endstep %}
{% step %}
### डिपेंडेंसियाँ इंस्टॉल करें
`supervision` परिणामों को ड्रॉ करता है और शामिल करता है `cv2` और `numpy`:
```bash
pip install -U supervision
```
{% endstep %}
{% step %}
### मॉडल चलाएँ
इमेज को अपने लोकल सर्वर पर भेजें और एक तैयार-निर्मित [RF-DETR](https://docs.roboflow.com/models/supported-models/rf-detr) मॉडल चलाएँ। RF-DETR Apache 2.0 है, इसलिए आप इसे बिना किसी लाइसेंस शुल्क के व्यावसायिक उत्पाद में self-host कर सकते हैं। इस तरह के तैयार-निर्मित मॉडल को API key की आवश्यकता नहीं होती:
```python
import base64
import cv2
import requests
import supervision as sv
image = sv.load_image_from_url("https://media.roboflow.com/quickstart/cars.jpg")
image_b64 = base64.b64encode(content).decode("utf-8")
result = requests.post(
"http://localhost:9001/coco/38", # coco/38 == rfdetr-nano
data=image_b64, # body में raw base64
headers={"Content-Type": "application/x-www-form-urlencoded"},
).json()
detections = sv.Detections.from_inference(result)
print(f"Found {len(detections)} objects")
annotated = sv.BoxAnnotator().annotate(image.copy(), detections)
annotated = sv.LabelAnnotator().annotate(annotated, detections)
cv2.imwrite("output.jpg", annotated)
```
{% endstep %}
{% endstepper %}
{% endtab %}
{% tab title="SDK (Python)" icon="python" %}
{% stepper %}
{% step %}
### Inference server शुरू करें
`inference server start` चालू करता है [Inference Server](https://docs.roboflow.com/deployment/self-hosted/inference-server) Docker कंटेनर में और आपके हार्डवेयर के लिए सही संस्करण चुनता है: CPU, NVIDIA GPU, या Jetson. [Docker](https://docs.docker.com/get-docker/) स्थापित और चल रहा होना चाहिए।
```bash
pip install inference-cli && inference server start
```
सर्वर इस पर सुनता है `http://localhost:9001`. डिवाइस-विशिष्ट सेटअप और समस्या-समाधान के लिए देखें [Inference इंस्टॉल गाइड](https://docs.roboflow.com/deployment/self-hosted/inference-server/install).
{% endstep %}
{% step %}
### SDK इंस्टॉल करें
`supervision` परिणामों को ड्रॉ करता है और शामिल करता है `cv2` और `numpy`:
```bash
pip install -U inference-sdk supervision
```
{% endstep %}
{% step %}
### मॉडल चलाएँ
क्लाइंट को अपने लोकल सर्वर की ओर इंगित करें और एक तैयार-निर्मित [RF-DETR](https://docs.roboflow.com/models/supported-models/rf-detr) मॉडल चलाएँ। RF-DETR Apache 2.0 है, इसलिए आप इसे बिना किसी लाइसेंस शुल्क के व्यावसायिक उत्पाद में self-host कर सकते हैं। इस तरह के तैयार-निर्मित मॉडल को API key की आवश्यकता नहीं होती:
```python
import cv2
import supervision as sv
from inference_sdk import InferenceHTTPClient
image = sv.load_image_from_url("https://media.roboflow.com/quickstart/cars.jpg")
client = InferenceHTTPClient(api_url="http://localhost:9001")
result = client.infer(image, model_id="rfdetr-nano")
detections = sv.Detections.from_inference(result)
print(f"Found {len(detections)} objects")
annotated = sv.BoxAnnotator().annotate(image.copy(), detections)
annotated = sv.LabelAnnotator().annotate(annotated, detections)
cv2.imwrite("output.jpg", annotated)
```
{% endstep %}
{% endstepper %}
{% endtab %}
{% endtabs %}
पहला अनुरोध मॉडल डाउनलोड करता है, इसलिए इसमें कुछ सेकंड लग सकते हैं। बाद के अनुरोध तेज़ होते हैं।
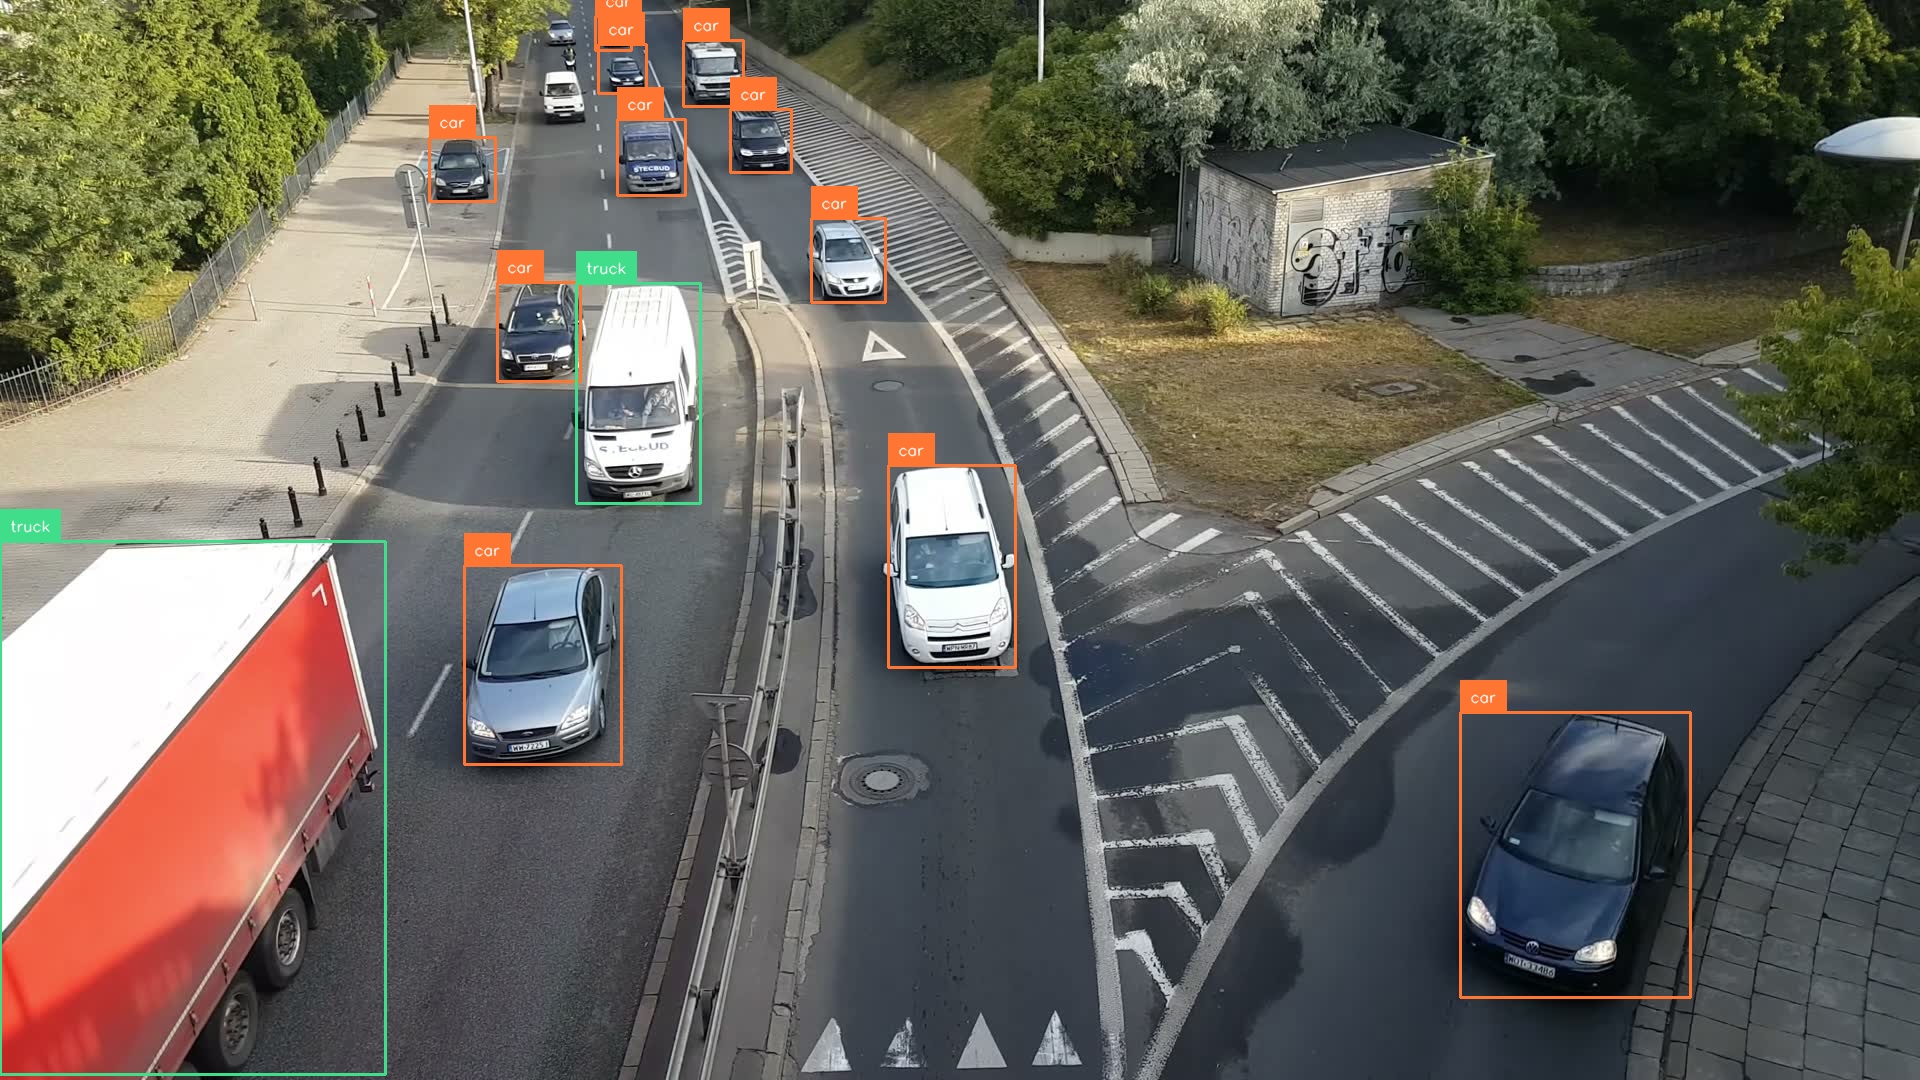
लोकल inference server से RF-DETR detections
## एक वीडियो प्रोसेस करें
वीडियो पर मॉडल चलाने के लिए, सर्वर के साथ एक WebRTC session खोलें और वीडियो चलते समय प्रोसेस किए गए frames के साथ predictions प्राप्त करें। यदि आपका कंप्यूटर साथ नहीं दे पाता, तो server real time बनाए रखने के लिए frames छोड़ देता है। वही SDK एक मॉडल या एक [Workflow](https://docs.roboflow.com/workflows).
{% hint style="info" %}
आप ऊपर दिए गए image example की तरह, एक-एक frame भेजकर HTTP पर भी वीडियो पर मॉडल चला सकते हैं (किसी streaming add-on की आवश्यकता नहीं है)। यह धीमा है: हर frame को भेजना, प्रोसेस करना, और draw करना होता है, उससे पहले कि अगला शुरू हो, इसलिए बीच में बहुत इंतज़ार होता है। SDK पूरे वीडियो को stream करता है और कई frames पर एक साथ काम करता है, इसलिए यह कहीं बेहतर तरीके से साथ निभाता है।
{% endhint %}
{% stepper %}
{% step %}
### SDK इंस्टॉल करें
वीडियो streaming के लिए आवश्यक है `webrtc` add-on:
```bash
pip install "inference-sdk[webrtc]"
```
{% endstep %}
{% step %}
### वीडियो पर मॉडल चलाएँ
```python
import cv2
from inference_sdk import InferenceHTTPClient
from inference_sdk.webrtc import VideoFileSource
import supervision as sv
client = InferenceHTTPClient.init(api_url="http://localhost:9001")
# वीडियो डाउनलोड+कैश करें
source = VideoFileSource("https://media.roboflow.com/quickstart/cars.mp4")
# अनुकूलित वीडियो streaming के लिए webrtc का उपयोग करता है
session = client.webrtc.stream(
source=source,
model_id="rfdetr-nano"
)
# on_frame मुख्य थ्रेड पर चलता है, इसलिए cv2.imshow सुरक्षित है
@session.on_frame
def show(frame, data):
det = sv.Detections.from_inference(data)
img = sv.BoxAnnotator().annotate(frame, det)
img = sv.LabelAnnotator().annotate(img, det)
cv2.imshow("RF-DETR", img)
if cv2.waitKey(1) == ord("q"):
session.close()
session.run()
cv2.destroyAllWindows()
```
{% endstep %}
{% endstepper %}
{% embed url="" %}
Workflows editor में दृश्य रूप से और समृद्ध pipelines (tracking, filtering, zones, notifications) बनाएँ [Workflows editor](https://docs.roboflow.com/workflows/build/create-a-workflow)फिर उन्हें उसी WebRTC client के माध्यम से चलाएँ। देखें [Workflows के साथ वीडियो प्रोसेसिंग](https://docs.roboflow.com/workflows/deploy/video-processing).
## अन्य विकल्प
* हार्डवेयर चलाए बिना managed endpoint चाहिए? उपयोग करें [Dedicated Deployment](https://docs.roboflow.com/deployment/roboflow-cloud/dedicated-deployments) या [Serverless Cloud API](https://docs.roboflow.com/deployment/roboflow-cloud/serverless-api).
* On-premises, air-gapped, या Kubernetes deployment चाहिए? देखें [Enterprise Deployment](https://docs.roboflow.com/deployment/self-hosted/enterprise).
* में हर विकल्प की तुलना करें [एक Model या Workflow Deploy करें](https://docs.roboflow.com/deployment).