> For the complete documentation index, see [llms.txt](https://docs.roboflow.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.roboflow.com/models/hi/evaluate/evaluate-trained-models.md).

# प्रशिक्षित मॉडलों का मूल्यांकन करें

यह जानने के लिए Model Evaluation का उपयोग करें कि आपका मॉडल आपके टेस्ट डेटासेट पर कैसा प्रदर्शन करता है।

## के बारे में

मॉडल मूल्यांकन दिखाते हैं:

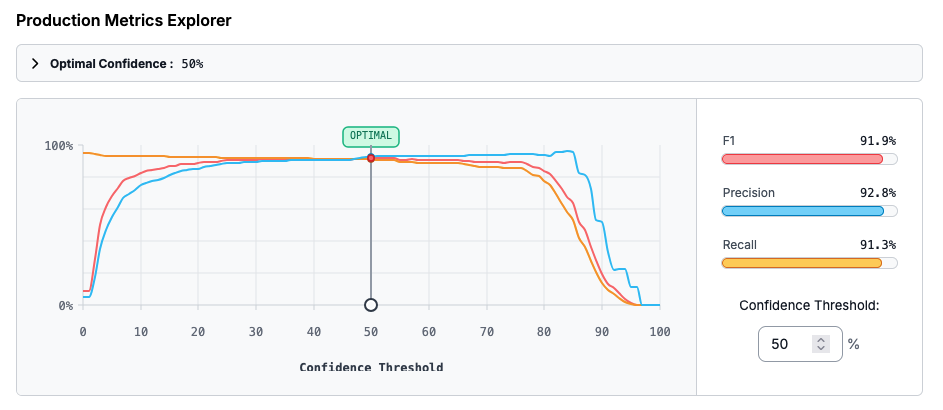
1. एक प्रोडक्शन मेट्रिक्स एक्सप्लोरर, जो आपको वह सर्वोत्तम कॉन्फिडेंस थ्रेशोल्ड खोजने में मदद करता है जिस पर आप अपना मॉडल चला सकें;
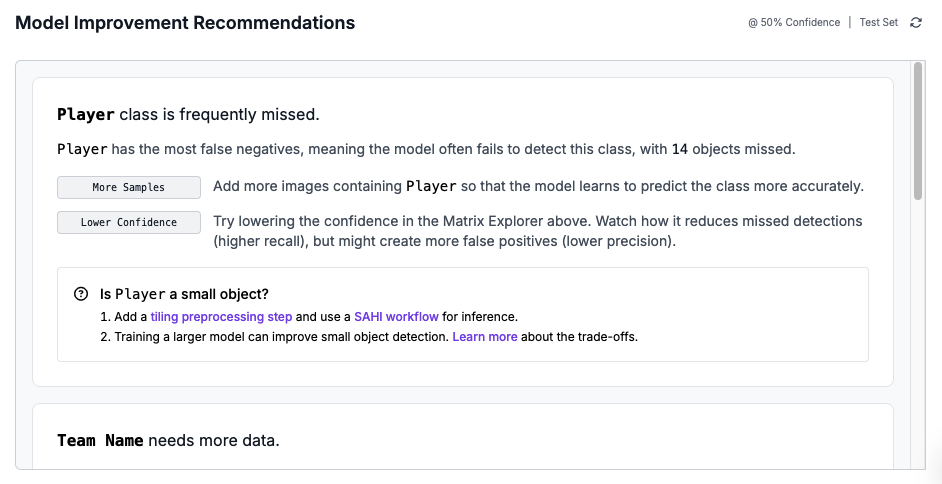
2. मॉडल सुधार अनुशंसाएँ, जो आपके मॉडल की सटीकता बढ़ाने के लिए सुझाव देती हैं;
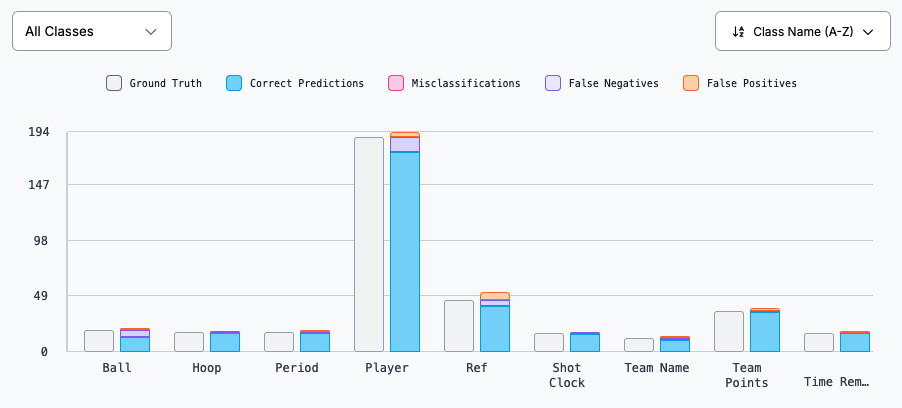
3. क्लास के अनुसार प्रदर्शन, जो दिखाता है कि आपका मॉडल विभिन्न क्लासों की पहचान कितनी अच्छी तरह करता है;
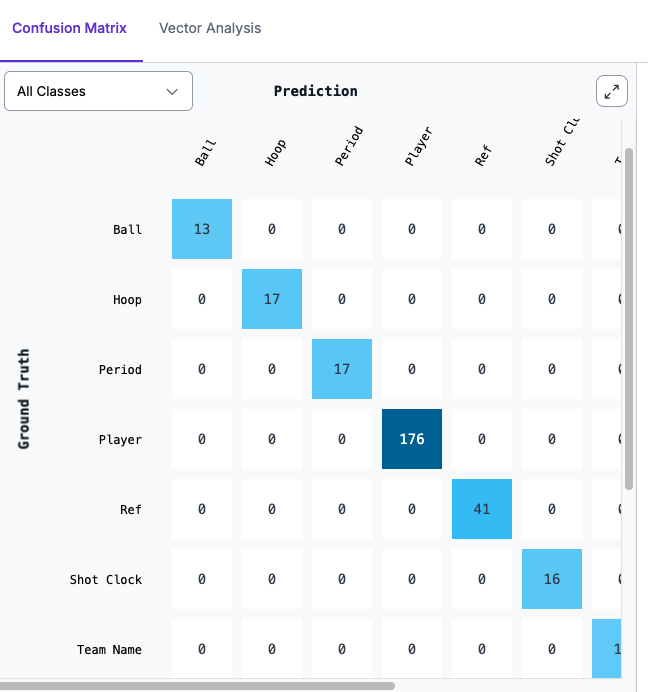
4. एक कन्फ्यूजन मैट्रिक्स, जिसका उपयोग आप उन विशिष्ट क्लासों को खोजने के लिए कर सकते हैं जिनमें आपका मॉडल अच्छा करता है और जिनमें उसे कठिनाई होती है, और;
5. एक इंटरैक्टिव वेक्टर एक्सप्लोरर, जो आपको उन इमेजों के क्लस्टर पहचानने देता है जहाँ आपका मॉडल अच्छा या खराब प्रदर्शन करता है;

आप अपने मॉडल के सुधार के क्षेत्रों की पहचान करने के लिए मॉडल मूल्यांकन का उपयोग कर सकते हैं।

पेड उपयोगकर्ताओं द्वारा Roboflow पर प्रशिक्षित किए गए या अपलोड किए गए सभी वर्ज़नयुक्त मॉडलों के लिए मॉडल मूल्यांकन स्वचालित रूप से चलाए जाते हैं। कुछ सौ इमेजों वाले डेटासेट के लिए मूल्यांकन चलने में कई मिनट लग सकते हैं, और हज़ारों या उससे अधिक इमेजों वाले बड़े डेटासेट के लिए कई घंटे लग सकते हैं।

कन्फ्यूजन मैट्रिक्स आपके प्रशिक्षित मॉडल को आपके टेस्ट और वैलिडेशन सेट की इमेजों पर चलाता है और उसकी भविष्यवाणियों की आपके एनोटेशनों (ग्राउंड ट्रुथ) से तुलना करता है। यह सही भविष्यवाणियाँ, फॉल्स पॉज़िटिव (गलत क्लास, या ऐसा ऑब्जेक्ट जो मौजूद नहीं है), और फॉल्स नेगेटिव दिखाता है। अनुशंसाएँ इसी पर आधारित होती हैं। इनमें वे मॉडल शामिल हैं जिनमें बहुत अधिक फॉल्स नेगेटिव या फॉल्स पॉज़िटिव होते हैं, वे क्लासें जो अक्सर भ्रमित होती हैं, वे क्लासें जिन्हें अधिक डेटा की आवश्यकता होती है, और ऐसे टेस्ट या वैलिडेशन सेट जो बहुत छोटे हो सकते हैं।

### उत्तम कॉन्फिडेंस

प्रोडक्शन मेट्रिक्स एक्सप्लोरर हर कॉन्फिडेंस थ्रेशोल्ड पर प्रिसिजन, रिकॉल, और F1 की गणना करता है और एक सर्वोत्तम कॉन्फिडेंस की अनुशंसा करता है: वह थ्रेशोल्ड जिसमें सबसे अच्छा संतुलन हो। मूल्यांकन पूरा होने के बाद, वही थ्रेशोल्ड आपके मॉडल के इन्फ़रेंस अनुरोधों के लिए डिफ़ॉल्ट बन जाता है। यदि प्रति-क्लास थ्रेशोल्ड उपलब्ध हों, तो वे भी लागू होते हैं, और किसी भी ऐसी क्लास के लिए जिसका अपना मान नहीं है, वैश्विक थ्रेशोल्ड फ़ॉलबैक के रूप में उपयोग होता है। किसी अनुरोध पर इसे ओवरराइड करने के लिए, `confidence` पैरामीटर पास करें।

### मध्यिका विलंबता

मूल्यांकन उस औसत समय को दिखाता है जो Serverless Cloud API को एक अनुरोध का उत्तर देने में लगता है, जिसे आपकी टेस्ट इमेजों पर मापा गया है। इस मान में प्रीप्रोसेसिंग और पोस्टप्रोसेसिंग समय शामिल है। इसमें नेटवर्क समय शामिल नहीं है। आपकी मॉडल सूचियाँ और मॉडल कार्ड्स वही मान "Latency (Cloud API)" के रूप में दिखाते हैं। एक से प्राप्त विलंबता [न्यूरल आर्किटेक्चर सर्च](https://docs.roboflow.com/models/hi/train/neural-architecture-search.md) बेंचमार्क को अलग तरीके से मापा जाता है, इसलिए दोनों की तुलना न करें।

यदि आपकी टेस्ट इमेजों में मॉडल इनपुट से कम से कम दोगुने पिक्सल हैं, तो मूल्यांकन कैप्चर रिज़ॉल्यूशन के बारे में एक अनुशंसा जोड़ता है। सर्वर मॉडल चलाने से पहले हर इमेज को डिकोड और रिसाइज़ करता है, इसलिए जिन फ्रेम्स की लंबी साइड मॉडल इनपुट के करीब होती है वे तेज़ी से उत्तर देते हैं।

का उपयोग करें [मॉडल तुलना](https://docs.roboflow.com/models/hi/evaluate/compare-trained-models.md) एक ही Dataset Version पर मॉडलों के लिए टेस्ट-सेट सटीकता और विलंबता की तुलना करने के लिए।

### इन्फ़रेंस के लिए ऑप्टिमाइज़ करना

प्रशिक्षण के बाद, Roboflow आपके मॉडल को उस पैकेज में कंपाइल करता है जिसे Serverless Cloud API सर्व करता है। यह चलने के दौरान मॉडल "इन्फ़रेंस के लिए ऑप्टिमाइज़ हो रहा है" दिखाता है, और मूल्यांकन इसके समाप्त होने का इंतज़ार करता है। इस तरह मूल्यांकन उसी पैकेज को मापता है जो आपके इन्फ़रेंस अनुरोधों को सर्व करता है। कंपाइल करने में आमतौर पर कुछ मिनट अतिरिक्त लगते हैं। यदि यह विफल हो जाता है, या 24 घंटे से अधिक समय लेता है, तो मूल्यांकन फिर भी शुरू हो जाता है।

### समर्थित प्रोजेक्ट प्रकार

मॉडल मूल्यांकन Object Detection, Instance Segmentation, Keypoint Detection, Classification, और Semantic Segmentation प्रोजेक्ट्स का समर्थन करता है।

Keypoint Detection के लिए, mAP पूर्वानुमानित keypoints को लेबल किए गए keypoints से मिलाने के लिए Object Keypoint Similarity (OKS) का उपयोग करता है। मूल्यांकन इमेज व्यूअर अनुमानित keypoints दिखाता है, लेकिन लेबल किए गए keypoints नहीं।

Semantic Segmentation के लिए, मुख्य मेट्रिक mAP के बजाय mIoU (mean Intersection-over-Union) है। सभी मेट्रिक्स (precision, recall, F1) प्रति-इंस्टेंस के बजाय पिक्सेल स्तर पर गणना किए जाते हैं। प्रति-क्लास विवरण प्रत्येक क्लास के लिए IoU, precision, recall, F1, और एक सर्वोत्तम कॉन्फिडेंस थ्रेशोल्ड दिखाता है। कन्फ्यूजन मैट्रिक्स मान ऑब्जेक्ट गिनती के बजाय पिक्सेल गिनती दर्शाते हैं।

सेगमेंटेशन मॉडलों के नए मूल्यांकन boundary metrics भी रिपोर्ट करते हैं। Boundary IoU हर मास्क किनारे के साथ संकरी पट्टियों की तुलना करता है, इसलिए यह किनारे की त्रुटियाँ दिखाता है जिन्हें mask IoU छिपा सकता है। Instance Segmentation "Show Detailed Metrics" के अंतर्गत "Mean Boundary Average Precision" चार्ट दिखाता है। Semantic Segmentation mIoU के साथ mBIoU दिखाता है, और प्रति-क्लास तालिका में "Boundary IoU" कॉलम होता है।

## वेब ऐप

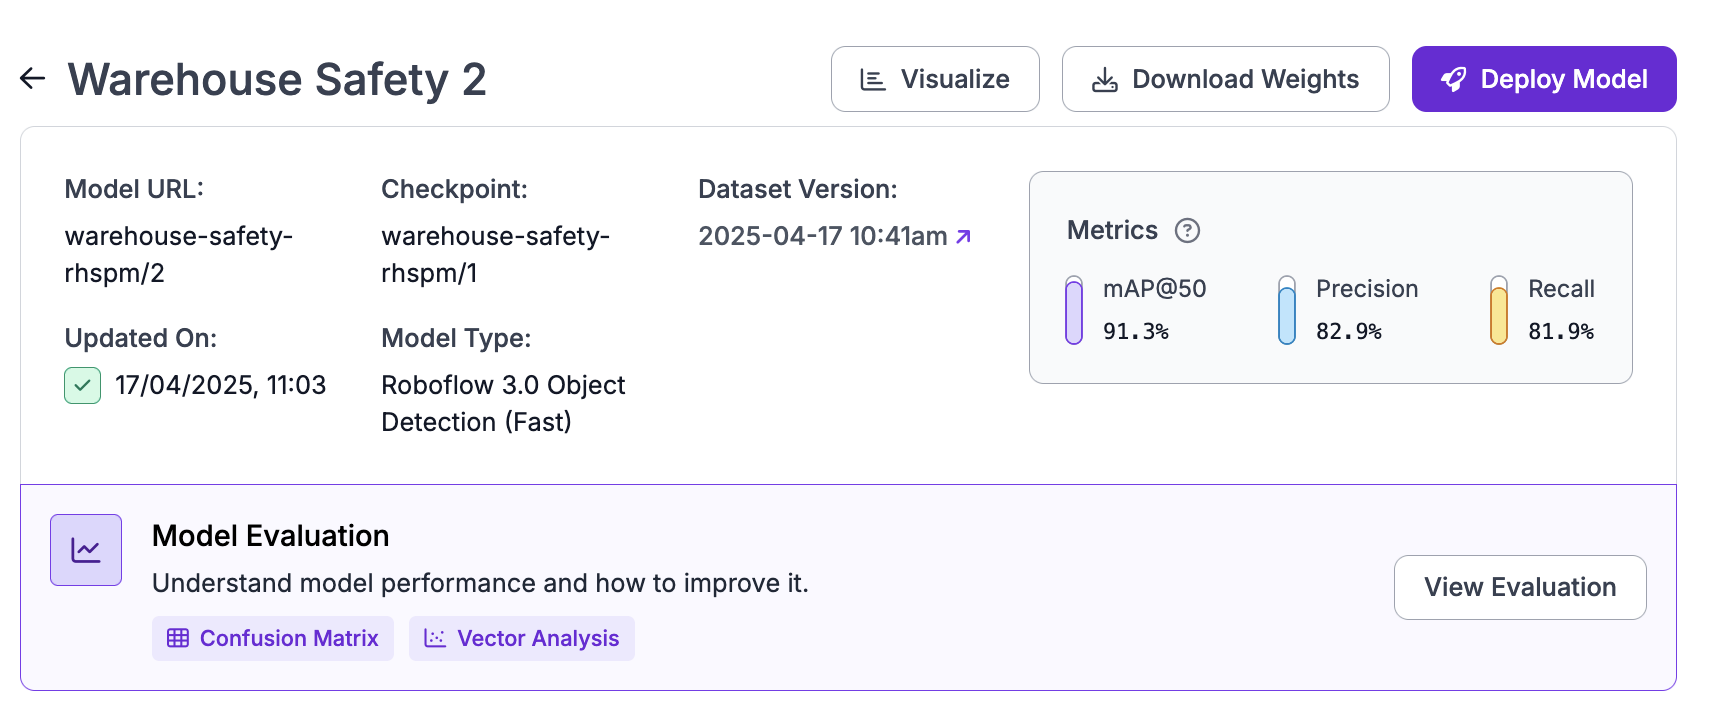
अपने प्रोजेक्ट में "Models" खोलें, एक प्रशिक्षित मॉडल चुनें, और "View Full Model Evaluation" पर क्लिक करें।

<figure><img src="https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-8c6db60420e1905df8d6f3c824f91f0f219e8a76%2FScreenshot%202025-05-14%20at%2014.41.23.png?alt=media" alt=""><figcaption></figcaption></figure>

प्रोडक्शन मेट्रिक्स एक्सप्लोरर में, किसी भी कॉन्फिडेंस थ्रेशोल्ड पर precision, recall, और F1 देखने के लिए स्लाइडर खींचें।

<figure><img src="https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-cf7be3e1155f28ab47c87709fe072e767b536898%2FScreenshot%202025-07-23%20at%2011.15.02.png?alt=media" alt=""><figcaption></figcaption></figure>

मॉडल सुधार अनुशंसाएँ बताती हैं कि सटीकता बढ़ाने के लिए क्या बदलना है।

<figure><img src="https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-cb54b251f5e115f9a1eb549b0c03117d5b263b3b%2FScreenshot%202025-07-23%20at%2011.17.09.png?alt=media" alt=""><figcaption></figcaption></figure>

प्रदर्शन बाय क्लास चार्ट हर क्लास के लिए सही भविष्यवाणियाँ, गलत वर्गीकरण, फॉल्स नेगेटिव, और फॉल्स पॉज़िटिव गिनता है। विशिष्ट क्लासों पर ध्यान केंद्रित करने के लिए "All Classes" ड्रॉपडाउन का उपयोग करें।

<figure><img src="https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-ffaf491bbb2d955905c575d90aeb04a4fd94f257%2FScreenshot%202025-07-23%20at%2011.18.34.png?alt=media" alt=""><figcaption></figcaption></figure>

कन्फ्यूजन मैट्रिक्स में, किसी सेल पर क्लिक करके उसमें मौजूद इमेजें देखें (उदा.: "False Positive" कॉलम में एक सेल उन इमेजों को दिखाता है जहाँ मॉडल ने ऐसा ऑब्जेक्ट पाया जो आपके एनोटेशनों में नहीं है)। किसी इमेज पर क्लिक करें, फिर अपने एनोटेशनों की तुलना मॉडल के आउटपुट से करने के लिए "Ground Truth" और "Model Predictions" के बीच स्विच करें।

<figure><img src="https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-cd0af50fa3e0c4158310901798a285245a9d87bc%2FScreenshot%202025-07-23%20at%2011.20.53.png?alt=media" alt=""><figcaption></figcaption></figure>

"Vector Analysis" आपकी टेस्ट इमेजों को दृश्य समानता के आधार पर प्लॉट करता है और प्रत्येक को उसके F1 स्कोर के अनुसार रंग देता है। किसी बिंदु, किसी क्षेत्र, या "Identified Clusters" में से किसी एक पर क्लिक करें ताकि आप वे इमेजें देख सकें, और समान इमेजों के उन समूहों को खोज सकें जहाँ मॉडल संघर्ष करता है।

![स्कैटर प्लॉट पर हाइलाइट किए गए दो इमेजों के चुने गए क्लस्टर के साथ Vector Analysis, जिन्हें सबसे खराब F1 के अनुसार सूचीबद्ध किया गया है](https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-f149c384f7b7dacc4a2816045a6c9e5ab8526dc0%2Fmodel-evaluation-vector-analysis.png?alt=media)

क्लास चार्ट और कन्फ्यूजन मैट्रिक्स सर्वोत्तम कॉन्फिडेंस से शुरू होते हैं। परिणाम, precision, और recall कैसे बदलते हैं यह देखने के लिए उनके "Confidence Threshold" स्लाइडर को हिलाएँ।

"Improve My Model" पर क्लिक करके एक खोलें [Roboflow Agent](https://docs.roboflow.com/agents/roboflow-agent) इस मूल्यांकन के बारे में चैट करें। Agent मॉडल के विफल होने वाली इमेजें उनके लेबल्स के साथ दिखाता है और आपके डेटा या प्रशिक्षण में बदलाव सुझाता है। यह संभावित लेबल त्रुटियों वाली इमेजों को एक समीक्षा जॉब में रखता है, ताकि आप लेबलों की जाँच और सुधार कर सकें। वह आपकी टीममेट की जॉब से इमेजें हटाने से पहले आपसे पूछता है।

## HTTP API

Model Evaluations API वह सब कुछ लौटाती है जो ऐप में evaluation पेज दिखाता है। हर पैनल का अपना endpoint होता है। Roboflow प्रशिक्षण समाप्त होने पर एक evaluation चलाता है, और आप ऐप से उसे फिर से चला सकते हैं। हर endpoint को एक API key की आवश्यकता होती है जिसमें `model-eval:read` स्कोप हो।

से शुरू करें [List Model Evaluations](#list-model-evaluations) ताकि एक खोज सकें `evalId`फिर पोल करें [Get a Model Evaluation](#get-a-model-evaluation) जब तक `status` है `done`. तब तक पैनल endpoints लौटाते हैं `409` । हर पैनल प्रतिक्रिया दोहराती है `evalId`, `project`, `versionId`और `modelId`ताकि आप ऐप में evaluation का लिंक यहाँ दे सकें `https://app.roboflow.com/{workspace}/{project}/evaluation/{versionId}`.

एक वर्ज़न पर कई मॉडलों की तुलना करने के लिए, देखें [Compare Trained Models](https://docs.roboflow.com/models/hi/evaluate/compare-trained-models.md#http-api).

### List Model Evaluations

हर evaluation के लिए metrics के बिना एक संक्षिप्त रिकॉर्ड लौटाता है। इनमें से किसी एक के आधार पर फ़िल्टर करें `project`, `version`या `model`; एक से अधिक भेजने पर लौटता है `400`. किसी evaluation को उसके मॉडल से मिलाने के लिए, तुलना करें `modelId` उस model ID के साथ जिसका उपयोग आप इन्फ़रेंस के लिए करते हैं।

{% openapi src="/files/20f985b4a6ddab66d95b5567a20369abe66a32e0" path="/{workspace}/model-evals" method="get" %}
[model-evaluations.yaml](https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### Get a Model Evaluation

एक evaluation लौटाता है। एक बार `status` है `done`के बाद, प्रतिक्रिया जोड़ती है `summary` मुख्य मेट्रिक्स के साथ: `mAP` डिटेक्शन कार्यों के लिए, `mIoU` सेमांटिक सेगमेंटेशन के लिए।

{% openapi src="/files/20f985b4a6ddab66d95b5567a20369abe66a32e0" path="/{workspace}/model-evals/{evaluationId}" method="get" %}
[model-evaluations.yaml](https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### mAP परिणाम प्राप्त करें

हर split के लिए मुख्य मेट्रिक्स लौटाता है, जैसा कि metrics per split पैनल में दिखाया गया है। पहले `taskType` पढ़ें: यह आपको बताता है कि splits में mAP फ़ील्ड हैं या mIoU और pixel-level फ़ील्ड।

{% openapi src="/files/20f985b4a6ddab66d95b5567a20369abe66a32e0" path="/{workspace}/model-evals/{evaluationId}/map-results" method="get" %}
[model-evaluations.yaml](https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### कॉन्फिडेंस स्वीप प्राप्त करें

प्रोडक्शन मेट्रिक्स एक्सप्लोरर के पीछे की curves लौटाता है: हर confidence threshold पर precision, recall, और F1, तथा सबसे अच्छे F1 वाला threshold। इसका उपयोग उस confidence threshold को चुनने के लिए करें जिसके साथ deploy करना है।

{% openapi src="/files/20f985b4a6ddab66d95b5567a20369abe66a32e0" path="/{workspace}/model-evals/{evaluationId}/confidence-sweep" method="get" %}
[model-evaluations.yaml](https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### क्लास के अनुसार प्रदर्शन प्राप्त करें

एक split के लिए performance by class पैनल लौटाता है। हर class अपने स्वयं के सर्वोत्तम threshold पर precision, recall, और F1 रिपोर्ट करती है।

{% openapi src="/files/20f985b4a6ddab66d95b5567a20369abe66a32e0" path="/{workspace}/model-evals/{evaluationId}/performance-by-class" method="get" %}
[model-evaluations.yaml](https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### एक कन्फ्यूजन मैट्रिक्स प्राप्त करें

कन्फ्यूजन मैट्रिक्स पैनल लौटाता है। हर confidence threshold एक अलग matrix देता है, इसलिए पास करें `confidence` ताकि उस threshold से मेल खाए जिसके साथ आप deploy करते हैं।

{% openapi src="/files/20f985b4a6ddab66d95b5567a20369abe66a32e0" path="/{workspace}/model-evals/{evaluationId}/confusion-matrix" method="get" %}
[model-evaluations.yaml](https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### वेक्टर विश्लेषण प्राप्त करें

वेक्टर विश्लेषण पैनल लौटाता है: दृश्य समानता के आधार पर समूहित इमेजें, प्रत्येक समूह पर मॉडल का औसत F1, precision, और recall के साथ। कम `f1Mean` वाले clusters खोजें ताकि उन प्रकार की इमेजें मिल सकें जहाँ मॉडल संघर्ष करता है। किसी cluster में कौन-सी इमेजें हैं यह देखने के लिए, उपयोग करें [इमेज प्रेडिक्शंस प्राप्त करें](#get-image-predictions).

{% openapi src="/files/20f985b4a6ddab66d95b5567a20369abe66a32e0" path="/{workspace}/model-evals/{evaluationId}/vector-analysis" method="get" %}
[model-evaluations.yaml](https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### इमेज प्रेडिक्शंस प्राप्त करें

मूल्यांकित हर इमेज के लिए एक रिकॉर्ड लौटाता है, जिसमें उसकी गिनती, मेट्रिक्स, क्लस्टर, और कन्फ्यूजन प्रविष्टियाँ शामिल होती हैं। परिणाम पेजिनेट किए जाते हैं `limit` और `offset`.

एक इमेज का निरीक्षण करने के लिए, पास करें `imageName` या `evalInputId` के साथ `includeGeometry=true`. तब रिकॉर्ड में सहेजी गई भविष्यवाणियाँ और ग्राउंड ट्रुथ शामिल होते हैं, ताकि आप बता सकें कि विफलता मॉडल त्रुटि है या लेबल त्रुटि।

{% openapi src="/files/20f985b4a6ddab66d95b5567a20369abe66a32e0" path="/{workspace}/model-evals/{evaluationId}/image-predictions" method="get" %}
[model-evaluations.yaml](https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### अनुशंसाएँ प्राप्त करें

मॉडल सुधार अनुशंसाएँ पैनल लौटाता है। Roboflow प्रशिक्षण समाप्त होने पर अनुशंसाएँ बनाता है, और यह endpoint केवल उन्हें पढ़ता है। अनुशंसाओं के बिना समाप्त हुआ evaluation लौटाता है `200` के साथ `generated: false`लौटाता है, त्रुटि नहीं।

{% openapi src="/files/20f985b4a6ddab66d95b5567a20369abe66a32e0" path="/{workspace}/model-evals/{evaluationId}/recommendations" method="get" %}
[model-evaluations.yaml](https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

## MCP सर्वर

अपने AI एजेंट को [MCP सर्वर](https://docs.roboflow.com/agents/mcp-server) से जोड़ें और वह इन टूल्स के साथ मॉडल के प्रदर्शन की समीक्षा कर सकता है:

<table data-search="false"><thead><tr><th width="290">टूल</th><th>विवरण</th></tr></thead><tbody><tr><td><code>model_evals_list</code></td><td>वर्कस्पेस में मॉडल मूल्यांकन सूचीबद्ध करें।</td></tr><tr><td><code>model_evals_get</code></td><td>एक मूल्यांकन का शीर्ष-स्तरीय सारांश प्राप्त करें।</td></tr><tr><td><code>model_evals_get_map_results</code></td><td>प्रति-split mAP परिणाम प्राप्त करें।</td></tr><tr><td><code>model_evals_get_confusion_matrix</code></td><td>कन्फ्यूजन मैट्रिक्स प्राप्त करें।</td></tr><tr><td><code>model_evals_get_performance_by_class</code></td><td>एक split के लिए प्रति-क्लास प्रदर्शन मेट्रिक्स प्राप्त करें।</td></tr><tr><td><code>model_evals_get_recommendations</code></td><td>यदि उपलब्ध हो, तो मूल्यांकन के लिए उत्पन्न अनुशंसाएँ प्राप्त करें।</td></tr></tbody></table>
