> For the complete documentation index, see [llms.txt](https://docs.roboflow.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.roboflow.com/models/hi/train/neural-architecture-search.md).

# न्यूरल आर्किटेक्चर सर्च

उत्तम मॉडल आर्किटेक्चर की स्वचालित खोज करें और साथ ही अपने मॉडल को फाइन-ट्यून करें।

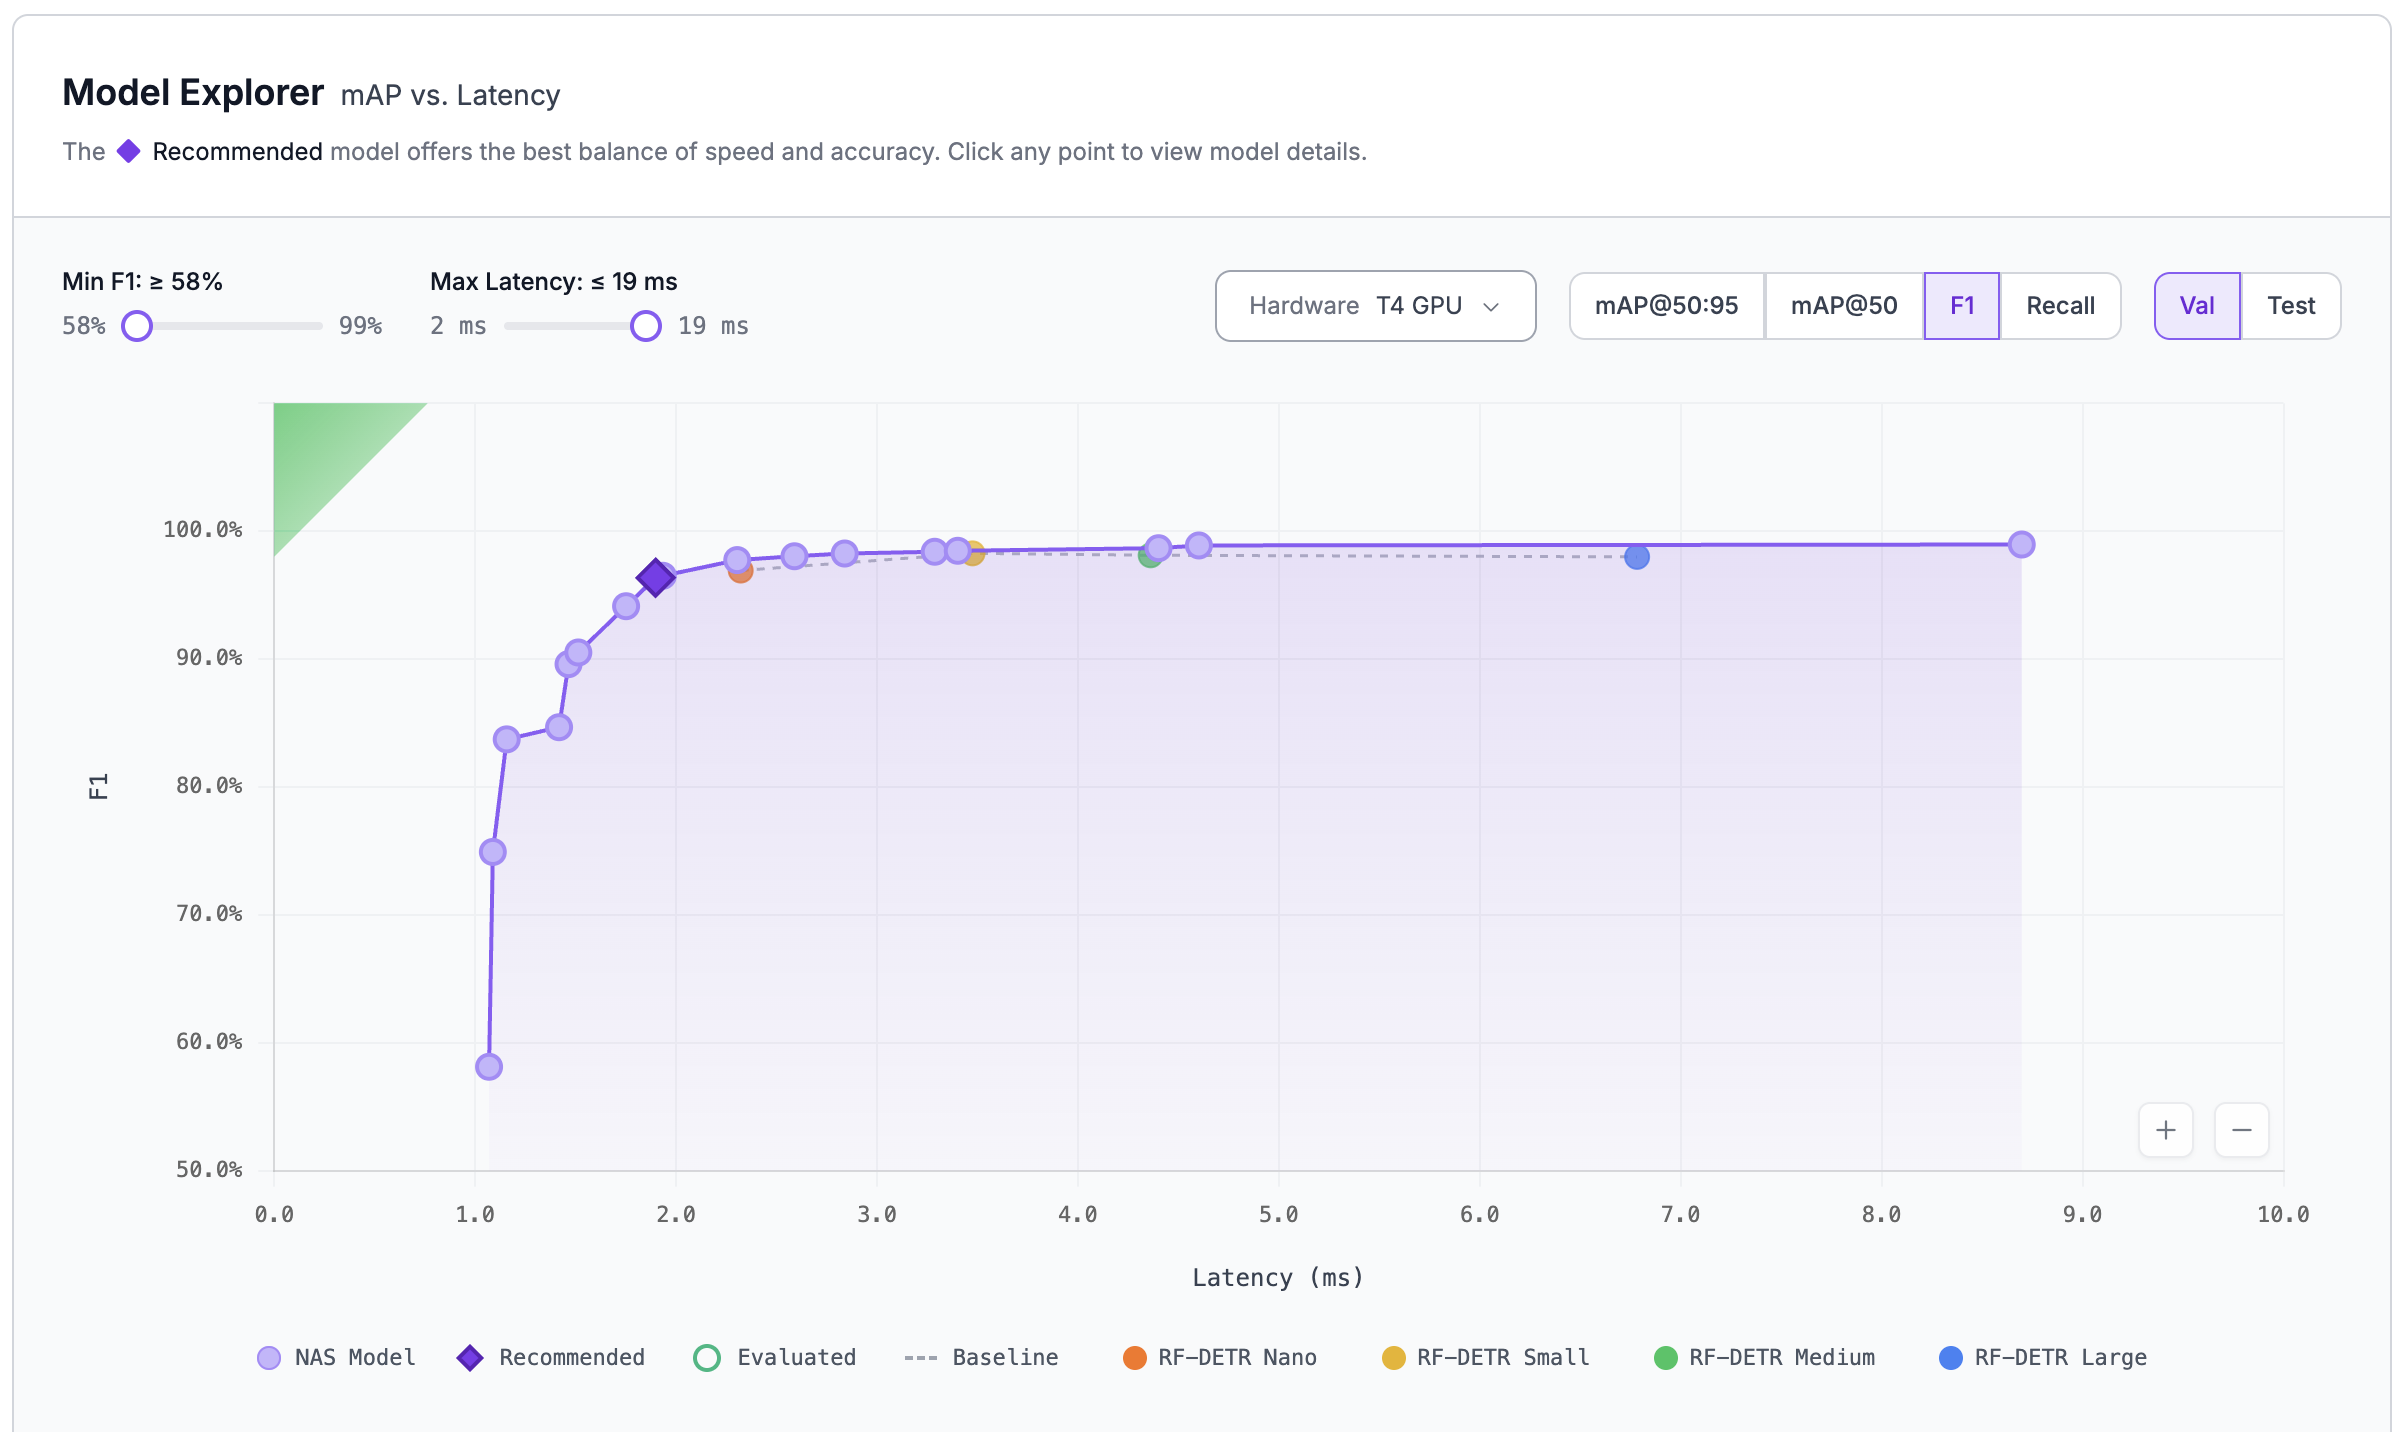
<figure><img src="https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-a09482f629727fe1cfe37ef9c7c0052ee9b40694%2Fnas-mining-curve.png?alt=media" alt="NAS results page showing a Pareto frontier of trained models plotted across latency and accuracy."><figcaption><p>NAS परिणाम पृष्ठ गति-बनाम-सटीकता Pareto frontier पर हर प्रशिक्षित मॉडल दिखाता है।</p></figcaption></figure>

Roboflow का Neural Architecture Search (NAS) एक शक्तिशाली नई सुविधा है जो आपके डेटासेट पर अपने-आप दर्जनों model architectures प्रशिक्षित करती है और गति-बनाम-सटीकता tradeoff curve पर सबसे अच्छे विकल्प दिखाती है, जिससे पारंपरिक model training strategies की तुलना में कम प्रति-model लागत पर चुनने के लिए कई model options बनते हैं।

जैसा कि बताया गया है [RF-DETR पेपर में](https://arxiv.org/html/2511.09554v2), यह Neural Architecture Search रणनीति ही थी जिसने RF-DETR की SOTA model architecture तैयार की। Roboflow इस रणनीति को सभी Roboflow ग्राहकों के लिए उपलब्ध करा रहा है, जिससे कोई भी अपने use case के लिए SOTA models बना सके।

Neural Architecture Search:

* आपके data characteristics के आधार पर आपके use case के लिए सबसे उपयुक्त model architecture की पहचान करता है
* उस architecture को आपके data पर fine-tune करता है
* 5,000 से अधिक configurations का परीक्षण करता है, जिसके परिणामस्वरूप 10-100 trained models मिलते हैं, जो हर latency point पर accuracy के लिए optimized होते हैं।

{% embed url="<https://youtu.be/ZtGXkuo1qiE>" %}

## Neural Architecture Search कब उपयोग करें

जब आप उस model को चुन रहे हों जो production में जाएगा, तब NAS लगभग हमेशा चलाने लायक होता है। क्योंकि Pareto frontier पर मौजूद हर mined model आपके data पर पूरी तरह trained होता है, आप सिर्फ size नहीं चुनते - आप अपने विशिष्ट deployment target के लिए सबसे अच्छा speed/accuracy tradeoff चुनते हैं। वास्तविक customer runs में, NAS नियमित रूप से समान latency पर एक अकेले RF-DETR Medium fine-tune से बेहतर प्रदर्शन करता है, और अक्सर काफी बड़े अंतर से।

इन स्थितियों में NAS चुनें:

* जब आपको किसी दिए गए latency budget पर बेहतर accuracy, या किसी दिए गए accuracy target पर बेहतर latency चाहिए।
* जब आप production के लिए model तैयार कर रहे हों और speed/accuracy curve के साथ विकल्पों की तुलना करना चाहते हों।
* अन्यथा आप hyperparameter sweep चलाते या कई model sizes को एक के बाद एक प्रशिक्षित करते।
* आपको state-of-the-art performance चाहिए।

यदि NAS ज़रूरत से ज़्यादा हो सकता है:

* आपका use case सीधा है और एक "काफ़ी अच्छा" model पर्याप्त है (जैसे: अच्छी रोशनी वाले वातावरण में लोगों का पता लगाना)। खोजपरक या शुरुआती-चरण projects के लिए, एक single fine-tune आमतौर पर सही विकल्प होता है।
* आप केवल सबसे बड़ा RF-DETR checkpoint (जैसे: RF-DETR XXL) चाहते हैं और छोटे trade-off points की परवाह नहीं करते।

## लागत, credits, और plan उपलब्धता

NAS Core पर उपलब्ध है, जिसमें Free Tier भी शामिल है।

NAS runs पर मानक Roboflow training rate के अनुसार बिल किया जाता है - **प्रशिक्षण समय के हर 30 मिनट पर 1 credit** - यानी किसी भी अन्य training job जैसी ही प्रति-hour दर। एक run दर्जनों trained models बनाता है, इसलिए cost *प्रति model* किसी-एक-एक को अलग-अलग प्रशिक्षित करने से कम होती है, लेकिन एक single NAS job के लिए कुल credit खर्च एक single fine-tune से अधिक होता है।

आम तौर पर ध्यान में रखने योग्य सीमाएँ:

* \~2,500 images वाला object detection dataset आम तौर पर \~18 घंटे (\~36 credits) चलता है।
* **Instance Segmentation NAS** object detection NAS की तुलना में अधिक GPU-intensive है - लगभग 1.5–2x लंबी runs की अपेक्षा करें।

Train UI शुरू करने से पहले अनुमानित अवधि और credit cost दिखाती है। यदि अनुमान एक दिन के प्रशिक्षण से अधिक हो, तो job शुरू होने से पहले आपसे पुष्टि करने को कहा जाएगा।

एक NAS run में उसका training और उसका architecture search अलग-अलग bill होता है, इसलिए आप प्रत्येक के लिए एक [credit cap](/models/hi/train/train-a-model.md#set-a-credit-cap) लगा सकते हैं। केवल training phase पर cap लगाने से search uncapped रहता है, और इसका उलटा भी।

{% hint style="warning" %}
शुरू करने से पहले अपना credit balance जांचें। [Flex Billing प्रबंधित करें](https://docs.roboflow.com/platform/billing-and-plans/credits/enable-or-disable-flex-billing) ताकि आपके शामिल और prepaid credits से आगे के खर्च को नियंत्रित किया जा सके।
{% endhint %}

## NAS बनाम YOLO-NAS

{% hint style="info" %}
यहाँ वर्णित "Neural Architecture Search" engine वही नहीं है जो **YOLO-NAS**है, एक single YOLO-based architecture, जो Roboflow model list में भी दिखाई देता है। यदि आपने विशेष रूप से NAS का उपयोग करने के लिए upgrade किया है, तो सुनिश्चित करें कि आप Train page पर **Neural Architecture Search** engine चुन रहे हैं - न कि YOLO-NAS model architecture।
{% endhint %}

Roboflow NAS, RF-DETR का उपयोग करके एक अधिक मजबूत आधार से शुरू होता है, जिसमें अपने backbone में अधिक world knowledge शामिल है। वहाँ से, NAS architecture को आपके dataset के अनुसार ढालता है - उदाहरण के लिए, यदि आपके data को कम decoder layers वाले model से लाभ होता है, तो NAS उस architecture को स्वतः खोज और उपलब्ध करा सकता है।

## समर्थित कार्य और ज्ञात सीमाएँ

NAS वर्तमान में समर्थन करता है:

* Object Detection
* Instance Segmentation
* Semantic Segmentation

अन्य वर्तमान सीमाएँ:

* Raw weights (`.pt`, `.onnx`, आदि) को third-party inference servers पर उपयोग के लिए डाउनलोड नहीं किया जा सकता। NAS models Roboflow Serverless Cloud API, Dedicated Deployments, Workflows, Batch Processing, और self-hosted [Roboflow Inference](https://docs.roboflow.com/deployment/self-hosted/self-hosted). NAS weights डाउनलोड और चलाने के लिए, हम Roboflow Inference की अनुशंसा करते हैं।
* NAS द्वारा खोजे गए model weights Roboflow के [Platform Model License](https://roboflow.com/platform-model-license-1-0)के अंतर्गत लाइसेंस प्राप्त हैं, जिसके लिए आपका Roboflow account अच्छी स्थिति में होना आवश्यक है।

## एक NAS training run शुरू करें

{% stepper %}
{% step %}
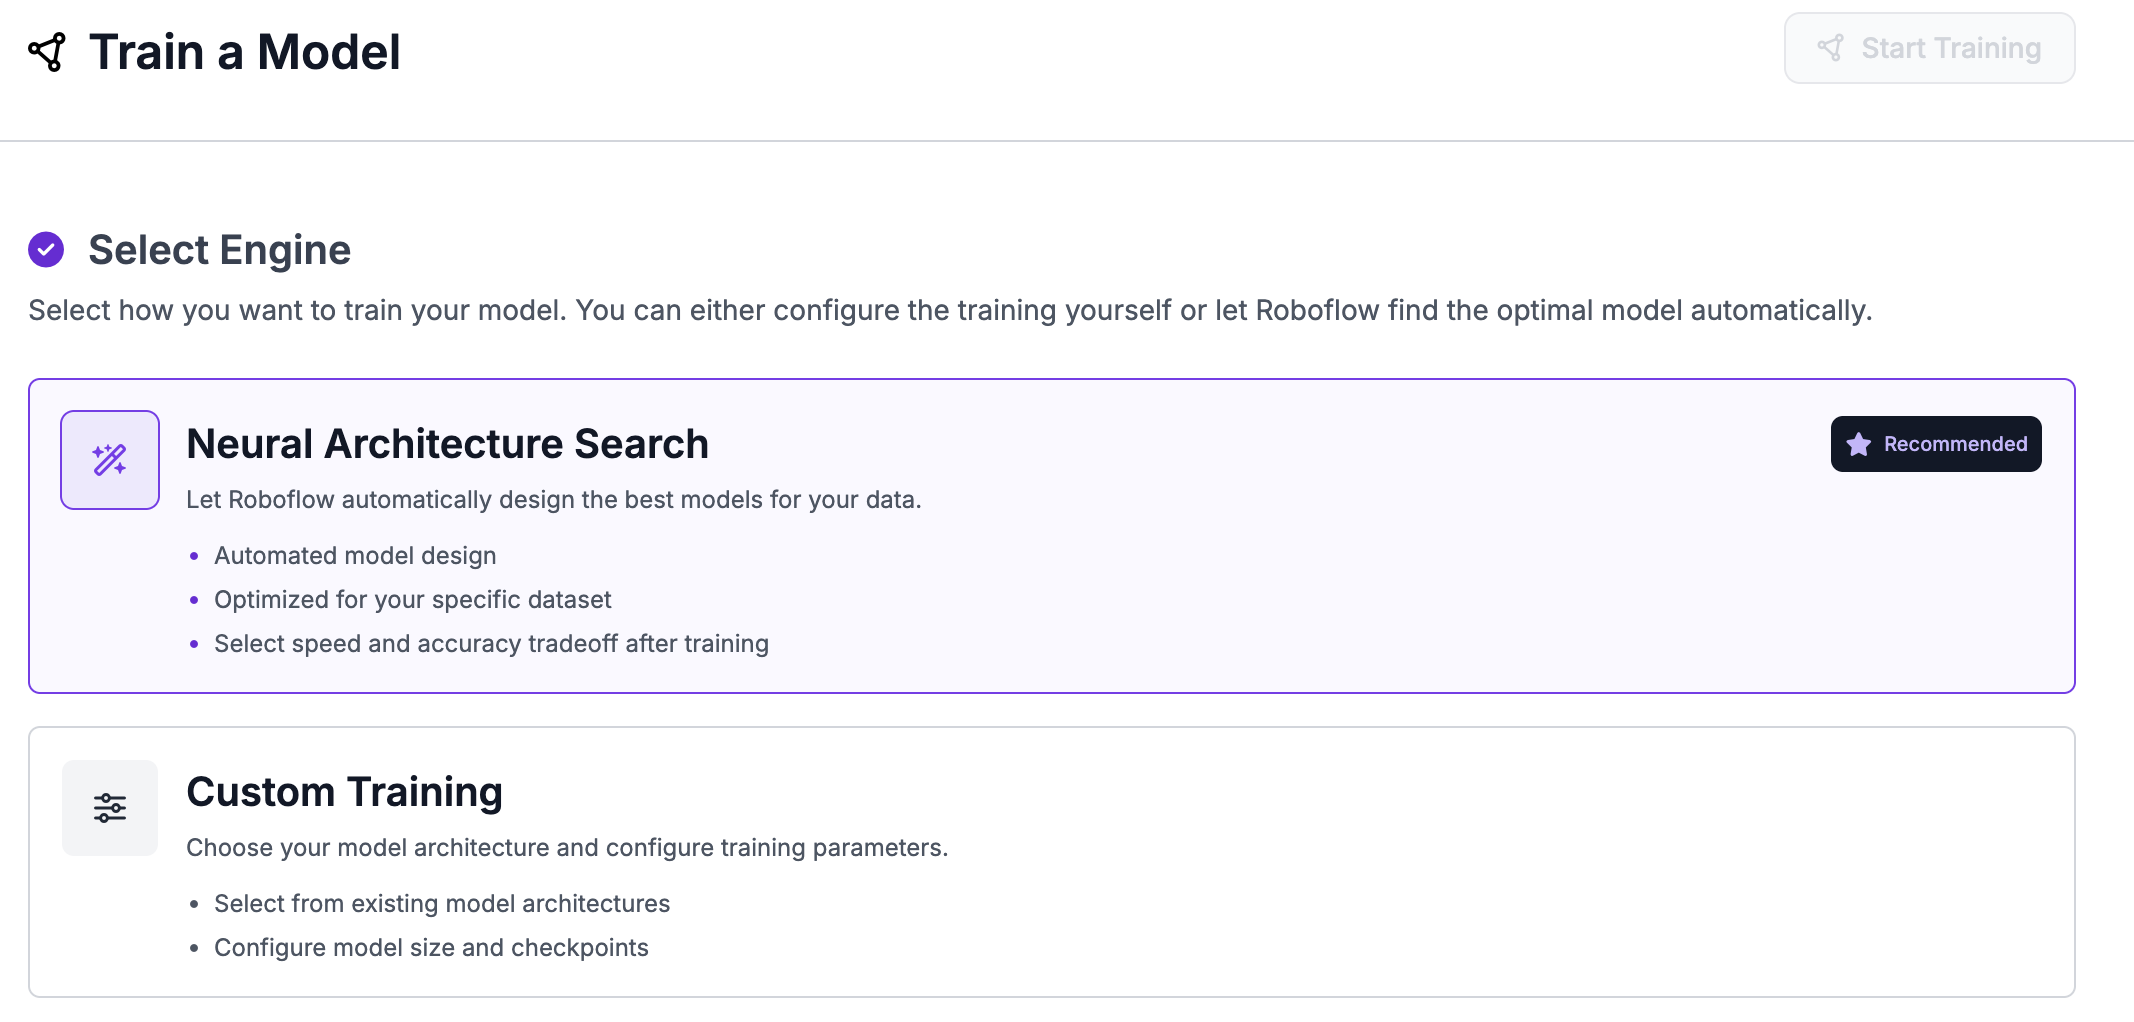
**Train tab खोलें और Neural Architecture Search engine चुनें**

अपने project में Train tab खोलें (at `https://app.roboflow.com/YOUR_WORKSPACE/YOUR_PROJECT_NAME/train`) और **Neural Architecture Search** engine चुनें।

<figure><img src="https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-9c88c779f5a8dde416ae742243ffb374d1802fd8%2Fnas-select-engine.png?alt=media" alt="Train tab engine selector with Neural Architecture Search highlighted."><figcaption><p>Train tab पर Neural Architecture Search engine चुनें।</p></figcaption></figure>
{% endstep %}

{% step %}
**एक backbone चुनें**

कई model variants वाले project types के लिए (जैसे: object detection Fast, Standard, और Plus प्रदान करता है), आगे बढ़ने से पहले आपको एक backbone चुनना होगा। जो variant आपके use case के लिए उपयुक्त हो उस पर क्लिक करें। एक ही variant वाले project types (जैसे: instance segmentation) के लिए, यह स्वचालित रूप से चुना जाता है।
{% endstep %}

{% step %}
**कोई dataset version चुनें या बनाएं**

कोई मौजूदा dataset version चुनें या नया बनाएं। कुछ सुझाव:

* हम NAS training के लिए अपने dataset में augmentations जोड़ने की अनुशंसा नहीं करते।
* आपके validation split में कम-से-कम होना चाहिए **15 images**. NAS को एक स्थिर Pareto frontier खोजने के लिए पर्याप्त validation data चाहिए; API 15 validation images से कम वाले training requests को अस्वीकार कर देगा।

<figure><img src="https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-02bb1b7e47d2cf1970692961d95adc5a2568b5c0%2Fnas-select-version.png?alt=media" alt="Dataset version selector for a NAS training run."><figcaption><p>अपने NAS run के लिए कोई dataset version चुनें या बनाएं।</p></figcaption></figure>
{% endstep %}

{% step %}

#### एक backbone चुनें

Object detection projects के लिए, आप तीन backbone विकल्पों में से चुन सकते हैं:

* **Fast** - सबसे तेज़ training, सबसे कम-latency models खोजता है। CPU या edge deployment के लिए सर्वोत्तम, जहाँ inference speed सर्वोच्च प्राथमिकता है।
* **Standard** - संतुलित training time, व्यापक latency range में models खोजता है। Edge या GPU deployment के लिए सर्वोत्तम, जहाँ आप अच्छा speed-vs-accuracy tradeoff चाहते हैं।
* **Plus** - सबसे सटीक models खोजता है। Cloud GPU deployment के लिए सर्वोत्तम, जहाँ latency से अधिक accuracy महत्वपूर्ण है।

Semantic segmentation projects Standard और Plus के बीच चुनते हैं। Instance segmentation projects एक single backbone का उपयोग करते हैं और यह चरण छोड़ देते हैं।
{% endstep %}

{% step %}
**प्रशिक्षण शुरू करें**

क्लिक करें **प्रशिक्षण शुरू करें** ताकि run शुरू हो जाए।

<figure><img src="https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-82ea8de41405493849bbdc9c9284990331d993a7%2Fnas-start-train.png?alt=media" alt="Start Training button on the NAS configuration page."><figcaption><p>Configuration page से NAS run शुरू करें।</p></figcaption></figure>
{% endstep %}
{% endstepper %}

## NAS results page पढ़ना

<figure><img src="https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-a09482f629727fe1cfe37ef9c7c0052ee9b40694%2Fnas-mining-curve.png?alt=media" alt="NAS results page with purple dots representing trained models along the Pareto frontier."><figcaption><p>हर बैंगनी बिंदु एक पूरी तरह प्रशिक्षित model है जिसे deployment के लिए उपलब्ध कराया जा सकता है।</p></figcaption></figure>

results page आपके data पर NAS द्वारा खोजे और प्रशिक्षित किए गए हर model को Pareto frontier पर प्लॉट करके दिखाती है - हर latency point पर खोजा गया सबसे अच्छा model। हर बैंगनी बिंदु एक पूरी तरह प्रशिक्षित model है जिसे आप deploy कर सकते हैं। mining आगे बढ़ने पर frontier live अपडेट होता रहता है, इसलिए आप पूरी run पूरी होने से पहले ही candidates का मूल्यांकन शुरू कर सकते हैं।

**एक metric चुनना।** F1, mAP\@50, और mAP\@50:95 के बीच switch करके frontier का मूल्यांकन उस metric के विरुद्ध करें जो आपके use case के लिए महत्वपूर्ण है। अलग-अलग metrics के लिए frontier पर अलग-अलग models दिखाई दे सकते हैं - यह अपेक्षित है। वह metric चुनें जो उत्पादन में आप model का आकलन कैसे करेंगे, इसे सबसे अच्छी तरह दर्शाता है, फिर अपनी target latency पर सबसे अच्छा model चुनें। हम अधिकांश use cases के लिए F1 की अनुशंसा करते हैं।

**मॉडलों को star करना।** जिन models का आप उपयोग करना चाहते हैं उन्हें star करें। Star किए गए models Workflow model picker में दिखाई देते हैं; unstar किए गए models results page पर रहते हैं लेकिन picker से छिपे रहते हैं ताकि वह साफ-सुथरा रहे। जितने चाहें उतने या जितने कम चाहें उतने star करें - starring मुफ़्त है और उलटा किया जा सकता है। किसी तैयार model को star करने से एक [model evaluation](/models/hi/evaluate/evaluate-trained-models.md) भी शुरू होता है, इसलिए आपको starring से शुरू हुई optimization के साथ-साथ accuracy और latency results भी मिलते हैं। जिस model का evaluation पहले से मौजूद है, चाहे वह waiting, running, या finished हो, उसका दोबारा evaluation नहीं किया जाता। Evaluation runs केवल उन workspaces में चलते हैं जिनमें Model Evaluation है।

**star किए गए model का उपयोग करना।** किसी भी अन्य Roboflow model की तरह Workflow में model block का उपयोग करके उसे चुनें।

NAS run के दौरान दिखाए जाने वाले live training charts (Training Progress Band और Epoch Snapshot views) के बारे में अधिक जानकारी के लिए देखें [View Training Results](/models/hi/evaluate/training-results.md).

## एक NAS run रोकना

एक NAS job के दो चरण होते हैं - **training** और **mining** - जो उसी job में एक के बाद एक चलते हैं। run रोकने के आपके पास दो तरीके हैं:

* **जल्दी रोकें** (जब आप वर्तमान frontier से संतुष्ट हों तो अनुशंसित)। चरण के अनुसार "Stop Training Early" या "Stop Mining" पर क्लिक करें। उस बिंदु तक mined models सुरक्षित रखे जाते हैं और deploy किए जा सकते हैं। पूरा हो चुका काम जितने credits उपयोग करता है, उनका bill बनाया जाता है। विवरण के लिए देखें [किसी प्रशिक्षण job को रोकना या रद्द करना](/models/hi/train/cancel-a-training-job.md) ।
* **रद्द करें** (जब आप run को पूरी तरह छोड़ना चाहते हों)। "Cancel Training" पर क्लिक करें। कोई weights सहेजे नहीं जाते, लेकिन यदि आप job की शुरुआत में रद्द करते हैं तो credits वापस कर दिए जाते हैं। देखें [किसी प्रशिक्षण job को रोकना या रद्द करना](/models/hi/train/cancel-a-training-job.md).

{% hint style="info" %}
जब model converges पर पहुँच जाता है - यानी सभी target epochs पूरे होने से पहले peak performance हासिल कर लेता है - तो NAS runs अपने-आप भी रुक जाते हैं। results page पर एक banner बताता है कि ऐसा हुआ। आपकी ओर से किसी कार्रवाई की आवश्यकता नहीं है।
{% endhint %}

## NAS द्वारा खोजे गए models deploy करना

NAS द्वारा खोजे गए models किसी भी अन्य Roboflow-trained model की तरह deploy किए जाते हैं। आप उन्हें इन पर चला सकते हैं:

* **Roboflow Serverless Cloud API** (नीचे दिए गए code examples देखें)।
* **Dedicated Deployments** अधिक throughput या reserved capacity के लिए।
* **Workflows** और **Batch Processing** vision pipelines बनाने और चलाने के लिए।
* **Self-hosted** [**Roboflow Inference**](https://docs.roboflow.com/deployment/self-hosted/self-hosted) अपने स्वयं के hardware पर (Docker, edge, या cloud)।

### Roboflow Inference के साथ NAS models स्थानीय रूप से चलाना

इंस्टॉल और शुरू करें [Roboflow Inference](https://docs.roboflow.com/deployment/self-hosted/inference-server/install) अपने hardware पर, फिर `inference-sdk` को `http://localhost:9001` पर इंगित करें और इसे अपने NAS model ID के साथ ठीक वैसे ही कॉल करें जैसे आप किसी अन्य Roboflow model के साथ करते हैं। नीचे दिए गए code examples hosted endpoint और local Inference server दोनों के साथ काम करते हैं - बस `api_url`.

### Roboflow Serverless Cloud API

{% tabs %}
{% tab title="Python (requests)" %}

```python
import base64

import requests

API_KEY = "roboflow-API-KEY"
MODEL_ID = "your-workspace/the-model-id-here"
IMAGE_PATH = "your_image_path.png"

with open(IMAGE_PATH, "rb") as f:
    image_data = base64.b64encode(f.read()).decode("utf-8")

response = requests.post(
    f"https://serverless.roboflow.com/{MODEL_ID}",
    headers={
        "Content-Type": "application/x-www-form-urlencoded",
        "Authorization": f"Bearer {API_KEY}",
    },
    data=image_data,
)

print(response.json())
```

{% endtab %}

{% tab title="Python (inference-sdk)" %}
dependencies install करने के लिए, `pip install inference-sdk`.

```python
from inference_sdk import InferenceHTTPClient, InferenceConfiguration

CLIENT = InferenceHTTPClient(
    api_url="https://serverless.roboflow.com",
    api_key="roboflow-API-KEY"
).configure(InferenceConfiguration(api_key_transport="header"))

result = CLIENT.infer("your_image_path.png", model_id="your-workspace/the-model-id-here")
print(result)
```

{% endtab %}

{% tab title="cURL" %}
**Linux या MacOS**

स्थानीय file के लिए JSON predictions प्राप्त करना जिसका नाम है `your_image_path.png`:

```bash
base64 your_image_path.png | curl -d @- \\
-H "Authorization: Bearer roboflow-API-KEY" \\
"https://serverless.roboflow.com/your-workspace/the-model-id-here?\\
```

वेब पर कहीं और होस्ट की गई image पर उसके URL के माध्यम से inference करना (यह न भूलें कि [इसे URL encode करें](https://www.urlencoder.org/)):

```bash
curl -X POST \\
-H "Authorization: Bearer roboflow-API-KEY" \\
"https://serverless.roboflow.com/your-workspace/the-model-id-here?\
image=https%3A%2F%2Fi.imgur.com%2FPEEvqPN.png"
```

{% endtab %}

{% tab title="JavaScript" %}
**Node.js**

इन उदाहरणों में अंतर्निहित `fetch` API का उपयोग किया गया है। यह Node.js 18 और बाद के संस्करणों तथा आधुनिक ब्राउज़रों में काम करता है, इसलिए किसी dependency को install करने की आवश्यकता नहीं है।

**स्थानीय image पर inference करना**

```javascript
const fs = require("fs");

const image = fs.readFileSync("your_image_path.png", {
    encoding: "base64"
});

fetch("https://serverless.roboflow.com/your-workspace/the-model-id-here", {
    method: "POST",
    headers: {
        "Content-Type": "application/x-www-form-urlencoded",
        "Authorization": "Bearer roboflow-API-KEY"
    },
    body: image
})
    .then((response) => {
        if (!response.ok) throw new Error("Request failed with status " + response.status);
        return response.json();
    })
    .then((data) => {
        console.log(data);
    })
    .catch((error) => {
        console.log(error.message);
    });
```

**URL के माध्यम से वेब पर कहीं और होस्ट की गई image पर inference करना**

```javascript
fetch(
    "https://serverless.roboflow.com/your-workspace/the-model-id-here?image=" +
        encodeURIComponent("https://i.imgur.com/PEEvqPN.png"),
    {
        method: "POST",
        headers: {
            "Authorization": "Bearer roboflow-API-KEY"
        }
    }
)
    .then((response) => {
        if (!response.ok) throw new Error("Request failed with status " + response.status);
        return response.json();
    })
    .then((data) => {
        console.log(data);
    })
    .catch((error) => {
        console.log(error.message);
    });
```

{% endtab %}
{% endtabs %}