> For the complete documentation index, see [llms.txt](https://docs.roboflow.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.roboflow.com/models/hi/train/train-a-model.md).

# एक मॉडल प्रशिक्षित करें

Roboflow डैशबोर्ड में अत्याधुनिक तकनीक का उपयोग करके एक मॉडल ट्रेन करें।

## के बारे में

आप Roboflow इंटरफ़ेस में कंप्यूटर विज़न मॉडल प्रशिक्षित कर सकते हैं।

Roboflow दो प्रशिक्षण विकल्प प्रदान करता है:

* Roboflow Custom Train: हमारी प्रमुख प्रशिक्षण सेवा, उत्पादन-तैयार मॉडल बनाने के लिए आदर्श।
* [न्यूरल आर्किटेक्चर सर्च](/models/hi/train/neural-architecture-search.md): नए मॉडल आर्किटेक्चर खोजें और उसी समय फ़ाइन-ट्यून करें।

साथ ही, जब आप अपने इमेज एनोटेशन के पहले बैच को स्वीकृत करते हैं, तो एक **Roboflow Instant Model** स्वतः प्रशिक्षित हो जाता है। इन मॉडलों का तुरंत ऑटो लेबलिंग या डिप्लॉयमेंट के लिए उपयोग किया जा सकता है।

Roboflow पर प्रशिक्षित मॉडल को Inference, हमारे ऑन-डिवाइस इन्फ़रेंस सर्वर, के साथ या क्लाउड में हमारे Serverless Cloud API के साथ Workflows, Workflows के साथ Batch Processing, या अपने मॉडल API endpoint का उपयोग करके डिप्लॉय किया जा सकता है।

{% hint style="info" %}
हमारे [लाइसेंसिंग मार्गदर्शन](https://roboflow.com/licensing) पढ़ें ताकि आप Roboflow पर प्रशिक्षित मॉडलों के लाइसेंस के बारे में अधिक जान सकें। देखें [मॉडल लाइसेंस](/models/hi/model-licenses.md) प्रत्येक आर्किटेक्चर के लाइसेंस और Roboflow पर डिप्लॉय करने में क्या शामिल है।
{% endhint %}

## वेब ऐप

### मॉडल प्रशिक्षित करें

कंप्यूटर विज़न मॉडल प्रशिक्षित करने के लिए, प्रोजेक्ट नेविगेशन में "Train" पर जाएँ।

<figure><img src="https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-2d1f17a9d0b43e75da368beb4042aae04ffb3c74%2Fimage%20(469).png?alt=media" alt=""><figcaption></figcaption></figure>

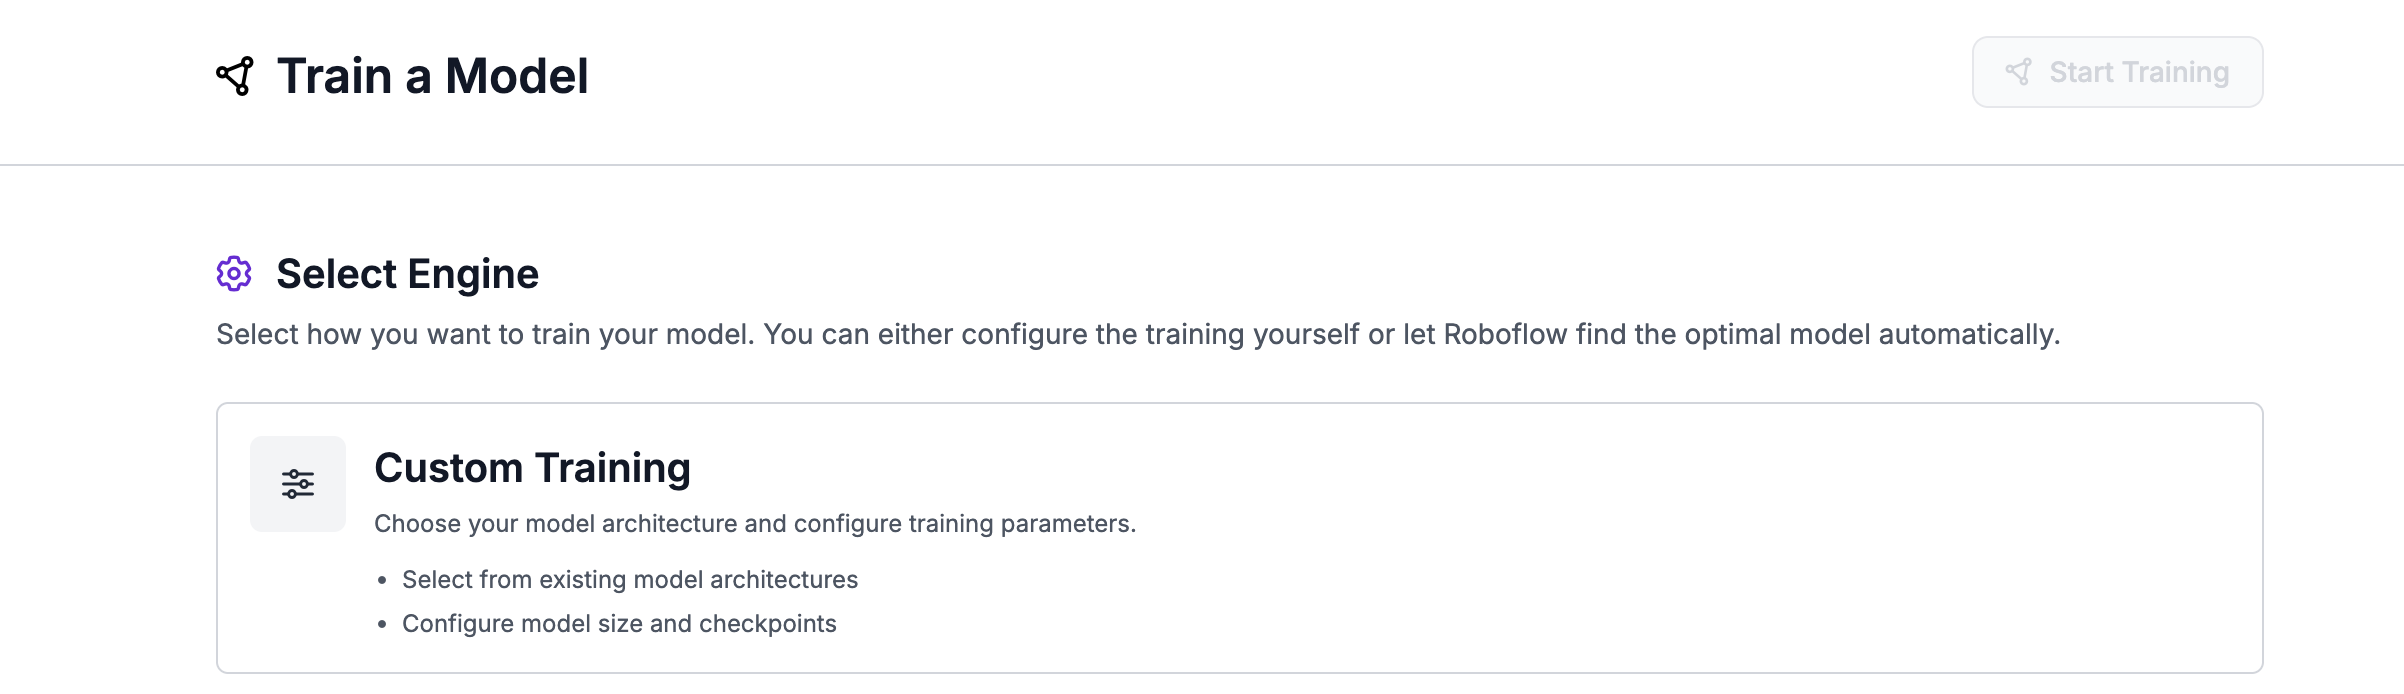
एक प्रशिक्षण जॉब कॉन्फ़िगर करना शुरू करने के लिए "Custom Training" बटन पर क्लिक करें:

<figure><img src="https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-1be2ba90f2fff0ea791352cb97bf033c4215651e%2Fimage%20(470).png?alt=media" alt=""><figcaption></figcaption></figure>

#### न्यूरल आर्किटेक्चर सर्च (NAS)

ऑब्जेक्ट डिटेक्शन और इंस्टेंस सेगमेंटेशन प्रोजेक्ट्स के लिए, आप **न्यूरल आर्किटेक्चर सर्च (NAS)** का उपयोग एकल मॉडल आर्किटेक्चर चुनने के बजाय कर सकते हैं। NAS स्वतः कई मॉडल कॉन्फ़िगरेशन को प्रशिक्षित और मूल्यांकित करता है, फिर आपकी सटीकता और लेटेंसी आवश्यकताओं के आधार पर सबसे अच्छा विकल्प सुझाता है।

NAS का उपयोग करने के लिए, प्रशिक्षण इंजन चुनते समय NAS विकल्प चुनें। NAS के लिए कम से कम 15 वैलिडेशन इमेज आवश्यक हैं।

NAS प्रशिक्षण चार्ट्स के बारे में अधिक जानकारी के लिए, देखें [प्रशिक्षण परिणाम देखें](/models/hi/evaluate/training-results.md#nas-training-charts).

#### मॉडल आर्किटेक्चर चुनें

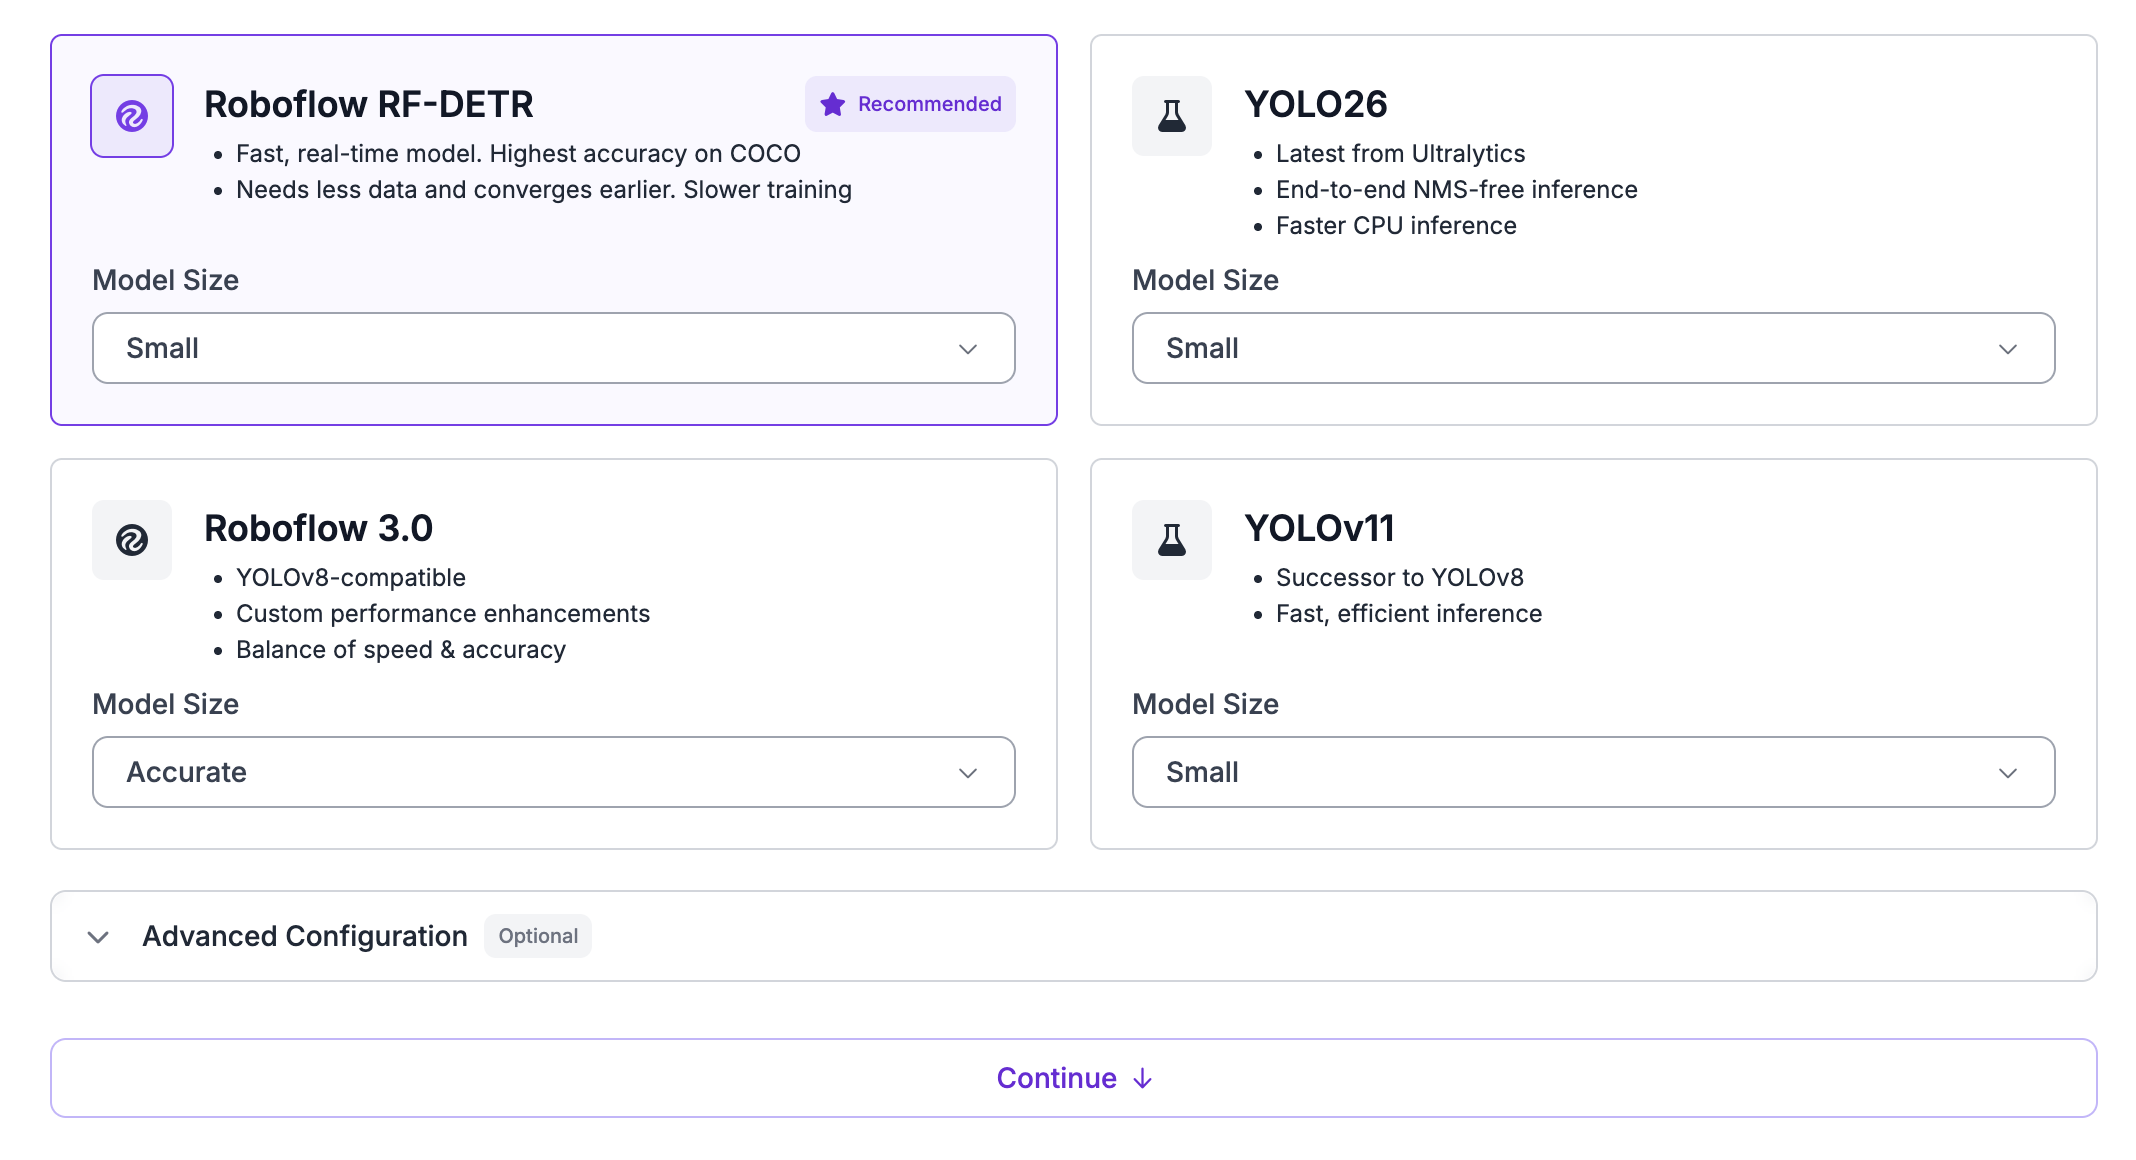
इसके बाद, आपको मॉडल आर्किटेक्चर और आकार चुनना होगा। यही मशीन लर्निंग तकनीक आपके मॉडल को प्रशिक्षित करने के लिए उपयोग की जाती है।

आप किन मॉडल आर्किटेक्चर्स को प्रशिक्षित कर सकते हैं, यह आपके सेट अप किए गए प्रोजेक्ट के प्रकार पर निर्भर करता है। [समर्थित मॉडल तालिका](/models/hi/supported-models.md) देखें ताकि प्रशिक्षण संगतता के बारे में विवरण मिल सके।

ऑब्जेक्ट डिटेक्शन के लिए, RF-DETR सर्वोत्तम सटीकता प्रदान करता है। इंस्टेंस सेगमेंटेशन के लिए, RF-DETR Seg (Preview) सर्वोत्तम सटीकता प्रदान करता है। कीपॉइंट डिटेक्शन के लिए, RF-DETR Keypoint (Preview) भी उपलब्ध है।

RF-DETR Apache 2.0 लाइसेंस के तहत जारी किया गया है, इसलिए यह तुरंत व्यावसायिक रूप से उपयोग योग्य है: आप इसे बंद-स्रोत, व्यावसायिक उत्पादों में, जिसमें self-hosted deployments भी शामिल हैं, बिना किसी लाइसेंस शुल्क या अपने कोड को open-source किए, शिप कर सकते हैं। RF-DETR XL और 2XL detection Roboflow Platform Model License (PML 1.0) का उपयोग करते हैं: जब आप Roboflow पर डिप्लॉय करते हैं तो व्यावसायिक उपयोग शामिल होता है, और व्यावसायिक self-hosting के लिए Enterprise add-on आवश्यक है। YOLO architectures (उदा.: YOLO11, YOLO26) AGPL-3.0 के अंतर्गत हैं: इन्हें Roboflow पर डिप्लॉय करने पर हर उपयोगकर्ता के लिए व्यावसायिक लाइसेंस शामिल होता है, और व्यावसायिक self-hosting एक Enterprise add-on है। देखें [मॉडल लाइसेंस](/models/hi/model-licenses.md).

मॉडल आकार आर्किटेक्चर के अनुसार भिन्न होते हैं। Free Tier सहित Core, बड़े मॉडल आकारों का समर्थन करता है। उदाहरण के लिए, RF-DETR Nano, Small, Medium, Large, XL, और 2XL प्रदान करता है। एक [SAM3](/models/hi/supported-models/sam3.md) मॉडल को Core पर उपलब्ध है [क्रेडिट-आधारित बिलिंग](https://docs.roboflow.com/platform/billing-and-plans/credits)के साथ प्रशिक्षित करना। SAM3 आर्किटेक्चर सूची में "Request Feature" बटन के साथ दिखाई देता है, जिसका उपयोग आप एक्सेस प्राप्त करने के लिए कर सकते हैं।

अपने प्रोजेक्ट प्रकार के लिए उपलब्ध एक आर्किटेक्चर चुनें। परिवार और आकार चुनते ही पेज आगे बढ़ जाता है:

<figure><img src="https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-08cf55061739c4354386d454051aaa68ffbf5b02%2Fimage%20(472).png?alt=media" alt=""><figcaption></figcaption></figure>

#### अपना डेटा चुनें

जिस डेटा पर प्रशिक्षित करना है उसे चुनें। आपको पहले संस्करण बनाने की आवश्यकता नहीं है।

* "Current Dataset" आपके प्रोजेक्ट की नवीनतम इमेज और एनोटेशन का उपयोग करता है। कार्ड में संस्करण का नाम और स्प्लिट्स संपादित करें। प्रशिक्षण शुरू होने पर Roboflow संस्करण बनाता है।
* एक सहेजा गया [संस्करण](https://docs.roboflow.com/datasets/versions/dataset-versions/create-a-dataset-version) उस संस्करण में स्थिर किए गए डेटा का उपयोग करता है।

आप किसी सहेजे गए संस्करण की सेटिंग्स को उसके कार्ड से "Current Dataset" में कॉपी कर सकते हैं। क्लास रीमैपिंग और टैग फ़िल्टर्स कॉपी नहीं होते।

#### प्रशिक्षण रेसिपी को अनुकूलित करें

"Customize Training Recipe" कार्ड में रन सेटिंग्स होती हैं: "Training Preprocessing", "Online Augmentations", "Checkpoint", "Hyperparameters", और, [न्यूरल आर्किटेक्चर सर्च](/models/hi/train/neural-architecture-search.md)के लिए, "Latency Band"। आप इनमें से किसी को बदले बिना प्रशिक्षण शुरू कर सकते हैं।

सहेजे गए संस्करण के साथ, preprocessing और augmentation पंक्तियाँ लॉक हो जाती हैं। वे चरण संस्करण जेनरेट होने पर लागू किए गए थे।

#### एक Checkpoint चुनें

"Checkpoint" अनुभाग में आप चुनते हैं कि checkpoint से प्रशिक्षण करना है या नहीं। नीचे दिए गए टैब प्रत्येक मॉडल प्रकार के लिए कॉन्फ़िगरेशन विकल्प दिखाते हैं।

{% tabs %}
{% tab title="ऑब्जेक्ट डिटेक्शन" %}
आपके पास तीन विकल्प हैं:

* **एक पिछले Checkpoint से प्रशिक्षण करें:** यह तब आदर्श है जब आपके पास पहले से एक कार्यशील मॉडल हो जिसे आप सुधारना चाहते हों।
* **पब्लिक Checkpoint से प्रशिक्षण करें:** यह आपके पहले मॉडल के लिए, या जब पिछला प्रशिक्षण रन अपेक्षित परिणाम हासिल न कर पाया हो, तब आदर्श है।
* **रैंडम इनिशियलाइज़ेशन से प्रशिक्षण करें:** **केवल उन्नत उपयोगकर्ताओं के लिए**, यह विकल्प आपको प्रशिक्षण के लिए एक खाली शुरुआत देता है। अधिकांश उपयोगकर्ताओं को इस विकल्प के उपयोग पर खराब परिणाम मिलते हैं।
  {% endtab %}

{% tab title="वर्गीकरण/सिमैंटिक सेगमेंटेशन" %}
Classification और Semantic Segmentation मॉडल्स के लिए, केवल एक checkpoint उपलब्ध है।
{% endtab %}
{% endtabs %}

<details>

<summary>मैं प्रशिक्षण विकल्प कैसे चुनूँ?</summary>

हम नए object detection प्रोजेक्ट्स के लिए Public Checkpoint से प्रशिक्षण की सलाह देते हैं। डिफ़ॉल्ट रूप से, हम Microsoft COCO dataset पर प्रशिक्षित एक मॉडल से प्रशिक्षण प्रदान करते हैं। Classification और semantic segmentation के लिए, हम केवल ImageNet से प्रशिक्षण का समर्थन करते हैं।

आप Universe पर होस्ट किए गए प्रोजेक्ट्स पर आधारित checkpoints से प्रशिक्षण कर सकते हैं (केवल object detection)। ऐसा करने के लिए, पहले [Universe में किसी प्रोजेक्ट को स्टार करें](https://blog.roboflow.com/launch-universe-model-checkpoint/)। फिर, वह प्रोजेक्ट Roboflow web application में एक training checkpoint के रूप में उपलब्ध होगा।

इसके अलावा, आप मॉडल के पिछले संस्करण पर आधारित checkpoint से प्रशिक्षण कर सकते हैं (केवल object detection, instance segmentation, और keypoint detection)। यह तरीका तेज़ प्रशिक्षण प्रक्रिया की अनुमति देता है। हम केवल तभी पिछले checkpoint से प्रशिक्षण की सलाह देते हैं जब आपका मॉडल अच्छा प्रदर्शन करता हो)।

Checkpoint से प्रशिक्षण का अर्थ है कि आप [ट्रांसफ़र लर्निंग](https://blog.roboflow.com/what-is-transfer-learning/)का उपयोग कर रहे हैं। Transfer Learning आपके मॉडल प्रशिक्षण को आपके चुने गए मॉडल से प्रारंभ करेगा। यह प्रशिक्षण समय कम करने और बेहतर प्रशिक्षण स्कोर प्रदान करने में मदद कर सकता है।

शुरुआत से प्रशिक्षण का अर्थ है कि आप *नहीं* ट्रांसफ़र लर्निंग का उपयोग कर रहे हैं। यह आपके मॉडल प्रशिक्षण को मॉडल वेट्स के लिए यादृच्छिक प्रारंभिक मानों के साथ प्रारंभ करेगा।

</details>

#### एक क्रेडिट कैप सेट करें

आप सीमित कर सकते हैं कि एक प्रशिक्षण रन कितने क्रेडिट खर्च करेगा। प्रशिक्षण विकल्पों में "Credit Cap" में एक संख्या दर्ज करें, या बिना कैप के चलाने के लिए इसे खाली छोड़ दें। कैप के लिए [usage-based billing](https://docs.roboflow.com/platform/billing-and-plans/credits).

जब कोई रन अपनी कैप तक पहुँच जाता है, तो Roboflow उसे रोक देता है और मॉडल वेट्स सुरक्षित रखता है, ठीक उसी तरह जैसे [प्रशिक्षण को जल्दी रोकना](/models/hi/train/cancel-a-training-job.md)। जब जॉब चल रही होती है, प्रशिक्षण दिखाता है कि कैप किए गए क्रेडिट्स में से उसने कितने उपयोग किए हैं।

प्रत्येक मॉडल की एक न्यूनतम कैप होती है, जो इनपुट के नीचे दिखाई जाती है। न्यूनतम उस सबसे छोटे रन की लागत है जो अभी भी एक मॉडल बना सकता है, इसलिए छोटी कैप अस्वीकृत हो जाती है। लागत अनुमान से कम कैप की अनुमति है, लेकिन रन संभवतः पूरा होने से पहले रुक जाएगा।

[न्यूरल आर्किटेक्चर सर्च](/models/hi/train/neural-architecture-search.md) training और architecture search को अलग-अलग बिल करता है, इसलिए इसकी दो कैप होती हैं: "Training Credit Cap" और "Search Credit Cap"। एक सेट करने पर दूसरा चरण बिना कैप के रहता है।

यदि कैप किया गया रन कुछ क्रेडिट बचाकर रुकता है, तो आप उसे जारी रख सकते हैं। नया रन कैप के तहत शेष बचा हुआ खर्च कर सकता है। यदि मॉडल के न्यूनतम से कम बचा हो, तो इसके बजाय नया प्रशिक्षण शुरू करें।

#### प्रशिक्षण जॉब शुरू करें

जिस Checkpoint से प्रशिक्षण करना है उसे चुन लेने के बाद, Start Training पर क्लिक करें।

फिर आपका डेटासेट ज़िप किया जाएगा और Roboflow cloud में प्रशिक्षण के लिए तैयार किया जाएगा।

प्रशिक्षण शुरू होने से पहले, प्रशिक्षण सारांश अनुमानित अवधि और क्रेडिट लागत दिखाता है:

<figure><img src="https://3815805500-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-18d9396cb8b4f7bf0e73319da14e3cb287251177%2FScreenshot%202025-05-14%20at%2014.12.53.png?alt=media" alt=""><figcaption></figcaption></figure>

डेटासेट जितना बड़ा होगा, और आपके डेटासेट में इमेज जितनी बड़ी होंगी, आपके मॉडल को प्रशिक्षित होने में उतना ही अधिक समय लगेगा।

प्रशिक्षित Action Recognition संस्करण [Cosmos 3 Edge](/models/hi/supported-models/cosmos-3-edge.md) से वीडियो के आधार पर अनुमानित किए जाते हैं, इमेज के आधार पर नहीं। अनुमान में यह गिना जाता है कि संस्करण में कितने वीडियो हैं, प्रत्येक की लंबाई कितनी है, और रन की वीडियो सैंपलिंग सेटिंग्स क्या हैं, इसलिए उन सेटिंग्स में बदलाव अनुमान को बदल देता है। यदि संस्करण में वीडियो विवरण नहीं हैं, तो सारांश कोई अनुमान नहीं दिखाता। V-JEPA 2.1 trainings कोई अनुमान नहीं दिखातीं।

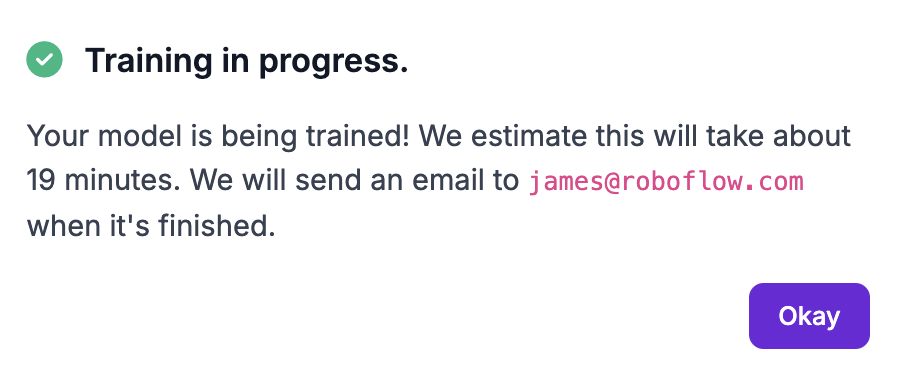
जब प्रशिक्षण प्रक्रिया पूरी हो जाएगी, आपको एक ईमेल मिलेगा। अधिकांश मामलों में, यह 24 घंटे से कम में होना चाहिए।

#### मूल्य निर्धारण

Roboflow पर प्रशिक्षण train job की लंबाई के आधार पर मूल्यांकित होता है। आप हमारे बारे में अधिक जानकारी देख सकते हैं [क्रेडिट पेज](https://www.roboflow.com/credits).

यदि आप छात्र या शोधकर्ता हैं और जिस प्रोजेक्ट पर आप काम कर रहे हैं उसके लिए क्रेडिट की आवश्यकता है, तो आप [अतिरिक्त क्रेडिट के लिए आवेदन कर सकते हैं](https://roboflow.com/contribute).

### Agent से प्रशिक्षण करें

आप वही प्रशिक्षण रन से शुरू कर सकते हैं [Roboflow Agent](https://docs.roboflow.com/agents/roboflow-agent) चैट छोड़े बिना। Agent में एक प्रोजेक्ट टैब खोलें और "Train" पर क्लिक करें। प्रशिक्षण चरण टैब के अंदर खुलते हैं: एक प्रशिक्षण इंजन चुनें, फिर एक आर्किटेक्चर और आकार, फिर अपना डेटा।

यदि आपने जो संस्करण चुना है वह अभी तक एक्सपोर्ट नहीं हुआ है, तो Agent पहले एक्सपोर्ट तैयार करता है और उसकी प्रगति दिखाता है। जब एक्सपोर्ट तैयार हो जाता है, तो प्रशिक्षण शुरू होता है। यदि प्रोजेक्ट में कोई संस्करण नहीं है, तो आप उसी स्क्रीन से एक बना सकते हैं।

यदि आप Agent से चैट में मॉडल प्रशिक्षित करने को कहते हैं, तो यह पुष्टि माँगने से पहले उस सटीक सेटअप के लिए अनुमानित अवधि और क्रेडिट लागत दिखाता है। प्रशिक्षण अक्सर जल्दी रुक जाता है, इसलिए Agent हर epoch पर पूरे रन की लागत के साथ सामान्य लागत भी दिखाता है। जब तक आप पुष्टि नहीं करते, कुछ शुरू नहीं होता, और यदि रन शुरू होने से पहले पूर्ण रन का अनुमान बदलता है, तो Agent रुककर आपसे नया नंबर पुष्टि करने को कहता है।

इस तरह प्रशिक्षण करने के लिए आपको Train Model और List Versions अनुमतियों की आवश्यकता होती है।

### एक संस्करण पर कई मॉडल प्रशिक्षित करें

आप समान डेटासेट संस्करण पर एक से अधिक मॉडल प्रशिक्षित कर सकते हैं ताकि समान डेटा के विरुद्ध आर्किटेक्चर या आकारों की तुलना की जा सके। प्रत्येक प्रशिक्षण स्वतंत्र रूप से चलता और मूल्यांकित होता है, और संस्करण पेज हर प्रशिक्षण को सूचीबद्ध करता है ताकि आप उनके बीच स्विच कर सकें।

## HTTP API

एक बार प्रोजेक्ट में एक जनरेटेड डेटासेट संस्करण हो जाए, तो आप एक training job शेड्यूल कर सकते हैं जो एक hosted model बनाता है।

### एक Training Job शुरू करें

एक dataset version पर training run शुरू करें। dataset version URL path का हिस्सा है।

```url
POST https://api.roboflow.com/:workspace/:project/:version/train
```

**बॉडी**

<table data-search="false"><thead><tr><th width="180">नाम</th><th width="140">प्रकार</th><th>विवरण</th><th data-type="checkbox">आवश्यक</th></tr></thead><tbody><tr><td><code>model_type</code></td><td>string</td><td>आर्किटेक्चर पहचानकर्ता (उदा. <code>rfdetr-nano</code>, <code>yolov8</code>, <code>yolov11</code>). पूरी सूची को त्रुटि के रूप में वापस पाने के लिए एक अवैध मान दें।</td><td>true</td></tr><tr><td><code>checkpoint</code></td><td>string</td><td>प्रशिक्षण जारी रखने के लिए वैकल्पिक checkpoint।</td><td>false</td></tr><tr><td><code>epochs</code></td><td>integer</td><td>epochs की संख्या।</td><td>false</td></tr><tr><td><code>speed</code></td><td>string</td><td><code>तेज़</code> (डिफ़ॉल्ट) या <code>सटीक</code>. <code>सटीक</code> एक सशुल्क सुविधा है।</td><td>false</td></tr><tr><td><code>trainingCreditCap</code></td><td>number</td><td>प्रशिक्षण बंद होने से पहले वह अधिकतम क्रेडिट जो खर्च कर सकता है। यह मॉडल के न्यूनतम से कम से कम होना चाहिए।</td><td>false</td></tr><tr><td><code>nasMiningCreditCap</code></td><td>number</td><td>अधिकतम क्रेडिट जो NAS architecture search खर्च कर सकता है। केवल NAS model types के लिए मान्य।</td><td>false</td></tr></tbody></table>

```bash
curl "https://api.roboflow.com/my-workspace/my-detector/3/train?api_key=$ROBOFLOW_API_KEY" \
  -X POST \
  -H "Content-Type: application/json" \
  -d '{"model_type": "rfdetr-base"}'
```

प्रशिक्षण रन असिंक्रोनस रूप से चलता है। प्रतिक्रिया यह पुष्टि करती है कि जॉब कतार में जोड़ दिया गया है, यह नहीं कि वह पूरा हो गया है। प्रगति जाँचने के लिए, पोल करें [प्रशिक्षण परिणाम](/models/hi/evaluate/training-results.md) या संस्करण के `मॉडल` फ़ील्ड को प्रशिक्षित मॉडल के प्रकट होने तक देखें।

यदि संस्करण प्रशिक्षण के लिए तैयार नहीं है, तो अनुरोध वापस करता है `400` के साथ एक `कोड` और एक `उपचार` फ़ील्ड। उपचार सुधार का नाम बताता है, इसलिए किसी स्क्रिप्ट या एजेंट को संदेश पढ़ने की आवश्यकता नहीं होती: `rebalance` (पर्याप्त इमेज हैं, लेकिन वे गलत splits में हैं), `upload` (डेटासेट को और इमेज की आवश्यकता है), `annotate` (इमेजों को लेबल की आवश्यकता है), `regenerate` (version generation विफल हो गई, इसलिए नया version बनाइए), या `प्रतीक्षा करें` (एक rebalance या generation अभी भी चल रही है)। डेटा से संबंधित नहीं होने वाली त्रुटियों, जैसे plan limits, का कोई `उपचार`.

Plan limits यहाँ उसी तरह लागू होते हैं जैसे वे web app में होते हैं। यदि आपका plan उस architecture को शामिल नहीं करता जो आप माँगते हैं, तो अनुरोध वापस करता है `400` और कोई job शुरू नहीं होती: `nas_not_available_for_plan` के लिए [NAS](/models/hi/train/neural-architecture-search.md) model types, `sam3_not_available_for_plan` के लिए [SAM3](/models/hi/supported-models/sam3.md) model types.

मॉडल के न्यूनतम से कम credit cap, या credits पर बिल न करने वाले workspace पर कोई भी cap, वापस करता है `400` code `invalid_credit_cap`. त्रुटि संदेश न्यूनतम बताता है।

कॉल करने वाले API key के पास `trainingJob:create` scope होना चाहिए।

## Python SDK

`Version.train()` Roboflow platform पर प्रशिक्षण शेड्यूल करता है। कॉल जॉब कतार में आने पर लौटती है - प्रशिक्षण स्वयं असिंक्रोनस रूप से चलता है।

```python
import roboflow

rf = roboflow.Roboflow(api_key="YOUR_API_KEY")
project = rf.workspace().project("my-detector")

# यदि आपके पास अभी तक एक संस्करण नहीं है, तो preprocessing और augmentation के साथ एक संस्करण बनाएँ।
new_version = project.generate_version({
    "preprocessing": {
        "auto-orient": True,
        "resize": {"width": 640, "height": 640, "format": "Stretch to"},
    },
    "augmentation": {},
})
version = project.version(new_version)

# प्रशिक्षण शेड्यूल करें।
model = version.train(
    model_type="rfdetr-nano",   # पूर्ण सूची को त्रुटि के रूप में वापस पाने के लिए एक अवैध मान दें
    checkpoint=None,             # वैकल्पिक: पिछले checkpoint से resume करें
    epochs=100,                  # वैकल्पिक: डिफ़ॉल्ट model-type पर निर्भर हैं
    plot_in_notebook=False,      # training-progress plot दिखाएँ (केवल notebook)
)
```

### पैरामीटर

* `model_type` (str) - आर्किटेक्चर पहचानकर्ता। सामान्य मान: `rfdetr-nano`, `rfdetr-base`, `yolov8`, `yolov11`. प्रोजेक्ट प्रकार पर निर्भर। पूरी सूची को त्रुटि के रूप में वापस पाने के लिए एक अवैध मान दें।
* `speed` (str, वैकल्पिक) - `"तेज़"` (डिफ़ॉल्ट) या `"सटीक"`. सटीक प्रशिक्षण एक सशुल्क सुविधा है।
* `checkpoint` (str, वैकल्पिक) - resume करने के लिए checkpoint का id।
* `epochs` (int, वैकल्पिक) - epochs की संख्या। डिफ़ॉल्ट model-type पर निर्भर हैं।
* `plot_in_notebook` (bool, डिफ़ॉल्ट `False`) - training progress को inline दिखाएँ (केवल notebook)।

### प्रशिक्षण के बाद

प्रशिक्षण पूरा होने पर, `Version`का `.model` property hosted model लौटाता है:

```python
predictions = version.model.predict("photo.jpg", confidence=40, overlap=30).json()
```

देखें [एक छवि पर मॉडल चलाएँ](https://docs.roboflow.com/deployment/roboflow-cloud/serverless-api#python-sdk) पूर्ण inference संदर्भ के लिए।

## CLI

आप कमांड लाइन से मॉडल प्रशिक्षण शुरू कर सकते हैं। प्रशिक्षण Roboflow के cloud infrastructure पर चलता है।

### कमांड

```bash
roboflow train start -p <project> -v <version> -t <model-type>
```

या शॉर्टहैंड का उपयोग करें (बिना `start`):

```bash
roboflow train -p <project> -v <version> -t <model-type>
```

#### विकल्प

| फ़्लैग            | विवरण                                      |
| ----------------- | ------------------------------------------ |
| `-p`, `--project` | Project ID (आवश्यक)                        |
| `-v`, `--version` | संस्करण संख्या (आवश्यक)                    |
| `-t`, `--type`    | मॉडल प्रकार, उदा. `yolov8n`, `rfdetr-nano` |
| `--checkpoint`    | जिस checkpoint से प्रशिक्षण resume करना है |
| `--speed`         | प्रशिक्षण गति प्रीसेट                      |
| `--epochs`        | प्रशिक्षण epochs की संख्या                 |

### उदाहरण

एक विशिष्ट model type के साथ प्रशिक्षण शुरू करें:

```bash
roboflow train start -p my-detector -v 3 -t yolov8n
```

एक checkpoint से resume करें:

```bash
roboflow train start -p my-detector -v 3 -t yolov8n --checkpoint my-checkpoint
```

### JSON आउटपुट

```bash
roboflow train start -p my-detector -v 3 -t yolov8n --json
```

```json
{
  "status": "training_started",
  "project": "my-detector",
  "version": 3
}
```

## MCP सर्वर

अपने AI agent को [MCP सर्वर](https://docs.roboflow.com/agents/mcp-server) से जोड़ें और वह इन tools के साथ एक मॉडल प्रशिक्षित कर सकता है:

<table data-search="false"><thead><tr><th width="290">टूल</th><th>विवरण</th></tr></thead><tbody><tr><td><code>trainings_describe_recipe</code></td><td>मॉडल प्रकार के लिए tuning विकल्पों का वर्णन करें और एक जमा करने-योग्य recipe लौटाएँ।</td></tr><tr><td><code>trainings_create</code></td><td>एक dataset version पर training run शुरू करें।</td></tr><tr><td><code>trainings_get</code></td><td>एक training की स्थिति, उत्पादित मॉडल, और metrics प्राप्त करें।</td></tr><tr><td><code>trainings_list</code></td><td>dataset version पर training runs की सूची दें।</td></tr></tbody></table>

## अगले चरण

* [एक training job को रोकें या रद्द करें](/models/hi/train/cancel-a-training-job.md).
* समीक्षा करें कि आपका मॉडल कैसा प्रदर्शन कर रहा है और training runs की तुलना करें। देखें [प्रशिक्षित मॉडल्स का मूल्यांकन करें](/models/hi/evaluate/evaluate-trained-models.md).
* अपने मॉडल को इसके साथ डिप्लॉय करें [Serverless Cloud API](https://docs.roboflow.com/deployment/roboflow-cloud/serverless-api).