> For the complete documentation index, see [llms.txt](https://docs.roboflow.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.roboflow.com/models/ja/ping-si/evaluate-trained-models.md).

# トレーニング済みモデルを評価

モデル評価を使って、テストデータセットでのモデルの性能を確認します。

## 概要

モデル評価では、次の内容が表示されます。

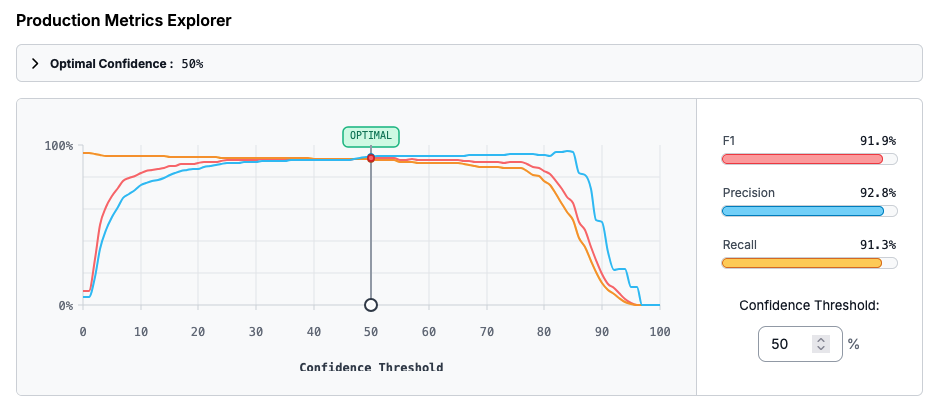
1. 本番環境メトリクスエクスプローラー。モデルを実行する際の最適な信頼度しきい値を見つけるのに役立ちます。
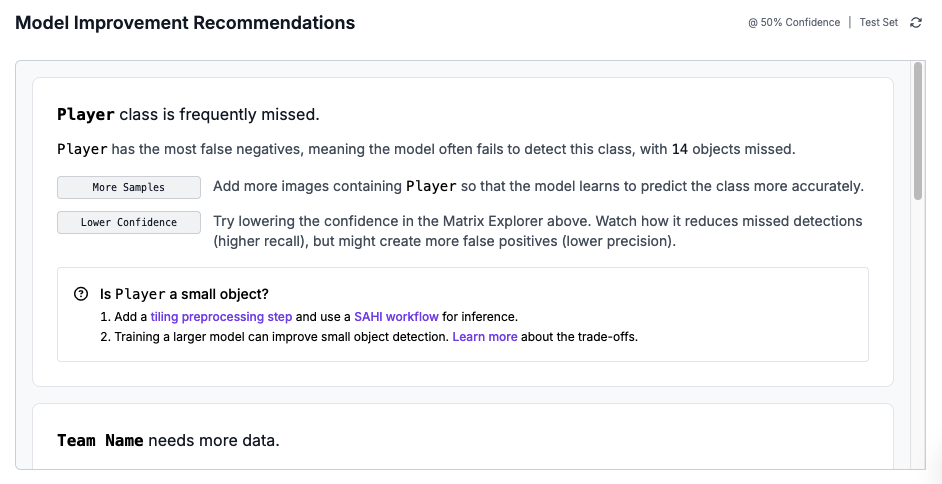
2. モデル改善の推奨事項。モデルの精度を向上させる方法について提案します。
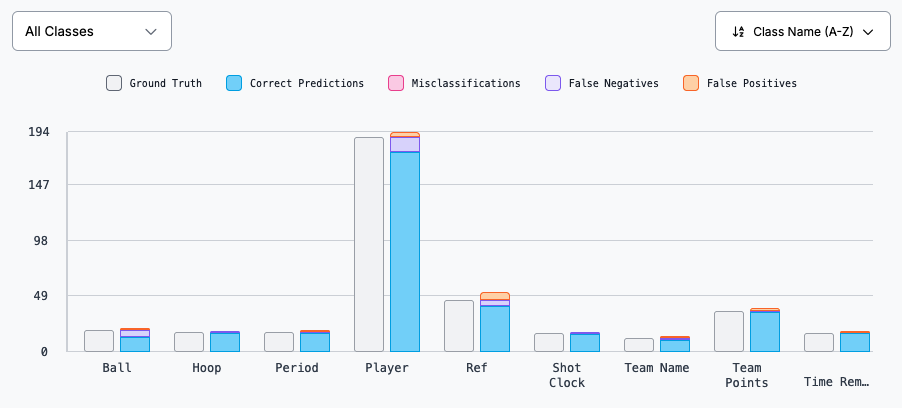
3. クラス別のパフォーマンス。モデルが異なるクラスをどの程度正確に識別しているかを表示します。
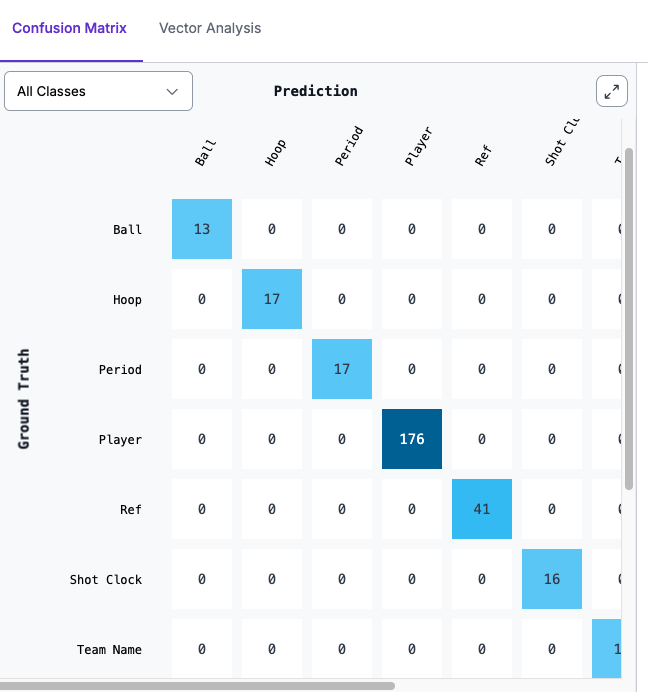
4. 混同行列。モデルが得意とする特定のクラスや苦手とするクラスを見つけるために使用できます。
5. インタラクティブなベクトルエクスプローラー。モデルのパフォーマンスが良い、または悪い画像のクラスターを特定できます。

モデル評価を使用して、モデルの改善領域を特定できます。

モデル評価は、有料ユーザーがトレーニングした、またはRoboflowにアップロードしたすべてのバージョン管理されたモデルに対して自動的に実行されます。数百枚の画像からなるデータセットでは評価に数分かかる場合があり、数千枚以上の画像を含む大規模なデータセットでは数時間かかる場合があります。

混同行列は、トレーニング済みモデルをテストセットおよび検証セットの画像で実行し、その予測をアノテーション（正解データ）と比較します。正しい予測、偽陽性（誤ったクラス、または存在しない場所のオブジェクト）、偽陰性を表示します。推奨事項はこれに基づいています。多数の偽陰性または偽陽性があるモデル、よく混同されるクラス、さらにデータが必要なクラス、または小さすぎる可能性があるテストセットや検証セットを対象にします。

### 最適な信頼度

本番環境メトリクスエクスプローラーは、すべての信頼度しきい値で適合率、再現率、F1を計算し、最適な信頼度、すなわち最もバランスの取れたしきい値を推奨します。評価が完了すると、そのしきい値がモデルの推論リクエストのデフォルトになります。クラスごとのしきい値が利用可能な場合は、それらも適用され、独自の値を持たないクラスにはグローバルしきい値がフォールバックとして使用されます。リクエストごとにこれを上書きするには、 `confidence` パラメータを渡します。

### レイテンシの中央値

この評価では、テスト画像で測定した、Serverless Cloud APIが1件のリクエストに応答するまでの時間の中央値を表示します。この値には前処理および後処理の時間が含まれます。ネットワーク時間は含まれません。モデル一覧とモデルカードには、同じ値が「レイテンシ（Cloud API）」として表示されます。 [ニューラルアーキテクチャ検索](https://docs.roboflow.com/models/ja/xue-xi/neural-architecture-search.md) ベンチマークのレイテンシは異なる方法で測定されるため、この2つを比較しないでください。

テスト画像のピクセル数がモデル入力の少なくとも2倍である場合、評価にはキャプチャ解像度に関する推奨事項が追加されます。サーバーはモデルを実行する前にすべての画像をデコードしてリサイズするため、長辺がモデル入力に近いフレームの方が高速に応答します。

使用する [モデル比較](https://docs.roboflow.com/models/ja/ping-si/compare-trained-models.md) 同じデータセットバージョン上のモデルについて、テストセットの精度とレイテンシを比較します。

### 推論用に最適化中

トレーニング後、RoboflowはモデルをServerless Cloud APIが提供するパッケージにコンパイルします。この処理中、モデルには「推論用に最適化中」と表示され、評価は完了を待機します。これにより、評価では推論リクエストを処理するものと同じパッケージが測定されます。コンパイルには通常数分追加でかかります。失敗した場合、または24時間以上かかる場合でも、評価は開始されます。

### 対応プロジェクトタイプ

モデル評価は、物体検出、インスタンスセグメンテーション、キーポイント検出、分類、セマンティックセグメンテーションのプロジェクトをサポートしています。

キーポイント検出では、mAPはObject Keypoint Similarity（OKS）を使用して、予測されたキーポイントとラベル付けされたキーポイントを対応付けます。評価画像ビューアーは予測キーポイントを描画しますが、ラベル付けされたキーポイントは描画しません。

セマンティックセグメンテーションでは、主要指標はmAPではなくmIoU（平均Intersection-over-Union）です。すべての指標（適合率、再現率、F1）は、インスタンス単位ではなくピクセル単位で計算されます。クラス別の内訳には、各クラスのIoU、適合率、再現率、F1、および最適な信頼度しきい値が表示されます。混同行列の値はオブジェクト数ではなくピクセル数を表します。

セグメンテーションモデルの新しい評価では、境界メトリクスも報告されます。境界IoUは各マスクのエッジに沿った細い帯を比較するため、マスクIoUでは見逃される可能性があるエッジのエラーを示します。インスタンスセグメンテーションでは、「詳細メトリクスを表示」の下に「平均境界平均適合率」チャートが表示されます。セマンティックセグメンテーションでは、mIoUの横にmBIoUが表示され、クラス別テーブルに「境界IoU」列が表示されます。

## Webアプリ

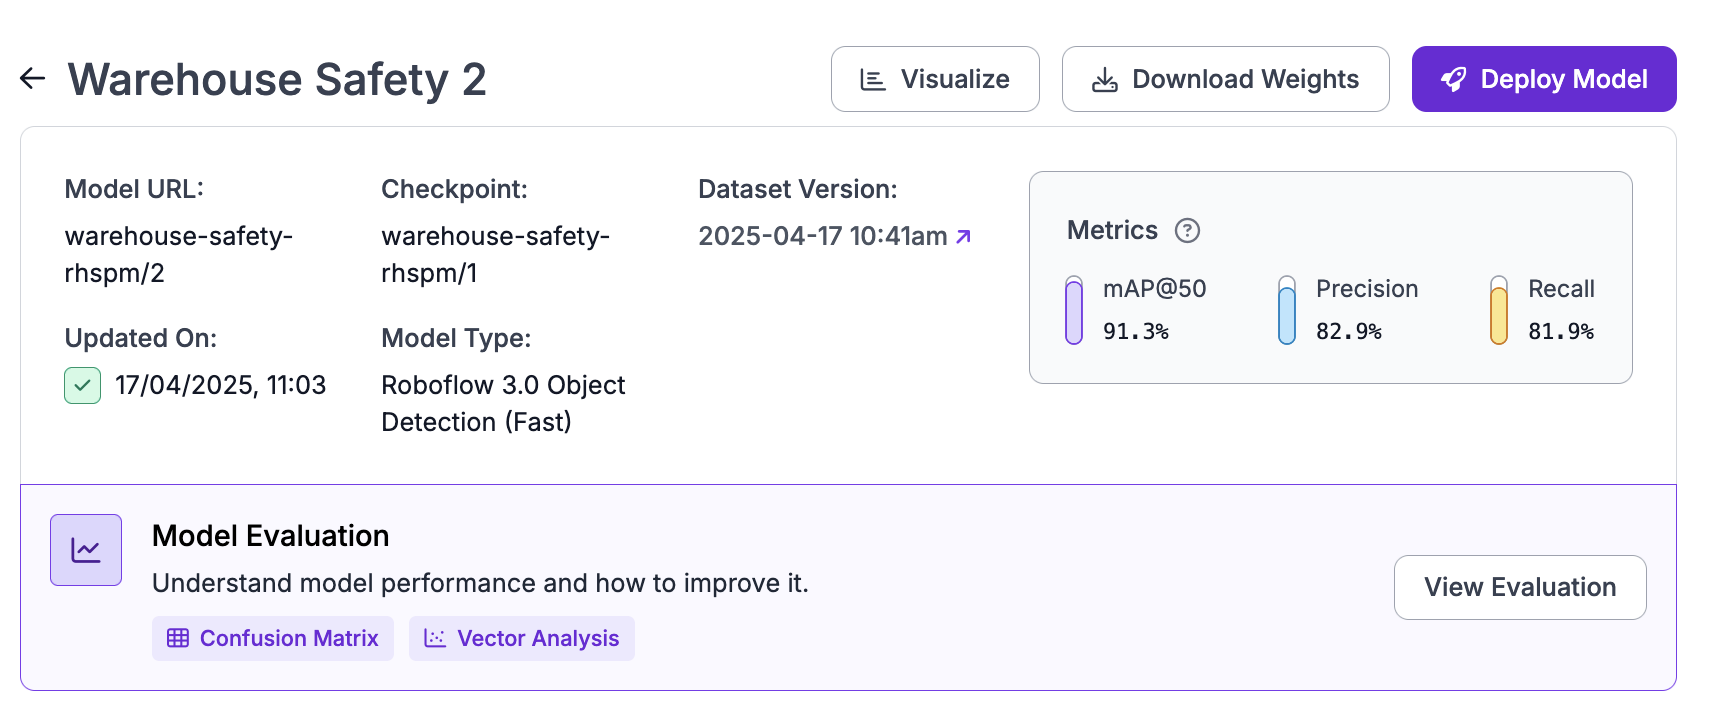
プロジェクトで「モデル」を開き、トレーニング済みモデルを選択して、「完全なモデル評価を表示」をクリックします。

<figure><img src="https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-8c6db60420e1905df8d6f3c824f91f0f219e8a76%2FScreenshot%202025-05-14%20at%2014.41.23.png?alt=media" alt=""><figcaption></figcaption></figure>

本番環境メトリクスエクスプローラーでは、スライダーをドラッグして任意の信頼度しきい値での適合率、再現率、F1を確認できます。

<figure><img src="https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-cf7be3e1155f28ab47c87709fe072e767b536898%2FScreenshot%202025-07-23%20at%2011.15.02.png?alt=media" alt=""><figcaption></figcaption></figure>

モデル改善の推奨事項には、精度を向上させるために変更すべき内容が一覧表示されます。

<figure><img src="https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-cb54b251f5e115f9a1eb549b0c03117d5b263b3b%2FScreenshot%202025-07-23%20at%2011.17.09.png?alt=media" alt=""><figcaption></figcaption></figure>

クラス別パフォーマンスチャートは、各クラスについて正しい予測、誤分類、偽陰性、偽陽性をカウントします。「すべてのクラス」ドロップダウンを使用して、特定のクラスに絞り込めます。

<figure><img src="https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-ffaf491bbb2d955905c575d90aeb04a4fd94f257%2FScreenshot%202025-07-23%20at%2011.18.34.png?alt=media" alt=""><figcaption></figcaption></figure>

混同行列では、セルをクリックすると、そのセル内の画像を確認できます（例：「偽陽性」列のセルには、アノテーションにはないオブジェクトをモデルが検出した画像が表示されます）。画像をクリックし、「正解データ」と「モデルの予測」を切り替えて、アノテーションとモデルの出力を比較します。

<figure><img src="https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-cd0af50fa3e0c4158310901798a285245a9d87bc%2FScreenshot%202025-07-23%20at%2011.20.53.png?alt=media" alt=""><figcaption></figcaption></figure>

「ベクトル分析」は、テスト画像を視覚的な類似性に基づいてプロットし、それぞれをF1スコアで色分けします。点、領域、または「特定されたクラスター」のいずれかをクリックして該当する画像を表示すると、モデルが苦手とする類似画像のグループを見つけられます。

![2枚の画像からなる選択済みクラスターが散布図で強調表示され、最も低いF1順に一覧表示されたベクトル分析](https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-f149c384f7b7dacc4a2816045a6c9e5ab8526dc0%2Fmodel-evaluation-vector-analysis.png?alt=media)

クラスチャートと混同行列は、最適な信頼度から開始します。「信頼度しきい値」スライダーを動かして、結果、適合率、再現率がどのように変化するかを確認します。

「モデルを改善」をクリックして、 [Roboflow Agent](https://docs.roboflow.com/agents/roboflow-agent) でこの評価についてのチャットを開きます。Agentは、モデルが失敗した画像をそのラベルの横に表示し、データやトレーニングの変更を提案します。ラベルエラーの可能性がある画像を1つのレビュージョブにまとめ、ラベルを確認・修正できるようにします。チームメイトのジョブから画像を移動する前には、確認を求めます。

## HTTP API

モデル評価APIは、アプリの評価ページに表示されるすべての内容を返します。各パネルには独自のエンドポイントがあります。Roboflowはトレーニングの完了時に評価を実行し、アプリから再度実行することもできます。すべてのエンドポイントには、次のスコープを持つAPIキーが必要です： `model-eval:read` スコープ。

まず [モデル評価を一覧表示](#list-model-evaluations) を使用して `evalId`を見つけ、次に [モデル評価を取得](#get-a-model-evaluation) をポーリングして、 `status` が `done`になるまで待ちます。パネルエンドポイントは、それまで `409` を返します。すべてのパネルレスポンスでは、 `evalId`, `project`, `versionId`、および `modelId`が繰り返されるため、アプリ内の評価には次のURLでリンクできます： `https://app.roboflow.com/{workspace}/{project}/evaluation/{versionId}`.

1つのバージョンで複数のモデルを比較するには、次を参照してください。 [トレーニング済みモデルを比較](https://docs.roboflow.com/models/ja/ping-si/compare-trained-models.md#http-api).

### モデル評価を一覧表示

メトリクスを含まない、各評価の短いレコードを返します。次のいずれかでフィルタリングします： `project`, `version`、または `model`。複数を送信すると、 `400`が返されます。評価をそのモデルに一致させるには、 `modelId` を推論に使用するモデルIDと比較します。

{% openapi src="/files/25f94e59dea23998da407848f4d3ea96355ac0d4" path="/{workspace}/model-evals" method="get" %}
[model-evaluations.yaml](https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### モデル評価を取得

1つの評価を返します。 `status` が `done`になると、レスポンスには `summary` が追加され、主要指標が含まれます： `mAP` は検出タスク用、 `mIoU` はセマンティックセグメンテーション用です。

{% openapi src="/files/25f94e59dea23998da407848f4d3ea96355ac0d4" path="/{workspace}/model-evals/{evaluationId}" method="get" %}
[model-evaluations.yaml](https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### mAP結果を取得

分割ごとのメインメトリクスを、分割ごとのメトリクスパネルに表示される形式で返します。まず `taskType` を読みます。これにより、分割にmAPフィールドがあるか、mIoUおよびピクセルレベルのフィールドがあるかが分かります。

{% openapi src="/files/25f94e59dea23998da407848f4d3ea96355ac0d4" path="/{workspace}/model-evals/{evaluationId}/map-results" method="get" %}
[model-evaluations.yaml](https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### 信頼度スイープを取得

本番環境メトリクスエクスプローラーの基となる曲線を返します。各信頼度しきい値での適合率、再現率、F1、および最良のF1となるしきい値です。これを使用して、デプロイ時に使用する信頼度しきい値を選択します。

{% openapi src="/files/25f94e59dea23998da407848f4d3ea96355ac0d4" path="/{workspace}/model-evals/{evaluationId}/confidence-sweep" method="get" %}
[model-evaluations.yaml](https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### クラス別パフォーマンスを取得

1つの分割のクラス別パフォーマンスパネルを返します。各クラスでは、そのクラス固有の最適なしきい値での適合率、再現率、F1が報告されます。

{% openapi src="/files/25f94e59dea23998da407848f4d3ea96355ac0d4" path="/{workspace}/model-evals/{evaluationId}/performance-by-class" method="get" %}
[model-evaluations.yaml](https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### 混同行列を取得

混同行列パネルを返します。信頼度しきい値ごとに異なる行列が得られるため、 `confidence` を渡して、デプロイ時に使用するしきい値と一致させます。

{% openapi src="/files/25f94e59dea23998da407848f4d3ea96355ac0d4" path="/{workspace}/model-evals/{evaluationId}/confusion-matrix" method="get" %}
[model-evaluations.yaml](https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### ベクトル分析を取得

ベクトル分析パネルを返します。視覚的な類似性でグループ化された画像と、各グループにおけるモデルの平均F1、適合率、再現率が含まれます。低い `f1Mean` を持つクラスターを探して、モデルが苦手とする種類の画像を見つけます。クラスター内の画像を確認するには、 [画像予測を取得](#get-image-predictions).

{% openapi src="/files/25f94e59dea23998da407848f4d3ea96355ac0d4" path="/{workspace}/model-evals/{evaluationId}/vector-analysis" method="get" %}
[model-evaluations.yaml](https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### 画像予測を取得

評価対象の画像ごとに、そのカウント、メトリクス、クラスター、混同エントリを含む1件のレコードを返します。結果は次のパラメータでページ分割されます： `limit` および `offset`.

1枚の画像を調べるには、 `imageName` または `evalInputId` を `includeGeometry=true`とともに渡します。するとレコードには保存された予測と正解データが含まれるため、失敗がモデルエラーなのかラベルエラーなのかを判断できます。

{% openapi src="/files/25f94e59dea23998da407848f4d3ea96355ac0d4" path="/{workspace}/model-evals/{evaluationId}/image-predictions" method="get" %}
[model-evaluations.yaml](https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

### 推奨事項を取得

モデル改善の推奨事項パネルを返します。Roboflowはトレーニングの完了時に推奨事項を生成し、このエンドポイントはそれらを読み取るだけです。推奨事項のない完了済み評価では、エラーではなく `200` を `generated: false`が返されます。

{% openapi src="/files/25f94e59dea23998da407848f4d3ea96355ac0d4" path="/{workspace}/model-evals/{evaluationId}/recommendations" method="get" %}
[model-evaluations.yaml](https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-92404e3372138e59de07c239bc165dac2de6cef0%2Fmodel-evaluations.yaml?alt=media)
{% endopenapi %}

## MCPサーバー

AIエージェントを [MCPサーバー](https://docs.roboflow.com/agents/mcp-server) に接続すると、これらのツールでモデルのパフォーマンスを確認できます：

<table data-search="false"><thead><tr><th width="290">ツール</th><th>説明</th></tr></thead><tbody><tr><td><code>model_evals_list</code></td><td>ワークスペース内のモデル評価を一覧表示します。</td></tr><tr><td><code>model_evals_get</code></td><td>1つの評価の最上位サマリーを取得します。</td></tr><tr><td><code>model_evals_get_map_results</code></td><td>分割ごとのmAP結果を取得します。</td></tr><tr><td><code>model_evals_get_confusion_matrix</code></td><td>混同行列を取得します。</td></tr><tr><td><code>model_evals_get_performance_by_class</code></td><td>1つの分割のクラス別パフォーマンスメトリクスを取得します。</td></tr><tr><td><code>model_evals_get_recommendations</code></td><td>利用可能な場合、評価用に生成された推奨事項を取得します。</td></tr></tbody></table>
