> For the complete documentation index, see [llms.txt](https://docs.roboflow.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.roboflow.com/models/ja/supported-models/yolo26.md).
# YOLO26
## YOLO26物体検出
YOLO26の物体検出は~を通じて実行されます [サーバーレス・クラウドAPI](https://docs.roboflow.com/deployment/roboflow-cloud/serverless-api)、COCOで事前学習済みです。セルフホスト型デプロイについては、こちらをご参照ください [Roboflow Inference](https://docs.roboflow.com/deployment/self-hosted/self-hosted).
### YOLO26物体検出API
このサンプルはテスト画像をダウンロードし、~を通じて推論を実行します `inference-sdk`、~でレスポンスをデコードし `supervision`、注釈付きPNGを書き込みます。
{% stepper %}
{% step %}
**API Key を取得する**
Roboflow アカウントを作成し、次のページでキーを見つけてください [Roboflow の API 設定ページ](https://app.roboflow.com/settings/api) そしてシェルで利用できるようにします:
```bash
export ROBOFLOW_API_KEY="your-key-here"
```
{% endstep %}
{% step %}
**依存関係をインストールする**
SDKと [supervision](https://supervision.roboflow.com/) アノテーション用ライブラリをインストールしてください:
```bash
pip install -U inference-sdk supervision opencv-python
```
{% endstep %}
{% step %}
**モデルを実行する**
実行 `yolo26n-640` をサンプル画像で実行し、ボックスとラベルに注釈を付けます:
```python
import os
import cv2
import supervision as sv
from inference_sdk import InferenceHTTPClient, InferenceConfiguration
image_url = "https://media.roboflow.com/quickstart/traffic.jpg"
image = sv.load_image_from_url(image_url)
client = InferenceHTTPClient(
api_url="https://serverless.roboflow.com",
api_key=os.environ["ROBOFLOW_API_KEY"],
).configure(InferenceConfiguration(api_key_transport="header"))
result = client.infer(image, model_id="yolo26n-640")
detections = sv.Detections.from_inference(result)
annotated = sv.BoxAnnotator().annotate(image.copy(), detections)
annotated = sv.LabelAnnotator().annotate(annotated, detections)
cv2.imwrite("traffic-annotated.png", annotated)
```
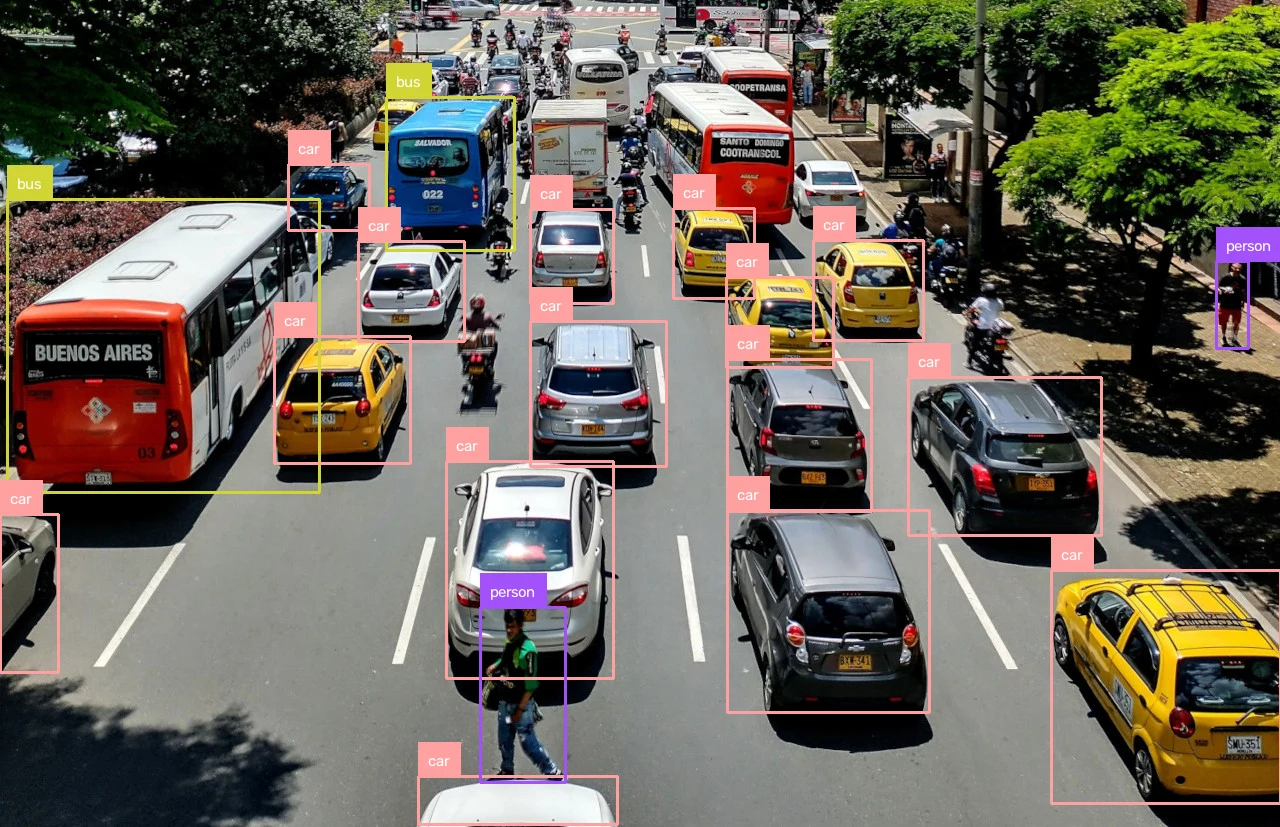 {% endstep %}
{% endstepper %}
{% hint style="info" %}
設定 `api_url` をデプロイ先に合わせて設定します:
* `https://serverless.roboflow.com` Serverless Cloud API 用。
* `http://localhost:9001` ローカルの [Inference](https://docs.roboflow.com/deployment/self-hosted/self-hosted) サーバー用。
* あなたの [専用デプロイ](https://docs.roboflow.com/deployment/roboflow-cloud/dedicated-deployments) プライベートエンドポイント用の URL。
{% endhint %}
### YOLO26物体検出モデルとベンチマーク
これらのエイリアスのいずれかを `model_id`。 `inference-sdk` 各エイリアスはクライアント側で事前学習済みのRoboflow Universeモデルに解決されます。 `yolov26*` という接頭辞のバリアントは同じモデルに解決されます。
| 別名 | 入力サイズ | mAP50-95 | ONNX レイテンシ(ms)* | TensorRT FP16 レイテンシ(ms)* |
|---|
yolo26n-640 | 640x640 | 40.9 | 3.5 | 2.2 |
yolo26s-640 | 640x640 | 48.6 | 4.7 | 3.0 |
yolo26m-640 | 640x640 | 53.1 | 8.4 | 4.4 |
yolo26l-640 | 640x640 | 55.0 | 10.7 | 5.6 |
yolo26x-640 | 640x640 | 57.5 | 18.4 | 8.0 |
## YOLO26インスタンスセグメンテーション
YOLO26のインスタンスセグメンテーションは~を通じて実行されます [サーバーレス・クラウドAPI](https://docs.roboflow.com/deployment/roboflow-cloud/serverless-api)、COCOで事前学習済みです。セルフホスト型デプロイについては、こちらをご参照ください [Roboflow Inference](https://docs.roboflow.com/deployment/self-hosted/self-hosted).
### YOLO26インスタンスセグメンテーションAPI
上で示したように API キーを設定して依存関係をインストールし、次に `yolo26n-seg-640` を使ってマスクとラベルを注釈付けします:
```python
import os
import cv2
import supervision as sv
from inference_sdk import InferenceHTTPClient
image_url = "https://media.roboflow.com/quickstart/traffic.jpg"
image = sv.load_image_from_url(image_url)
client = InferenceHTTPClient(
api_url="https://serverless.roboflow.com",
api_key=os.environ["ROBOFLOW_API_KEY"],
)
result = client.infer(image, model_id="yolo26n-seg-640")
detections = sv.Detections.from_inference(result)
annotated = sv.MaskAnnotator().annotate(image.copy(), detections)
annotated = sv.BoxAnnotator().annotate(annotated, detections)
annotated = sv.LabelAnnotator().annotate(annotated, detections)
cv2.imwrite("traffic-annotated.png", annotated)
```
 ### YOLO26インスタンスセグメンテーションモデルとベンチマーク
これらのエイリアスのいずれかを `model_id`; つまり `yolov26*` という接頭辞のバリアントは同じモデルに解決されます。ボックスとマスクのmAPはエンドツーエンド(NMSなし)のCOCO `val` の値です。
| 別名 | 入力サイズ | Box mAP50-95 | マスク mAP50-95 | ONNX レイテンシ(ms)* | TensorRT FP16 レイテンシ(ms)* |
|---|
yolo26n-seg-640 | 640x640 | 39.6 | 33.9 | 8.3 | 6.8 |
yolo26s-seg-640 | 640x640 | 47.3 | 40.0 | 10.8 | 8.5 |
yolo26m-seg-640 | 640x640 | 52.5 | 44.1 | 16.4 | 11.9 |
yolo26l-seg-640 | 640x640 | 54.4 | 45.5 | 18.4 | 12.8 |
yolo26x-seg-640 | 640x640 | 56.5 | 47.0 | 28.9 | 15.7 |
## YOLO26キーポイント検出
YOLO26のキーポイント/ポーズ検出は~を通じて実行されます [サーバーレス・クラウドAPI](https://docs.roboflow.com/deployment/roboflow-cloud/serverless-api)、COCOで事前学習済みです。セルフホスト型デプロイについては、こちらをご参照ください [Roboflow Inference](https://docs.roboflow.com/deployment/self-hosted/self-hosted).
### YOLO26キーポイント検出API
上で示したように API キーを設定して依存関係をインストールし、次に `yolo26n-pose-640` を実行してキーポイントに注釈を付けます。
```python
import os
import cv2
import supervision as sv
from inference_sdk import InferenceHTTPClient
image_url = "https://media.roboflow.com/notebooks/examples/person-walking.png"
image = sv.load_image_from_url(image_url)
client = InferenceHTTPClient(
api_url="https://serverless.roboflow.com",
api_key=os.environ["ROBOFLOW_API_KEY"],
)
result = client.infer(image, model_id="yolo26n-pose-640")
key_points = sv.KeyPoints.from_inference(result)
annotated = sv.VertexAnnotator(color=sv.Color.RED, radius=5).annotate(image.copy(), key_points)
cv2.imwrite("person-walking-annotated.png", annotated)
```
 ### YOLO26キーポイント検出モデルとベンチマーク
これらのエイリアスのいずれかを `model_id`; つまり `yolov26*` という接頭辞のバリアントは同じモデルに解決されます。mAPはエンドツーエンド(NMSなし)のCOCO `val` の値です。
| 別名 | 入力サイズ | mAP50-95 | ONNX レイテンシ(ms)* | TensorRT FP16 レイテンシ(ms)* |
|---|
yolo26n-pose-640 | 640x640 | 57.2 | 3.8 | 2.3 |
yolo26s-pose-640 | 640x640 | 63.0 | 5.1 | 3.3 |
yolo26m-pose-640 | 640x640 | 68.8 | 9.0 | 4.6 |
yolo26l-pose-640 | 640x640 | 70.4 | 11.2 | 5.8 |
yolo26x-pose-640 | 640x640 | 71.6 | 19.1 | 8.3 |
## YOLO26セマンティックセグメンテーション
YOLO26のセマンティックセグメンテーション(`yolo26-sem`)は、Roboflowでのセマンティックセグメンテーションに推奨されるアーキテクチャです。Cityscapesで事前学習された重みを使用し、デフォルト解像度1024x1024で学習します。n、s、m、l、xの5つのサイズがあります。
YOLO26-SEMモデルを学習するには、セマンティックセグメンテーションのProjectを作成し、アーキテクチャとしてYOLO26を選択してください。また、 [カスタム学習済み重みをアップロードすることもできます](https://docs.roboflow.com/models/ja/moderunomi/upload-custom-weights.md) YOLO26-SEMモデル用に。
Cityscapesで事前学習されたモデル(19クラス)も、ワークフローで実行できる公開モデルとして利用できます [Workflow](https://docs.roboflow.com/workflows) 学習なしで。
### YOLO26セマンティックセグメンテーションモデルとベンチマーク
これらのCityscapes事前学習済みエイリアスのいずれかを `model_id`; つまり `yolov26*` という接頭辞のバリアントは同じモデルに解決されます。ONNXバックエンドでのみ実行され、事前構築済みのTensorRTエンジンは公開されていません。
| 別名 | 入力サイズ | ONNX レイテンシ(ms)* |
|---|
yolo26n-sem-1024 | 1024x1024 | 23.3 |
yolo26s-sem-1024 | 1024x1024 | 25.9 |
yolo26m-sem-1024 | 1024x1024 | 34.6 |
yolo26l-sem-1024 | 1024x1024 | 35.8 |
yolo26x-sem-1024 | 1024x1024 | 53.2 |
***
\* レイテンシは以下で計測しています [Roboflow Inference](https://docs.roboflow.com/deployment/self-hosted/self-hosted) 1x NVIDIA L4、バッチサイズ 1、1,000 回の推論の平均(100 回のウォームアップ)で計測しています。デフォルトの `inference-gpu` のインストールでは CUDA 実行プロバイダー上で ONNX が実行されます。 `inference-models[trt10]` extraを選ぶと、事前構築済みのTensorRT FP16エンジンが自動的に選択されます。FP16はCOCO `val2017`で FP32 の精度と 0.2 mAP 以内で一致します。精度は公開されている COCO `val` 仕様([ソース](https://docs.ultralytics.com/models/yolo26/)).
## カスタム重みをアップロード
Roboflow外で学習したYOLO26モデルを実行するには、 [Roboflow CLI](https://docs.roboflow.com/reference/platform/cli/install-and-set-up-the-cli):
```bash
roboflow upload_model -p my-project -v 1 -t yolo26n -m ./runs/detect/train
```
設定 `-t` を、モデルのサイズとタスクに合わせて選んでください(例: `yolo26s-seg`, `yolo26m-pose`, `yolo26n-sem`)。詳しくは [カスタム重みをアップロード](https://docs.roboflow.com/models/ja/moderunomi/upload-custom-weights.md) Python SDK と学習バージョンの要件を参照してください。
## ライセンス
YOLO26はAGPL-3.0の下で公開されています。商用利用において何を意味するか:
* **Roboflowクラウドでは:** 無料プランを含むすべてのユーザーに商用ライセンスが含まれています。
* **セルフホスト型では:** Enterpriseライセンスのアドオンが必要です。さもなければ、AGPL-3.0の下でアプリケーションをオープンソース化する必要があります。
* **寛容な代替案:** [RF-DETR](https://docs.roboflow.com/models/ja/supported-models/rf-detr.md) はApache 2.0で、どこでも商用利用が無料です。
参照 [RoboflowのUltralyticsライセンス](https://roboflow.com/ultralytics) 詳細について。