> For the complete documentation index, see [llms.txt](https://docs.roboflow.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.roboflow.com/models/ja/xue-xi/train-a-model.md).

# モデルをトレーニング

Roboflow ダッシュボードで最先端技術を使ってモデルを学習します。

## 概要

Roboflowのインターフェースでコンピュータビジョンモデルをトレーニングできます。

Roboflowは2つのトレーニングオプションを提供しています：

* Roboflow Custom Train: 本番利用可能なモデルを作成するのに最適な、当社の旗艦トレーニングサービスです。
* [ニューラルアーキテクチャサーチ](/models/ja/xue-xi/neural-architecture-search.md)：新しいモデルアーキテクチャを発見し、同時に微調整できます。

また、最初の画像アノテーションバッチを承認すると、 **Roboflow Instant Model** が自動的にトレーニングされます。これらのモデルは、自動ラベリングやデプロイにすぐ使用できます。

Roboflowでトレーニングしたモデルは、オンデバイス推論サーバーであるInference、またはWorkflowsを使ったServerless Cloud API、Workflowsによるバッチ処理、あるいはモデルAPIエンドポイントを使ってクラウドにデプロイできます。

{% hint style="info" %}
こちらの [ライセンスガイダンス](https://roboflow.com/licensing) をお読みいただき、Roboflowでトレーニングしたモデルのライセンスについて詳しくご確認ください。 [モデルライセンス](/models/ja/model-licenses.md) 各アーキテクチャのライセンスと、Roboflowでのデプロイに何が含まれるかについては、こちらをご覧ください。
{% endhint %}

## Webアプリ

### モデルをトレーニング

コンピュータビジョンモデルをトレーニングするには、プロジェクトのナビゲーションで「Train」を開きます。

<figure><img src="https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-2d1f17a9d0b43e75da368beb4042aae04ffb3c74%2Fimage%20(469).png?alt=media" alt=""><figcaption></figcaption></figure>

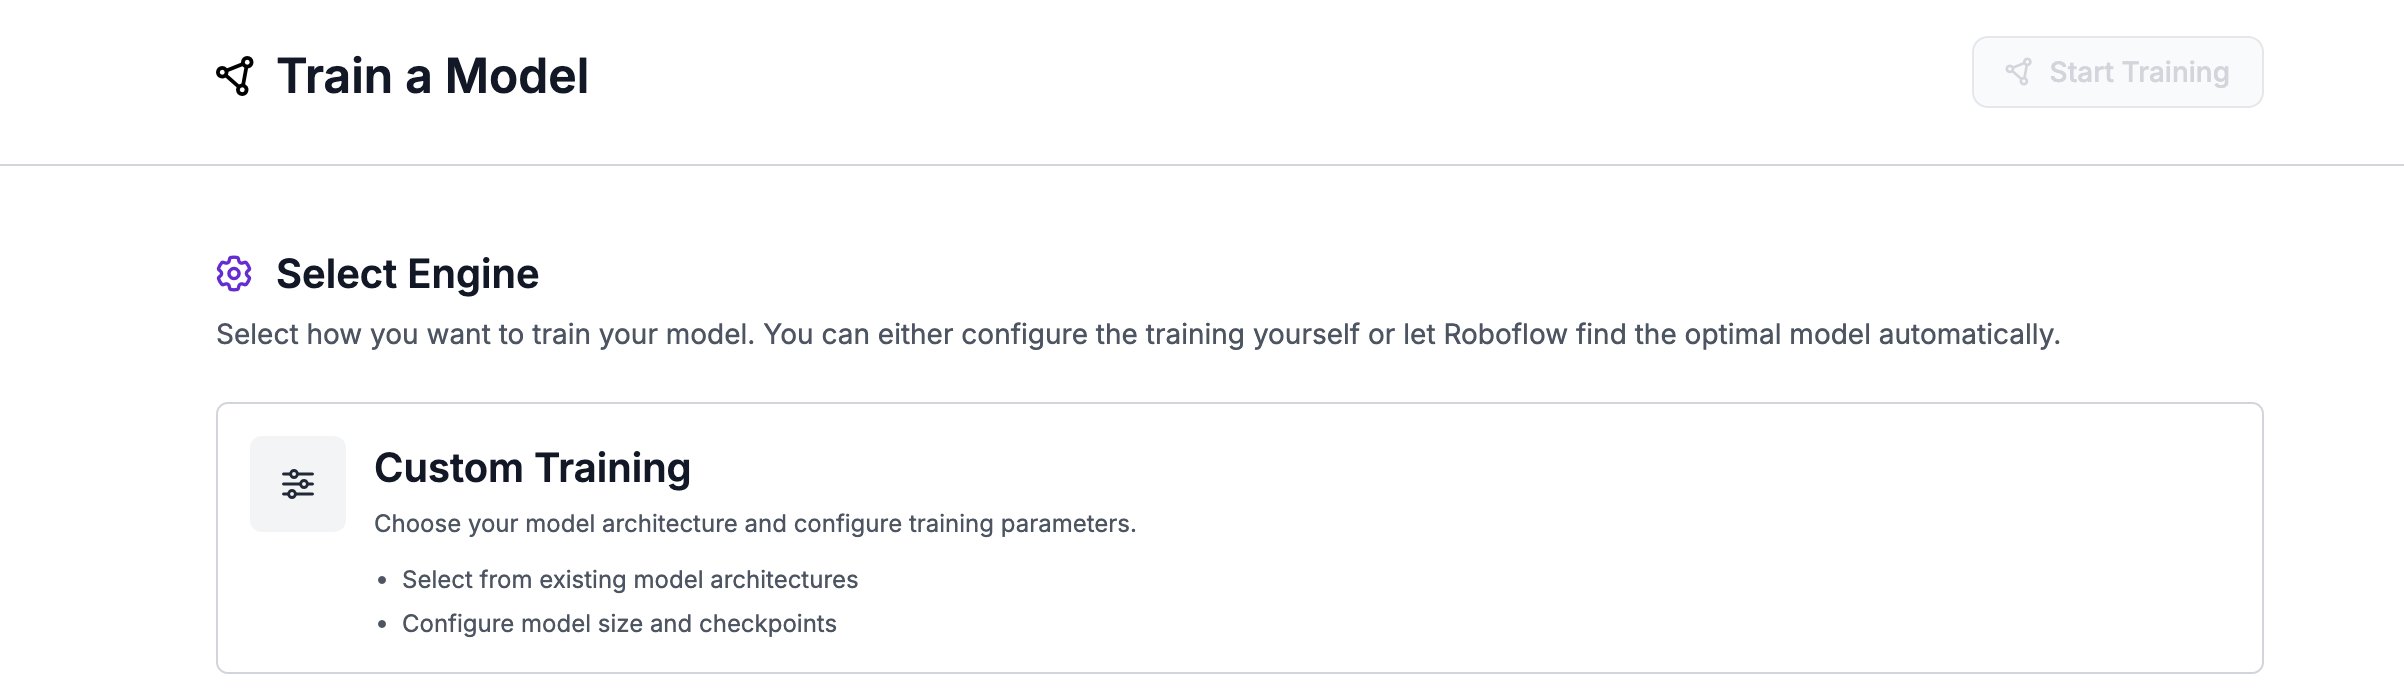
「Custom Training」ボタンをクリックして、トレーニングジョブの設定を開始します：

<figure><img src="https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-1be2ba90f2fff0ea791352cb97bf033c4215651e%2Fimage%20(470).png?alt=media" alt=""><figcaption></figcaption></figure>

#### ニューラルアーキテクチャサーチ（NAS）

物体検出およびインスタンスセグメンテーションのプロジェクトでは、 **ニューラルアーキテクチャサーチ（NAS）** を単一のモデルアーキテクチャを選ぶ代わりに使用できます。NASは複数のモデル構成を自動でトレーニング・評価し、精度と遅延の要件に基づいて最適なものを推奨します。

NASを使用するには、トレーニングエンジンを選ぶ際にNASオプションを選択します。NASには少なくとも15枚の検証画像が必要です。

NASトレーニングチャートの詳細については、こちらをご覧ください： [トレーニング結果を表示](/models/ja/ping-si/training-results.md#nas-training-charts).

#### モデルアーキテクチャを選択

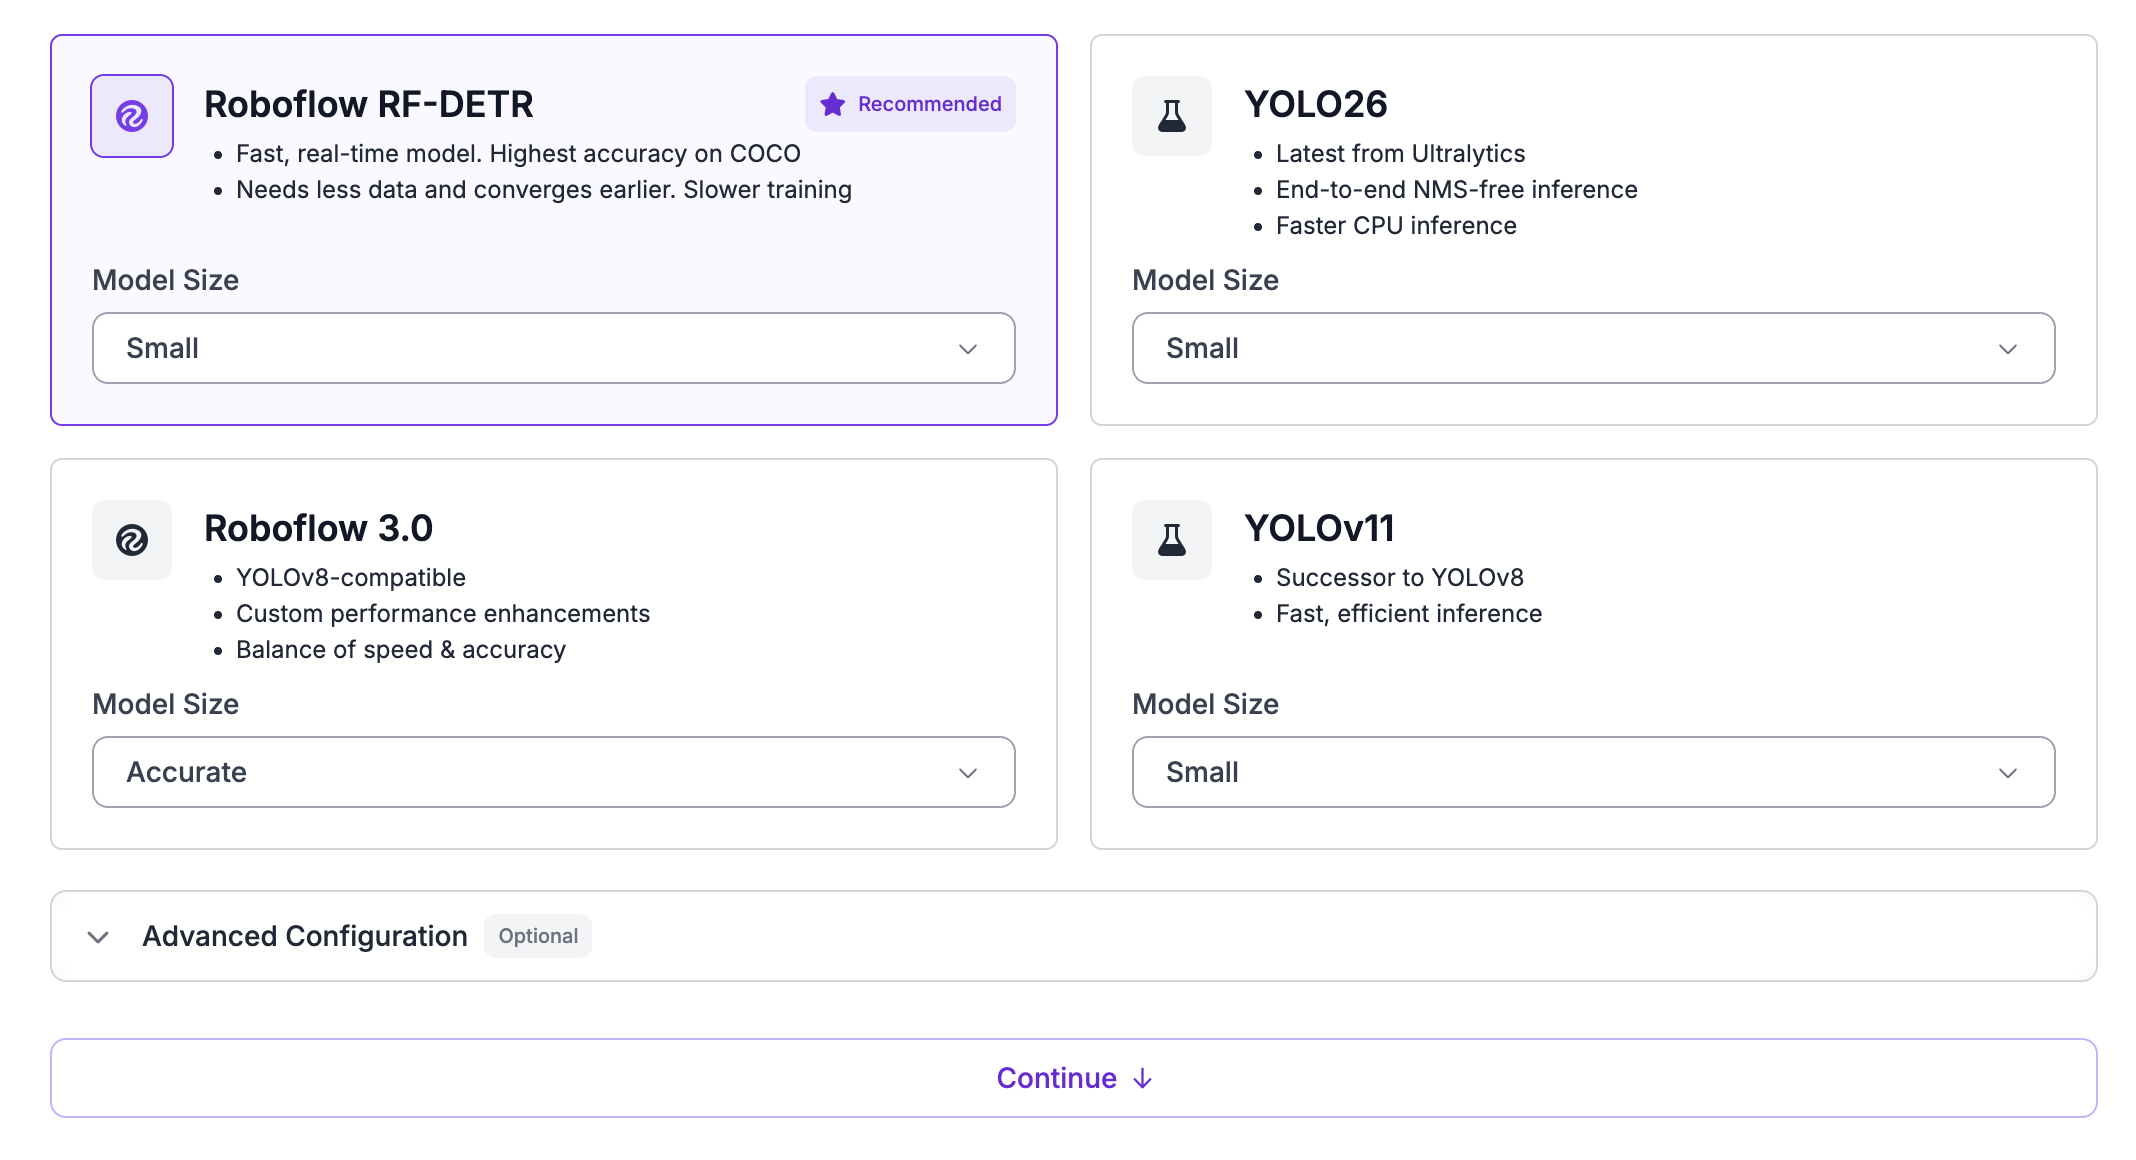
次に、モデルのアーキテクチャとサイズを選択する必要があります。これは、モデルのトレーニングに使用される機械学習技術です。

トレーニングできるモデルアーキテクチャは、設定済みのプロジェクトの種類によって異なります。 [サポートされているモデル一覧](/models/ja/supported-models.md) を参照して、トレーニング互換性の詳細をご確認ください。

物体検出ではRF-DETRが最も高い精度を提供します。インスタンスセグメンテーションではRF-DETR Seg（プレビュー）が最も高い精度を提供します。キーポイント検出ではRF-DETR Keypoint（プレビュー）も利用できます。

RF-DETRはApache 2.0ライセンスで提供されているため、すぐに商用利用できます。ライセンス料を支払ったり、コードをオープンソース化したりすることなく、セルフホスト型のデプロイを含むクローズドソースの商用製品に組み込んで出荷できます。RF-DETR XLおよび2XLの検出にはRoboflow Platform Model License（PML 1.0）が適用されます。Roboflow上でデプロイする場合は商用利用が含まれ、商用セルフホスティングにはEnterpriseアドオンが必要です。YOLOアーキテクチャ（例：YOLO11、YOLO26）はAGPL-3.0です。Roboflow上でデプロイすると、すべてのユーザーに対する商用ライセンスが含まれ、商用セルフホスティングにはEnterpriseアドオンが必要です。 [モデルライセンス](/models/ja/model-licenses.md).

モデルサイズはアーキテクチャによって異なります。Free Tierを含むCoreでは、より大きなモデルサイズがサポートされます。たとえば、RF-DETRにはNano、Small、Medium、Large、XL、2XLがあります。 [SAM3](/models/ja/supported-models/sam3.md) モデルのトレーニングはCoreで [クレジットベース課金](https://docs.roboflow.com/platform/billing-and-plans/credits)で利用できます。SAM3はアーキテクチャ一覧に「Request Feature」ボタン付きで表示され、アクセス権を取得するために使用できます。

プロジェクトの種類で利用可能なアーキテクチャを選択してください。ファミリーとサイズを選ぶと、ページは次へ進みます：

<figure><img src="https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-08cf55061739c4354386d454051aaa68ffbf5b02%2Fimage%20(472).png?alt=media" alt=""><figcaption></figcaption></figure>

#### データを選択

トレーニングに使用するデータを選択します。先にバージョンを作成する必要はありません。

* 「Current Dataset」では、プロジェクト内の最新の画像とアノテーションを使用します。カード内でバージョン名と分割を編集できます。Roboflowはトレーニング開始時にバージョンを作成します。
* 保存済みの [バージョン](https://docs.roboflow.com/datasets/versions/dataset-versions/create-a-dataset-version) では、そのバージョンに固定されたデータが使われます。

カードから保存済みバージョンの設定を「Current Dataset」にコピーできます。クラスの再マッピングとタグフィルターはコピーされません。

#### トレーニングレシピをカスタマイズ

「Customize Training Recipe」カードには、実行設定である「Training Preprocessing」「Online Augmentations」「Checkpoint」「Hyperparameters」、そして [ニューラルアーキテクチャサーチ](/models/ja/xue-xi/neural-architecture-search.md)では「Latency Band」が含まれます。どれも変更せずにトレーニングを開始できます。

保存済みバージョンでは、前処理と拡張の行はロックされています。これらのステップは、バージョン生成時に適用されています。

#### チェックポイントを選択

「Checkpoint」セクションで、チェックポイントからトレーニングするかどうかを選びます。下のタブには、各モデルタイプの設定オプションが表示されます。

{% tabs %}
{% tab title="物体検出" %}
3つの選択肢があります：

* **前のチェックポイントからトレーニング：** すでに動作している改善したいモデルがある場合に最適です。
* **公開チェックポイントからトレーニング：** 初めてのモデル、または前回のトレーニング結果が期待どおりでなかった場合に最適です。
* **ランダム初期化からトレーニング：** **上級ユーザー向け**で、このオプションではゼロからトレーニングを開始します。ほとんどのユーザーはこのオプションを使うと結果が悪くなります。
  {% endtab %}

{% tab title="分類／セマンティックセグメンテーション" %}
分類およびセマンティックセグメンテーションモデルでは、利用できるチェックポイントは1つだけです。
{% endtab %}
{% endtabs %}

<details>

<summary>どのトレーニングオプションを選べばよいですか？</summary>

新しい物体検出プロジェクトでは、公開チェックポイントからトレーニングすることを推奨します。デフォルトでは、Microsoft COCOデータセットでトレーニングされたモデルからの学習を提供しています。分類およびセマンティックセグメンテーションでは、ImageNetからのトレーニングのみをサポートしています。

Universeでホストされているプロジェクトを基にしたチェックポイントからトレーニングできます（物体検出のみ）。その場合は、まず [Universeでプロジェクトにスターを付ける](https://blog.roboflow.com/launch-universe-model-checkpoint/)と、そのプロジェクトがRoboflowのWebアプリケーションでトレーニングチェックポイントとして利用可能になります。

さらに、モデルの以前のバージョンに基づくチェックポイントからトレーニングすることもできます（物体検出、インスタンスセグメンテーション、キーポイント検出のみ）。この方法により、より速いトレーニングが可能です。モデルの性能が十分に高い場合にのみ、以前のチェックポイントからのトレーニングを推奨します。

チェックポイントからのトレーニングとは、 [転移学習](https://blog.roboflow.com/what-is-transfer-learning/)を行うことを意味します。転移学習では、選択したモデルからトレーニングを開始します。これにより、トレーニング時間を短縮し、トレーニングスコアを向上させることができます。

スクラッチからのトレーニングとは、 *ない* 転移学習を使わないことを意味します。この場合、モデルの重みにはランダムな初期値を使ってトレーニングを開始します。

</details>

#### クレジット上限を設定

1回のトレーニングで消費できるクレジット数を制限できます。トレーニングオプションの「Credit Cap」に数値を入力するか、空欄のままにして上限なしで実行します。上限を設定するには、 [使用量ベース課金](https://docs.roboflow.com/platform/billing-and-plans/credits).

のプランが必要です。上限に達すると、Roboflowはトレーニングを停止し、 [早期停止](/models/ja/xue-xi/cancel-a-training-job.md)と同様に、モデルの重みを保持します。ジョブの実行中は、トレーニングが上限クレジットのうち何クレジットを使用したかが表示されます。

各モデルには最小上限があり、入力欄の下に表示されます。最小値は、モデルを生成できる最短実行にかかるコストであるため、それより小さい上限は拒否されます。見積もりコストを下回る上限は設定できますが、その場合は完了前に実行が停止する可能性が高くなります。

[ニューラルアーキテクチャサーチ](/models/ja/xue-xi/neural-architecture-search.md) では、トレーニングとアーキテクチャサーチを別々に課金するため、2つの上限があります：「Training Credit Cap」と「Search Credit Cap」。片方を設定すると、もう片方のフェーズには上限がありません。

上限付きの実行がクレジットを残して停止した場合は、続行できます。新しい実行では、上限の残りを使用できます。残りがモデルの最小値より少ない場合は、新しくトレーニングを開始してください。

#### トレーニングジョブを開始

トレーニング元となるチェックポイントを選択したら、「Start Training」をクリックします。

その後、データセットはZIP化され、Roboflowクラウドでトレーニングできるよう準備されます。

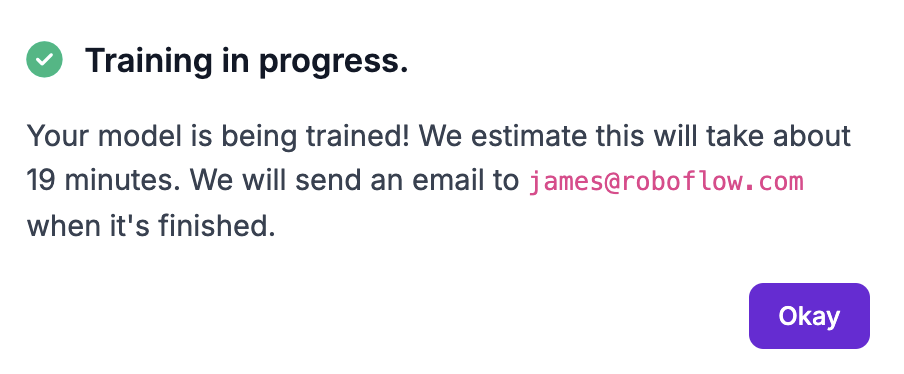
トレーニング開始前に、トレーニング概要には推定所要時間とクレジットコストが表示されます：

<figure><img src="https://1194881119-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-18d9396cb8b4f7bf0e73319da14e3cb287251177%2FScreenshot%202025-05-14%20at%2014.12.53.png?alt=media" alt=""><figcaption></figcaption></figure>

データセットが大きいほど、またデータセット内の画像が大きいほど、モデルのトレーニングにはより時間がかかります。

でトレーニングされたAction Recognitionのバージョンは [Cosmos 3 Edge](/models/ja/supported-models/cosmos-3-edge.md) 画像ではなく動画から推定されます。推定値は、そのバージョンに含まれる動画の本数、各動画の長さ、および実行時の動画サンプリング設定を数えるため、これらの設定を変更すると推定値も変わります。バージョンに動画の詳細がない場合、概要には推定値は表示されません。V-JEPA 2.1のトレーニングには推定値は表示されません。

トレーニング処理が完了するとメールが届きます。ほとんどの場合、24時間以内です。

#### 料金

Roboflowでのトレーニング料金は、トレーニングジョブの実行時間に基づきます。詳細は [クレジットページ](https://www.roboflow.com/credits).

をご覧ください。学生または研究者で、取り組んでいるプロジェクトにクレジットが必要な場合は、 [追加クレジットを申請できます](https://roboflow.com/contribute).

### Agentからトレーニング

チャットを離れずに、同じトレーニング実行を [Roboflow Agent](https://docs.roboflow.com/agents/roboflow-agent) から開始できます。Agentでプロジェクトタブを開き、「Train」をクリックします。トレーニング手順はタブ内で開きます。まずトレーニングエンジンを選び、次にアーキテクチャとサイズを選び、最後にデータを選択します。

選択したバージョンがまだエクスポートされていない場合、Agentが先にエクスポートを準備し、進行状況を表示します。エクスポートの準備ができるとトレーニングが始まります。プロジェクトにバージョンがない場合は、同じ画面から作成できます。

Agentにチャットでモデルのトレーニングを依頼すると、確認を求める前に、その構成に対する推定所要時間とクレジットコストを表示します。トレーニングは途中で停止することが多いため、Agentは全エポックを完了した場合のコストと並べて通常のコストも表示します。確認するまでは何も開始されず、実行開始前にフル実行の見積もりが変わった場合は、Agentは停止して新しい数値の確認を求めます。

この方法でトレーニングするには、Train ModelとList Versionsの権限が必要です。

### 1つのバージョンで複数のモデルをトレーニング

同じデータセットバージョンで1つ以上のモデルをトレーニングし、同一データに対するアーキテクチャやサイズを比較できます。各トレーニングは独立して実行・評価され、バージョンページにはすべてのトレーニングが一覧表示されるため、切り替えられます。

## HTTP API

プロジェクトに生成済みデータセットバージョンがあれば、ホストされたモデルを生成するトレーニングジョブをスケジュールできます。

### トレーニングジョブを開始

データセットバージョン上でトレーニング実行を開始します。データセットバージョンはURLパスの一部です。

```url
POST https://api.roboflow.com/:workspace/:project/:version/train
```

**本文**

<table data-search="false"><thead><tr><th width="180">名前</th><th width="140">種類</th><th>説明</th><th data-type="checkbox">必須</th></tr></thead><tbody><tr><td><code>model_type</code></td><td>string</td><td>アーキテクチャ識別子（例： <code>rfdetr-nano</code>, <code>yolov8</code>, <code>yolov11</code>）。無効な値を渡すと、エラーとして完全な一覧が返されます。</td><td>true</td></tr><tr><td><code>checkpoint</code></td><td>string</td><td>トレーニングを再開するための任意のチェックポイント。</td><td>false</td></tr><tr><td><code>epochs</code></td><td>整数</td><td>エポック数。</td><td>false</td></tr><tr><td><code>speed</code></td><td>string</td><td><code>高速</code> （既定）または <code>高精度</code>. <code>高精度</code> は有料機能です。</td><td>false</td></tr><tr><td><code>trainingCreditCap</code></td><td>数値</td><td>停止される前にトレーニングが使用できる最大クレジット数。少なくともモデルの最小値でなければなりません。</td><td>false</td></tr><tr><td><code>nasMiningCreditCap</code></td><td>数値</td><td>NASのアーキテクチャサーチが使用できる最大クレジット数。NASモデルタイプに対してのみ有効です。</td><td>false</td></tr></tbody></table>

```bash
curl "https://api.roboflow.com/my-workspace/my-detector/3/train?api_key=$ROBOFLOW_API_KEY" \\
  -X POST \\
  -H "Content-Type: application/json" \\
  -d '{"model_type": "rfdetr-base"}'
```

トレーニング実行は非同期です。応答はジョブがキューに入ったことを示すもので、完了したことを示すものではありません。進行状況を確認するには、 [トレーニング結果](/models/ja/ping-si/training-results.md) をポーリングするか、バージョンの `model` フィールドを監視して、トレーニング済みモデルが表示されるのを待ちます。

バージョンがトレーニング可能な状態でない場合、リクエストは `400` と `コード` および `対処法` フィールドを返します。対処法には修正内容が記載されるため、スクリプトやエージェントがメッセージを読む必要はありません： `再調整` （画像数は十分だが、分割先が間違っている） `アップロード` （データセットにもっと画像が必要） `アノテーション` （画像にラベルが必要） `再生成` （バージョン生成に失敗したため、新しいバージョンを生成してください）、または `待機` （再調整または生成がまだ実行中）。プランの制限など、データに関係しないエラーには対処法はありません。 `対処法`.

プランの制限は、Webアプリと同じようにここでも適用されます。プランに要求したアーキテクチャが含まれていない場合、リクエストは `400` を返し、ジョブは開始されません： `nas_not_available_for_plan` の [NAS](/models/ja/xue-xi/neural-architecture-search.md) モデルタイプ、 `sam3_not_available_for_plan` の [SAM3](/models/ja/supported-models/sam3.md) モデルタイプ。

モデルの最小値より低いクレジット上限、またはクレジット課金しないワークスペースに対する上限を設定すると、 `400` コード `invalid_credit_cap`が返されます。エラーメッセージには最小値が示されます。

呼び出し元のAPIキーには `trainingJob:create` スコープが必要です。

## Python SDK

`Version.train()` はRoboflowプラットフォーム上でトレーニングをスケジュールします。呼び出しは、ジョブがキューに入った時点で返り、トレーニング自体は非同期で実行されます。

```python
import roboflow

rf = roboflow.Roboflow(api_key="YOUR_API_KEY")
project = rf.workspace().project("my-detector")

# まだない場合は、前処理と拡張を含むバージョンを作成します。
new_version = project.generate_version({
    "preprocessing": {
        "auto-orient": True,
        "resize": {"width": 640, "height": 640, "format": "Stretch to"},
    },
    "augmentation": {},
})
version = project.version(new_version)

# トレーニングをスケジュールします。
model = version.train(
    model_type="rfdetr-nano",   # 無効な値を渡すと、完全な一覧がエラーとして返されます
    checkpoint=None,             # 任意：以前のチェックポイントから再開
    epochs=100,                  # 任意：既定値はモデルタイプによって異なります
    plot_in_notebook=False,      # トレーニング進行状況のプロットを表示（ノートブックのみ）
)
```

### パラメータ

* `model_type` (str) - アーキテクチャ識別子。一般的な値： `rfdetr-nano`, `rfdetr-base`, `yolov8`, `yolov11`。プロジェクトタイプによって異なります。無効な値を渡すと、完全な一覧がエラーとして返されます。
* `speed` (str, optional) - `"fast"` （既定）または `"accurate"`。高精度トレーニングは有料機能です。
* `checkpoint` (str, optional) - 再開元のチェックポイントID。
* `epochs` (int, optional) - エポック数。既定値はモデルタイプによって異なります。
* `plot_in_notebook` (bool, default `False`) - トレーニング進捗をインライン表示します（ノートブックのみ）。

### トレーニング後

トレーニングが完了すると、 `Version`の `.model` プロパティはホストされたモデルを返します：

```python
predictions = version.model.predict("photo.jpg", confidence=40, overlap=30).json()
```

参照: [画像でモデルを実行](https://docs.roboflow.com/deployment/roboflow-cloud/serverless-api#python-sdk) については、推論リファレンス全体をご覧ください。

## CLI

コマンドラインからモデルのトレーニングを開始できます。トレーニングはRoboflowのクラウドインフラ上で実行されます。

### コマンド

```bash
roboflow train start -p <project> -v <version> -t <model-type>
```

または簡略形を使用できます（ `start`):

```bash
を省略）
```

#### オプション

| フラグ               | 説明                                 |
| ----------------- | ---------------------------------- |
| `-p`, `--project` | プロジェクトID（必須）                       |
| `-v`, `--version` | バージョン番号（必須）                        |
| `-t`, `--type`    | モデルタイプ、例： `yolov8n`, `rfdetr-nano` |
| `--checkpoint`    | トレーニングを再開するチェックポイント                |
| `--speed`         | トレーニング速度プリセット                      |
| `--epochs`        | トレーニングエポック数                        |

### 例

特定のモデルタイプでトレーニングを開始：

```bash
roboflow train start -p my-detector -v 3 -t yolov8n
```

チェックポイントから再開：

```bash
roboflow train start -p my-detector -v 3 -t yolov8n --checkpoint my-checkpoint
```

### JSON出力

```bash
roboflow train start -p my-detector -v 3 -t yolov8n --json
```

```json
{
  "status": "training_started",
  "project": "my-detector",
  "version": 3
}
```

## MCPサーバー

AIエージェントを [MCPサーバー](https://docs.roboflow.com/agents/mcp-server) に接続すると、これらのツールでモデルをトレーニングできます：

<table data-search="false"><thead><tr><th width="290">ツール</th><th>説明</th></tr></thead><tbody><tr><td><code>trainings_describe_recipe</code></td><td>モデルタイプのチューニングオプションを説明し、すぐに送信できるレシピを返します。</td></tr><tr><td><code>trainings_create</code></td><td>データセットバージョン上でトレーニング実行を開始します。</td></tr><tr><td><code>trainings_get</code></td><td>トレーニングのステータス、生成されたモデル、メトリクスを取得します。</td></tr><tr><td><code>trainings_list</code></td><td>データセットバージョン上のトレーニング実行を一覧表示します。</td></tr></tbody></table>

## 次のステップ

* [トレーニングジョブを停止またはキャンセル](/models/ja/xue-xi/cancel-a-training-job.md).
* モデルの性能を確認し、トレーニング実行を比較します。 [トレーニング済みモデルを評価](/models/ja/ping-si/evaluate-trained-models.md).
* でモデルをデプロイします。 [サーバーレス・クラウド API](https://docs.roboflow.com/deployment/roboflow-cloud/serverless-api).
