> For the complete documentation index, see [llms.txt](https://docs.roboflow.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.roboflow.com/models/ko/evaluate/evaluate-trained-models.md).

# 학습된 모델 평가

모델 평가를 사용하여 테스트 데이터셋에서 모델의 성능을 살펴보세요.

## 정보

모델 평가는 다음을 보여줍니다:

1. 모델을 실행할 최적의 신뢰도 임계값을 찾는 데 도움이 되는 프로덕션 메트릭 탐색기;
2. 모델의 정확도를 높이는 방법에 대한 제안을 제공하는 모델 개선 권장 사항;
3. 모델이 서로 다른 클래스를 얼마나 잘 식별하는지 보여주는 클래스별 성능;
4. 모델이 특히 잘하거나 어려워하는 특정 클래스를 찾는 데 사용할 수 있는 혼동 행렬;
5. 모델 성능이 좋거나 나쁜 이미지 클러스터를 식별할 수 있는 대화형 벡터 탐색기;

모델 평가를 사용하여 모델의 개선 영역을 식별할 수 있습니다.

모델 평가는 유료 사용자가 Roboflow에서 학습했거나 Roboflow에 업로드한 모든 버전 관리 모델에 대해 자동으로 실행됩니다. 수백 장의 이미지로 구성된 데이터 세트의 평가는 몇 분이 걸릴 수 있으며, 수천 장 이상의 이미지가 있는 대규모 데이터 세트는 몇 시간이 걸릴 수 있습니다.

### 추론 최적화

학습 후 Roboflow는 모델을 Serverless Cloud API가 제공하는 패키지로 컴파일합니다. 이 작업이 실행되는 동안 모델에는 "추론 최적화"가 표시되며, 평가는 작업이 완료될 때까지 기다립니다. 이렇게 하면 평가에서 추론 요청을 제공하는 동일한 패키지를 측정합니다. 컴파일에는 일반적으로 몇 분이 추가됩니다. 실패하거나 24시간 이상 걸리면 평가는 계속 시작됩니다.

### 지원되는 프로젝트 유형

모델 평가는 객체 감지, 인스턴스 분할, 분류 및 시맨틱 분할 프로젝트를 지원합니다.

시맨틱 분할의 주요 지표는 **mIoU** mAP 대신 (평균 교집합-합집합 비율)입니다. 모든 지표(정밀도, 재현율, F1)는 인스턴스별이 아니라 픽셀 수준에서 계산됩니다. 클래스별 분석은 각 클래스의 IoU, 정밀도, 재현율, F1 및 최적 신뢰도 임계값을 보여 줍니다. 혼동 행렬 값은 객체 수가 아니라 픽셀 수를 나타냅니다.

## 웹 앱

### 모델 평가 열기

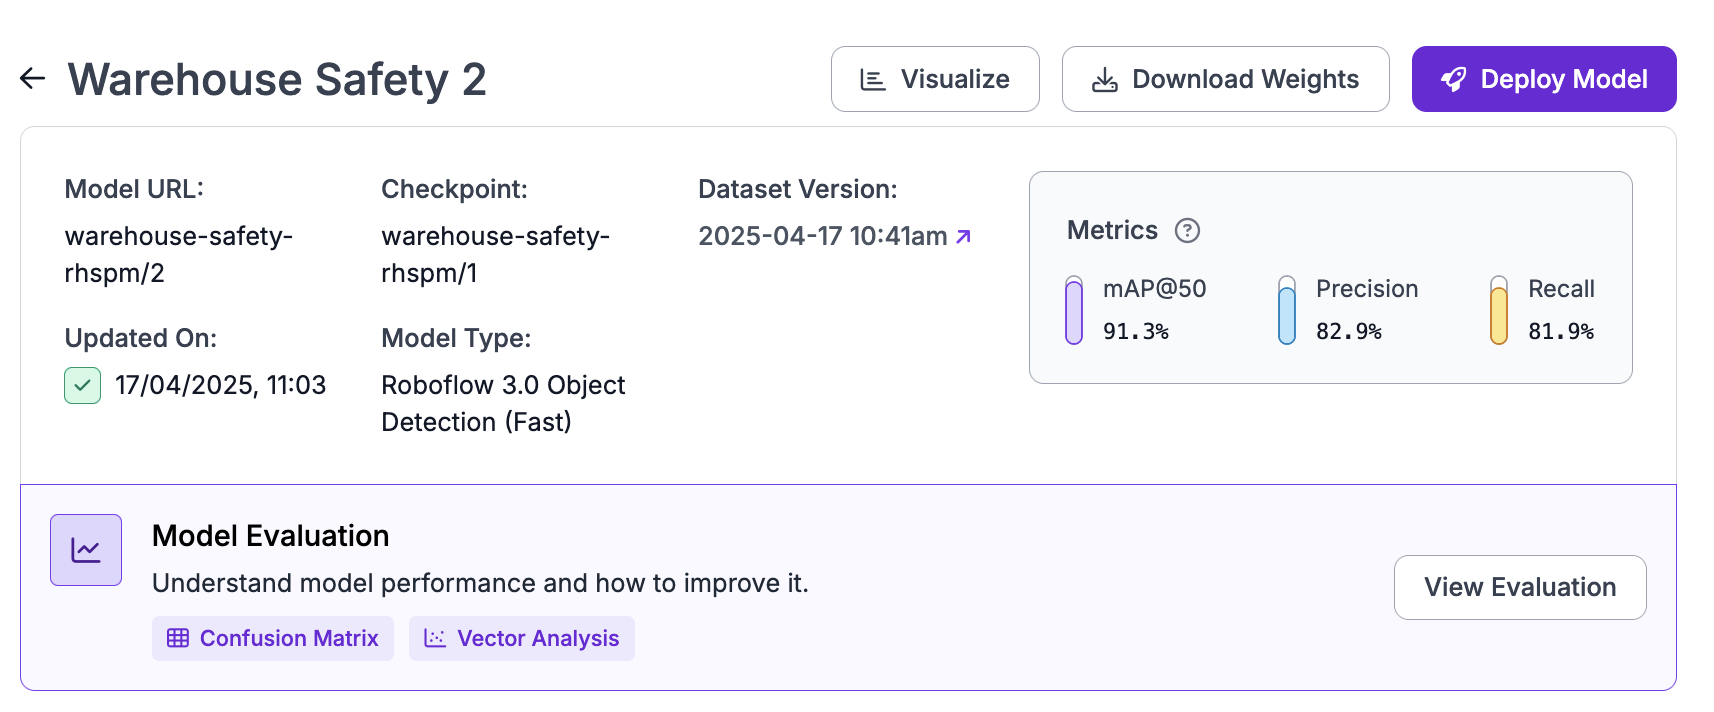
모델의 혼동 행렬 및 벡터 탐색기를 찾으려면 프로젝트에서 학습된 모델을 엽니다. 그런 다음 "평가 보기" 버튼을 클릭합니다:

<figure><img src="https://2225311784-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-8c6db60420e1905df8d6f3c824f91f0f219e8a76%2FScreenshot%202025-05-14%20at%2014.41.23.png?alt=media" alt=""><figcaption></figcaption></figure>

혼동 행렬과 벡터 분석을 볼 수 있는 창이 열립니다.

### 중앙값 지연 시간

평가는 테스트 이미지에서 측정한 Serverless Cloud API가 하나의 요청에 응답하는 데 걸리는 중앙값 시간을 보여 줍니다. 이 값에는 전처리 및 후처리 시간이 포함됩니다. 네트워크 시간은 포함되지 않습니다. 모델 목록 및 모델 카드에는 동일한 값이 "지연 시간(Cloud API)"으로 표시됩니다. 다음의 지연 시간은 [신경망 아키텍처 검색](/models/ko/train/neural-architecture-search.md) 벤치마크는 다른 방식으로 측정되므로 둘을 비교하지 마세요.

테스트 이미지에 모델 입력의 최소 두 배에 해당하는 픽셀이 포함된 경우, 평가에서는 캡처 해상도에 대한 권장 사항을 추가합니다. 서버는 모델을 실행하기 전에 모든 이미지를 디코딩하고 크기를 조정하므로, 긴 변이 모델 입력 크기에 가까운 프레임이 더 빠르게 응답합니다.

사용 [모델 비교](/models/ko/evaluate/compare-trained-models.md) 를 사용하여 동일한 데이터 세트 버전의 모델에 대한 테스트 세트 정확도와 지연 시간을 비교하세요.

### 프로덕션 메트릭 탐색기

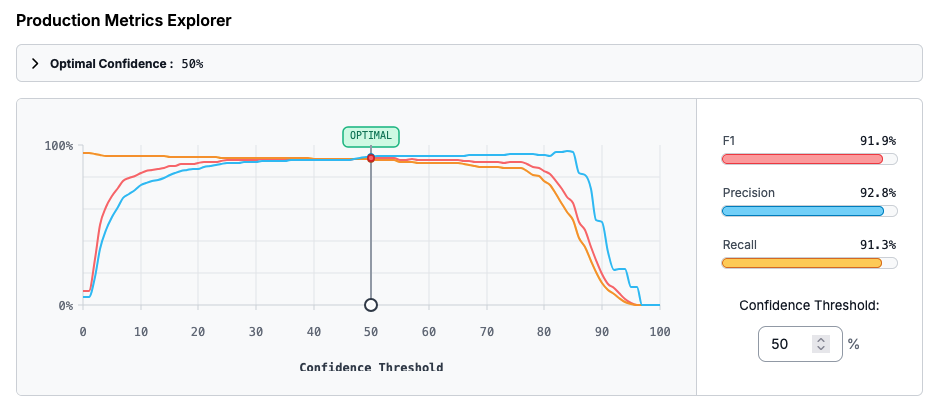
프로덕션 메트릭 탐색기는 가능한 모든 신뢰도 임계값에서 모델의 정밀도, 재현율 및 F1 점수를 보여 줍니다. 이 정보는 그래프로 표시됩니다.

이 통계를 사용하여 프로덕션 메트릭 탐색기는 "최적 신뢰도"를 권장합니다. 이는 정밀도/재현율/F1 점수 간 최상의 균형을 제공하는 임계값입니다.

모델 평가가 완료되면 최적 신뢰도 임계값이 모델의 추론 요청에 대한 기본값으로 자동 적용됩니다. 클래스별 임계값을 사용할 수 있는 경우 해당 값도 적용되며, 자체 값이 없는 클래스에는 전역 임계값이 대체값으로 사용됩니다.

여전히 다음을 전달하여 개별 추론 요청의 신뢰도 임계값을 재정의할 수 있습니다. `confidence` 매개변수를 명시적으로 지정합니다.

<figure><img src="https://2225311784-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-cf7be3e1155f28ab47c87709fe072e767b536898%2FScreenshot%202025-07-23%20at%2011.15.02.png?alt=media" alt=""><figcaption></figcaption></figure>

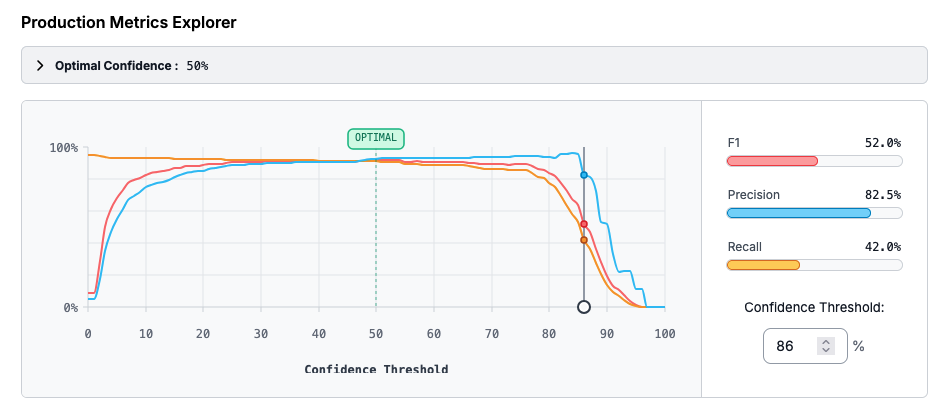
슬라이더를 드래그하여 서로 다른 신뢰도 임계값에서의 F1/정밀도/재현율 값을 확인할 수 있습니다:

<figure><img src="https://2225311784-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-c0f91bfa945e226cba1bdb659ef70c507779add8%2FScreenshot%202025-07-23%20at%2011.15.39.png?alt=media" alt=""><figcaption></figcaption></figure>

### 모델 개선 권장 사항

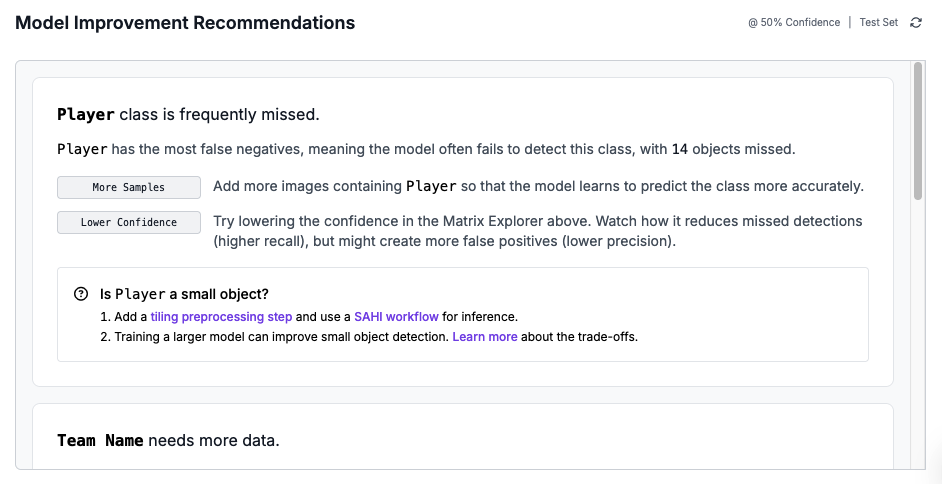
모델 평가의 모델 개선 권장 사항 섹션에는 모델의 정확도를 높일 수 있는 방법에 대한 제안이 나열됩니다. 이러한 개선 사항은 모델로 계산된 혼동 행렬의 결과를 기반으로 합니다. (이 페이지의 뒤쪽에서 혼동 행렬에 대한 자세한 정보를 확인하세요.)

모델 개선 권장 사항 기능은 다음과 관련된 제안을 제공할 수 있습니다:

* 많은 거짓 음성을 예측하는 모델을 개선하는 방법.
* 많은 거짓 양성을 예측하는 모델을 개선하는 방법.
* 자주 혼동되는(잘못 식별되는) 클래스.
* 정확도 개선을 위해 더 많은 데이터가 필요한 클래스.
* 테스트 또는 검증 세트가 너무 작을 수 있는 경우.
* 그 외 다양한 항목.

<figure><img src="https://2225311784-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-cb54b251f5e115f9a1eb549b0c03117d5b263b3b%2FScreenshot%202025-07-23%20at%2011.17.09.png?alt=media" alt=""><figcaption></figcaption></figure>

### 클래스별 성능

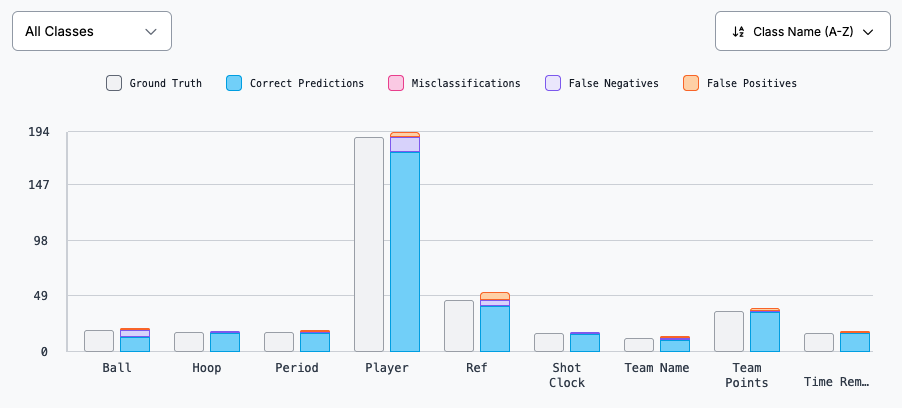
클래스별 성능 차트는 데이터 세트의 모든 클래스에 걸쳐 정확한 예측, 오분류, 거짓 음성 및 거짓 양성이 얼마나 있는지 보여 줍니다.

이 정보를 사용하면 모델이 잘 식별할 수 있는 클래스와 모델이 식별하기 어려워하는 클래스를 한눈에 확인할 수 있습니다.

<figure><img src="https://2225311784-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-ffaf491bbb2d955905c575d90aeb04a4fd94f257%2FScreenshot%202025-07-23%20at%2011.18.34.png?alt=media" alt=""><figcaption></figcaption></figure>

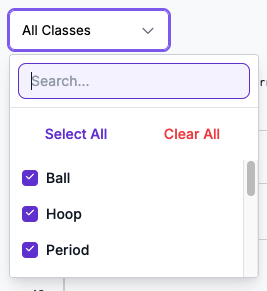
데이터 세트에 많은 클래스가 있는 경우 "모든 클래스" 드롭다운을 열고 강조할 클래스를 선택하여 특정 클래스에 차트를 집중할 수 있습니다:

<figure><img src="https://2225311784-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-9656c52d9fc2be6f7da56bcd9bd4f2538677dba3%2FScreenshot%202025-07-23%20at%2011.19.30.png?alt=media" alt=""><figcaption></figcaption></figure>

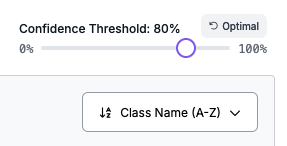
신뢰도 임계값 슬라이더를 움직여 서로 다른 신뢰도 임계값에서 이 차트가 어떻게 변하는지도 확인할 수 있습니다:

<figure><img src="https://2225311784-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-443ab7ce57aba56477ab17435cb9f27f622fe7c1%2FScreenshot%202025-07-23%20at%2011.20.12.png?alt=media" alt=""><figcaption></figcaption></figure>

기본적으로 이 차트는 권장하는 최적 신뢰도 임계값을 사용합니다.

### 혼동 행렬

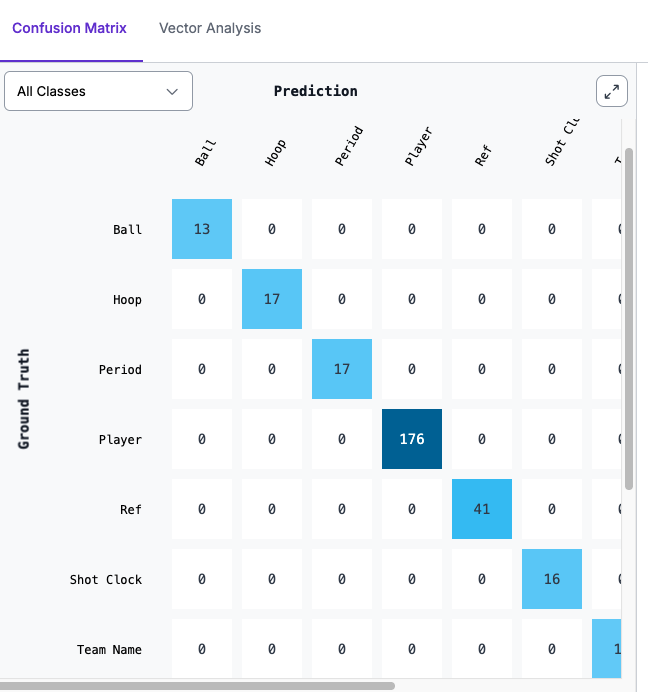
혼동 행렬은 모델이 서로 다른 클래스에서 얼마나 잘 수행되는지 보여 줍니다.

혼동 행렬은 학습된 모델로 테스트 및 검증 세트의 이미지를 실행하여 계산됩니다. 그런 다음 모델의 결과를 데이터 세트 주석의 "정답"과 비교합니다.

혼동 행렬 도구를 사용하면 다음을 식별할 수 있습니다:

* 모델 성능이 좋은 클래스.
* 모델이 객체에 대해 잘못된 클래스를 식별하는 클래스(거짓 양성).
* 실제로 객체가 없는데 모델이 객체를 식별하는 사례(거짓 음성).

다음은 혼동 행렬의 예입니다:

<figure><img src="https://2225311784-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-cd0af50fa3e0c4158310901798a285245a9d87bc%2FScreenshot%202025-07-23%20at%2011.20.53.png?alt=media" alt=""><figcaption></figcaption></figure>

모델이 많은 클래스를 감지하는 경우 혼동 행렬을 탐색할 수 있는 스크롤 막대가 표시됩니다.

기본적으로 혼동 행렬은 모델에 대해 계산된 최적 임계값으로 실행할 때의 모델 성능을 보여 줍니다.

신뢰도 임계값 슬라이더를 사용하여 신뢰도 임계값을 조정할 수 있습니다. 슬라이더를 구성하면 혼동 행렬, 정밀도 및 재현율이 업데이트됩니다:

<figure><img src="https://2225311784-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-37d06af76a4e8f6a660dec67c79f30d7d47e67ea%2FScreenshot%202025-07-23%20at%2011.21.19.png?alt=media" alt=""><figcaption></figcaption></figure>

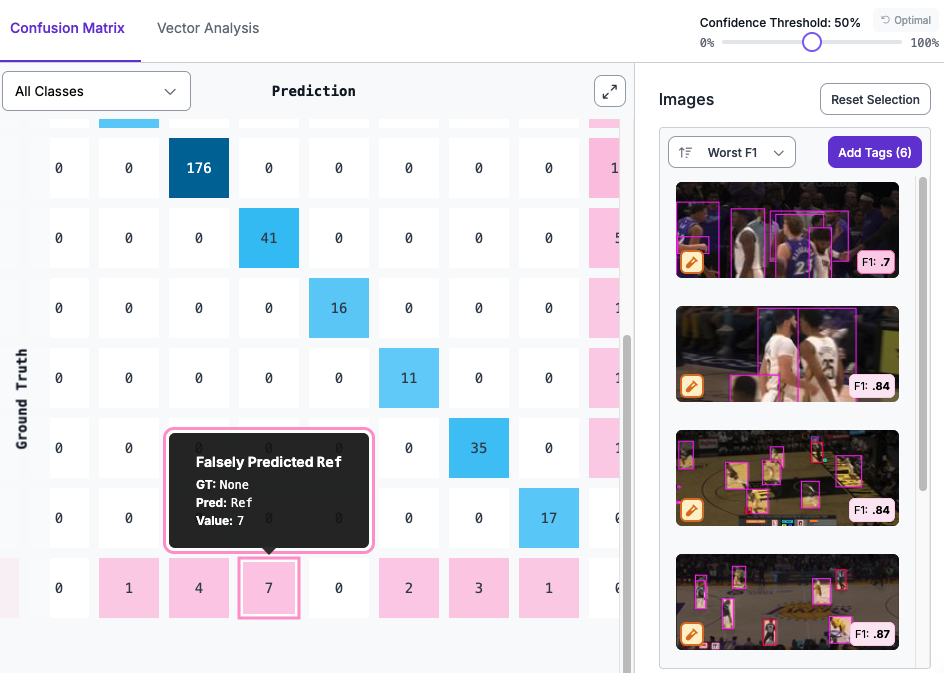
혼동 행렬의 각 상자를 클릭하여 해당 범주에 어떤 이미지가 표시되는지 확인할 수 있습니다.

예를 들어, "거짓 양성" 열의 아무 상자나 클릭하면 정답 데이터에는 존재하지 않는 객체가 식별된 이미지를 찾을 수 있습니다.

<figure><img src="https://2225311784-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-5372c962df1b4125d6d89098a5b43ea4df21e74c%2FScreenshot%202025-07-23%20at%2011.22.08.png?alt=media" alt=""><figcaption></figcaption></figure>

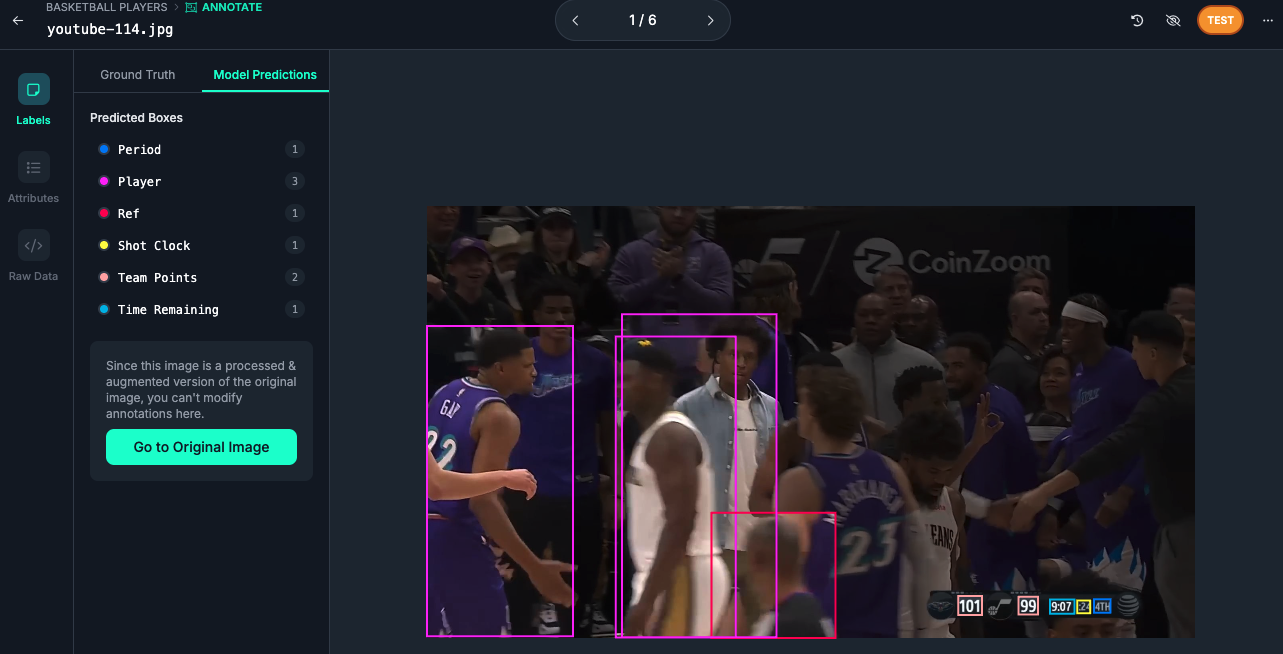
개별 이미지를 클릭하면 정답(주석)과 모델 예측 간을 전환할 수 있는 대화형 보기로 들어갈 수 있습니다:

<figure><img src="https://2225311784-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fcmo9mhfIjYrvFFy1U7dk%2Fuploads%2Fgit-blob-15edd76d7c3b4f61ddd86e3581a91b90f0b72608%2FScreenshot%202025-07-23%20at%2011.22.30.png?alt=media" alt=""><figcaption></figcaption></figure>

"정답"을 클릭하면 주석을 보고, "모델 예측"을 클릭하면 모델이 반환한 결과를 볼 수 있습니다.

## HTTP API

모델 평가는 버전의 테스트 분할에서 모델이 어떻게 수행되는지 캡처합니다. 여기에는 클래스별 지표, 신뢰도 임계값 곡선, 이미지 임베딩 클러스터링, 이미지별 예측 및 개선 권장 사항이 포함됩니다. 객체 감지 및 인스턴스 분할의 주요 지표는 mAP이고, 시맨틱 분할의 주요 지표는 mIoU입니다. 평가는 학습 완료 시 자동으로 생성되며 앱에서 수동으로 다시 실행할 수 있습니다.

모델 평가 API를 사용하면 앱의 평가 페이지에 표시되는 모든 내용을 읽을 수 있습니다. UI의 각 패널은 전용 엔드포인트에 매핑됩니다:

* [워크스페이스의 모델 평가 나열](#list-model-evaluations)
* [하나의 평가 메타데이터 및 주요 지표 가져오기](#get-a-model-evaluation)
* [분할별 전체 지표 세부 정보 가져오기(mAP 또는 mIoU)](#map-results)
* [신뢰도 임계값 스윕 및 F1 최적 임계값 가져오기](#confidence-sweep)
* [한 분할의 클래스별 성능 가져오기](#performance-by-class-1)
* [혼동 행렬 가져오기](#confusion-matrix-1)
* [이미지 임베딩 클러스터링(벡터 분석) 가져오기](#vector-analysis)
* [이미지별 예측 가져오기](#per-image-predictions)
* [모델 개선 권장 사항 가져오기](#recommendations)

### 인증

모든 엔드포인트에는 다음 범위를 가진 API 키가 필요합니다. `model-eval:read` 범위입니다. 이를 쿼리 매개변수 또는 다음의 `Bearer` 토큰으로 `Authorization` 헤더에 전달하세요.

### 일반적인 오류

| 상태    | 오류 코드                  | 발생 시점                                          |
| ----- | ---------------------- | ---------------------------------------------- |
| `401` | unauthenticated        | API 키가 없거나 유효하지 않음                             |
| `404` | `model_eval_not_found` | 평가가 존재하지 않거나 다른 워크스페이스에 속함                     |
| `409` | `model_eval_not_done`  | 평가가 완료되지 않았으며 패널 데이터를 아직 사용할 수 없음              |
| `400` | `invalid_confidence`   | `confidence` 쿼리 매개변수가 다음 범위의 정수가 아님 `[0, 100]` |
| `400` | `invalid_split`        | `split` 쿼리 매개변수가 엔드포인트에 허용된 값 중 하나가 아님         |

### 모델 평가 나열

워크스페이스의 모델 평가를 나열합니다. 간소화된 프로젝션을 반환합니다. 특정 평가의 주요 지표는 다음을 이어서 호출하세요. [모델 평가 가져오기](#get-a-model-evaluation).

```url
https://api.roboflow.com/:workspace/model-evals
```

```bash
curl "https://api.roboflow.com/my-workspace/model-evals?api_key=$ROBOFLOW_API_KEY&status=done&limit=10"
```

#### 쿼리 매개변수

| 매개변수                       | 유형  | 설명                                                                                                          |
| -------------------------- | --- | ----------------------------------------------------------------------------------------------------------- |
| `project`                  | 문자열 | URL 슬러그로 프로젝트 필터링(예: `chess-pieces-fmhpz`)                                                                  |
| `version` (별칭 `versionId`) | 문자열 | 특정 버전으로 필터링(예: `"4"`)                                                                                       |
| `model` (별칭 `modelId`)     | 문자열 | 워크스페이스 접두사 포함 여부와 관계없이 URL 슬러그 ID로 모델 필터링(예: `my-workspace/chess-pieces-fmhpz-2` 또는 `chess-pieces-fmhpz-2`) |
| `status`                   | 열거형 | 다음 중 하나 `pending`, `running`, `done`, `failed`. 알 수 없는 값은 다음을 반환합니다 `400`.                                  |
| `limit`                    | 정수  | 페이지 크기; 기본값 `50`, 최대 `200`                                                                                  |

호출당 다음 중 최대 하나만 `project` / `version` / `model` 설정할 수 있습니다(가장 구체적인 항목이 우선: `model` > `version` > `project`). 조합은 다음과 함께 거부됩니다 `400 invalid_filter_combination` 저장소 인덱스를 제한된 상태로 유지하기 위해서입니다.

#### 응답

```json
{
    "evals": [
        {
            "evalId": "huUF720inUcymARwqAGK",
            "status": "done",
            "project": "chess-pieces-fmhpz",
            "versionId": "4",
            "modelId": "my-workspace/chess-pieces-fmhpz-2",
            "createdAt": "2026-04-27T20:04:10.904Z",
            "medianLatencyMs": 11.9
        }
    ]
}
```

`project` 는 프로젝트의 URL 슬러그이며 REST API가 URL 경로에서 사용하는 것과 동일한 식별자입니다(`/:workspace/:project/...`). 평가 UI로 딥링크하려면: `https://app.roboflow.com/{workspace}/{project}/evaluation/{versionId}`.

`modelId` 는 모델의 URL 슬러그 ID이며, 모델 및 추론 엔드포인트에 전달하는 것과 동일한 ID이므로 문자열을 비교하여 평가를 모델에 매칭할 수 있습니다. 단일 모델이 아니라 버전에서 실행된 평가는 다음을 보고합니다 `{project}/{versionId}` 대신.

`medianLatencyMs` 는 밀리초 단위의 Serverless Cloud API 서버 측 중앙값 시간입니다. 이는 `null` 평가에서 이를 측정하지 않은 경우입니다.

### 모델 평가 가져오기

ID로 단일 모델 평가를 가져옵니다. 완료된 평가의 경우 응답에는 다음이 포함됩니다. `summary` 주요 지표가 포함된 객체입니다. 보류 중, 실행 중 및 실패한 평가는 간소화된 형태만 반환합니다. 채워지는 주요 지표는 작업 유형에 따라 달라집니다 - `mAP` 감지 형태 작업의 경우, `mIoU` 시맨틱 분할의 경우.

```url
https://api.roboflow.com/:workspace/model-evals/:evalId
```

```bash
curl "https://api.roboflow.com/my-workspace/model-evals/huUF720inUcymARwqAGK?api_key=$ROBOFLOW_API_KEY"
```

#### 응답(완료된 평가)

```json
{
    "evalId": "huUF720inUcymARwqAGK",
    "status": "done",
    "project": "chess-pieces-fmhpz",
    "versionId": "4",
    "modelId": "my-workspace/chess-pieces-fmhpz-2",
    "createdAt": "2026-04-27T20:04:10.904Z",
    "summary": {
        "mAP": 0.9239650566041828,
        "mIoU": null,
        "precision": 0.85,
        "recall": 0.85,
        "medianLatencyMs": 11.9
    }
}
```

#### 응답(보류 중, 실행 중 또는 실패)

다음을 제외한 동일한 필드 `summary` 블록.

```json
{
    "evalId": "fNyWx6PC74rCc18IuZ3M",
    "status": "running",
    "project": "hard-hat-detection",
    "versionId": "1",
    "modelId": "hard-hat-detection/1",
    "createdAt": "2026-03-19T21:02:07.918Z"
}
```

#### 참고

* `mAP` 는 IoU 0.5에서의 평균 정밀도입니다(`map50`). 이는 `null` 비감지 평가 작업(예: 분류, 시맨틱 분할)의 경우입니다.
* `mIoU` 는 전경 매크로 평균 교집합-합집합 비율입니다. 시맨틱 분할 평가에만 채워지며 `null` 그 외의 경우입니다.
* `precision` 및 `recall` 은 테스트 분할의 F1 최적 신뢰도 임계값에서 보고됩니다.
* `medianLatencyMs` 는 테스트 분할 이미지 최대 500장에서 측정한 밀리초 단위의 Serverless Cloud API 서버 측 중앙값 시간입니다. 전처리 및 후처리 시간이 포함되며 네트워크 시간은 제외됩니다. 이는 `null` 평가에서 이를 측정하지 않은 경우입니다.
* `status` 는 `pending` 평가가 추론용 모델 컴파일을 기다리는 동안입니다. 다음으로 이동합니다 `running` 평가 작업이 시작될 때.
* `evalId` 는 모든 패널 응답에 포함된 동일한 식별자입니다. 다음 `modelEvals.get` 페이로드는 모든 패널 페이로드의 구조적 상위 집합이므로 `summary`-보강된 `modelEvals.get` 및 `getMapResults` 응답은 동일한 클라이언트 코드 경로를 통해 렌더링될 수 있습니다.
* `project` 는 프로젝트의 URL 슬러그이며 REST API가 URL 경로에서 사용하는 것과 동일한 식별자입니다. 평가 UI로 딥링크하려면: `https://app.roboflow.com/{workspace}/{project}/evaluation/{versionId}`. `project` 는 `null` 프로젝트가 삭제된 경우입니다.
* `modelId` 는 모델의 URL 슬러그 ID(`{workspace}/{model}`) 또는 `{project}/{versionId}` 단일 모델이 아닌 버전에서 실행된 평가의 경우입니다. 이는 `null` 모델을 더 이상 확인할 수 없는 경우입니다.

### 맵 결과

평가의 기본 지표 세부 정보를 반환합니다. 응답 형태는 작업 유형에 따라 달라집니다:

* **객체 감지 / 인스턴스 분할** - 분할별 IoU 0.5 / 0.5-0.95 / 0.75에서의 mAP이며, 객체 크기 및 클래스별로 세분화됩니다.
* **시맨틱 분할** - 분할별 mIoU, 정밀도, 재현율, F1(픽셀 수준) 및 클래스별 IoU와 최적 신뢰도 임계값.

응답의 `taskType` 필드는 예상할 응답 형태를 나타냅니다: `"object-detection-like"` 또는 `"semantic-segmentation"`.

이는 앱의 **분할별 지표** 패널이 읽는 데이터입니다.

```url
https://api.roboflow.com/:workspace/model-evals/:evalId/map-results
```

```bash
curl "https://api.roboflow.com/my-workspace/model-evals/$EVAL_ID/map-results?api_key=$ROBOFLOW_API_KEY"
```

#### 응답(객체 감지 / 인스턴스 분할)

```json
{
    "taskType": "object-detection-like",
    "splits": {
        "test": {
            "map50": 0.9239650566041828,
            "map50_95": 0.7555258345429926,
            "map75": 0.9239650566041828,
            "byObjectSize": {
                "small": {
                    "map50": 0.9038189533239035,
                    "map50_95": 0.6478143732740621,
                    "map75": 0.9038189533239035
                },
                "medium": {
                    "map50": 0.9913366336633663,
                    "map50_95": 0.8572608399609195,
                    "map75": 0.9913366336633663
                },
                "large": null
            },
            "perClass": {
                "Car-rims": {
                    "map50": 0.9239650566041828,
                    "map50_95": 0.7555258345429926,
                    "map75": 0.9239650566041828,
                    "byObjectSize": {
                        "small": { "map50": 0.9, "map50_95": 0.65, "map75": 0.85 },
                        "medium": { "map50": 0.99, "map50_95": 0.85, "map75": 0.99 },
                        "large": null
                    }
                }
            }
        },
        "valid": { "...": "동일한 형태" },
        "train": { "...": "동일한 형태" }
    }
}
```

#### 응답(시맨틱 분할)

```json
{
    "taskType": "semantic-segmentation",
    "splits": {
        "test": {
            "miou": 0.816,
            "precision": 0.938,
            "recall": 0.862,
            "f1": 0.898,
            "perClass": [
                {
                    "classID": 3,
                    "className": "multi",
                    "iou": 0.816,
                    "precision": 0.938,
                    "recall": 0.862,
                    "f1": 0.898,
                    "optimalThreshold": 0.0
                }
            ]
        },
        "valid": { "...": "동일한 형태" },
        "train": { "...": "동일한 형태" }
    }
}
```

#### 참고

* 응답의 `taskType` 필드는 응답 형태를 구분합니다. 분할 내용을 파싱하기 전에 항상 확인하세요.
* **감지:** `map50_95` 는 0.5부터 0.95까지 0.05 단위의 IoU 임계값에 대해 평균을 낸 mAP입니다(COCO 표준). 객체 크기 버킷은 `null` 분할에 해당 크기의 인스턴스가 없을 때입니다. 클래스별 항목은 다음 아래에 표시됩니다 `perClass`, 클래스 이름을 키로 사용합니다.
* **시맨틱 분할:** 모든 지표는 전경 클래스에 대한 픽셀 수준 매크로 평균입니다(배경 제외). `miou` 는 평균 교집합-합집합 비율입니다. `optimalThreshold` 는 클래스별 F1 최적 신뢰도 임계값입니다. 다음 값은 `0.0` 유효하며 모델이 argmax에서 최고 성능을 낸다는 의미입니다.

### 신뢰도 스윕

신뢰도 임계값별 지표 곡선과 분할별(및 클래스별) F1 최적 임계값을 반환합니다. 정밀도/재현율 간의 균형을 시각화하고 배포 시점 임계값을 선택하는 데 유용합니다.

이는 앱의 **프로덕션 메트릭 탐색기** 패널이 읽는 데이터입니다.

```url
https://api.roboflow.com/:workspace/model-evals/:evalId/confidence-sweep
```

```bash
curl "https://api.roboflow.com/my-workspace/model-evals/$EVAL_ID/confidence-sweep?api_key=$ROBOFLOW_API_KEY"
```

#### 응답

```json
{
    "splits": {
        "test": {
            "perThreshold": {
                "0.00": { "precision": 0.02, "recall": 1.0,  "f1": 0.039 },
                "0.20": { "precision": 0.45, "recall": 0.92, "f1": 0.605 },
                "0.37": { "precision": 0.85, "recall": 0.85, "f1": 0.85 },
                "0.50": { "precision": 0.91, "recall": 0.78, "f1": 0.84 }
            },
            "optimalThreshold": 0.37,
            "optimalMetrics": {
                "precision": 0.85,
                "recall": 0.85,
                "f1": 0.85
            },
            "perClass": {
                "Car-rims": {
                    "perThreshold": { "0.37": { "precision": 0.85, "recall": 0.85, "f1": 0.85 } },
                    "optimalThreshold": 0.37,
                    "optimalMetrics": { "precision": 0.85, "recall": 0.85, "f1": 0.85 }
                }
            }
        },
        "valid": { "...": "동일한 형태" },
        "train": { "...": "동일한 형태" }
    }
}
```

#### 참고

* `perThreshold` 키는 10진수 문자열 형식의 신뢰도 임계값이며, 일반적으로 매 `0.01` 부터 `0.00` 까지 `0.99`.
* `optimalThreshold` 는 해당 분할에서 F1을 최대화하는 임계값입니다.
* 분할의 다음 내부 클래스별 항목 `perClass` 은 중첩된 항목을 제외하면 동일한 형태입니다 `perClass`.

### 클래스별 성능

한 분할에 대한 클래스별 핵심 지표를 반환합니다. 응답 형식은 평가의 작업 유형에 따라 달라집니다:

* **객체 감지 / 인스턴스 분할** - 클래스별 `map50`, `map50_95`, `map75`, 정밀도, 재현율, F1, 및 최적 임계값.
* **시맨틱 분할** - 클래스별 `iou`, 정밀도, 재현율, F1, 및 최적 임계값(픽셀 수준).

응답의 `taskType` 응답의 필드는 어떤 형식을 예상해야 하는지 나타냅니다.

이는 앱의 **클래스별 성능** 패널이 읽는 데이터입니다.

```url
https://api.roboflow.com/:workspace/model-evals/:evalId/performance-by-class
```

```bash
curl "https://api.roboflow.com/my-workspace/model-evals/$EVAL_ID/performance-by-class?api_key=$ROBOFLOW_API_KEY&split=test"
```

#### 쿼리 매개변수

| 매개변수    | 유형  | 설명                                                                                              |
| ------- | --- | ----------------------------------------------------------------------------------------------- |
| `split` | 열거형 | 다음 중 하나 `훈련`, `검증`, `테스트`. 기본값 `테스트`. `전체` 는 **아님** 여기서는 유효하지 않습니다 - 클래스별 지표는 분할 간에 집계할 수 없습니다. |

#### 응답(객체 감지 / 인스턴스 분할)

```json
{
    "taskType": "object-detection-like",
    "split": "test",
    "classes": [
        {
            "className": "Car-rims",
            "map50": 0.9239650566041828,
            "map50_95": 0.7555258345429926,
            "map75": 0.9239650566041828,
            "precision": 0.85,
            "recall": 0.85,
            "f1": 0.85,
            "optimalThreshold": 0.37
        },
        {
            "className": "music-note",
            "map50": null,
            "map50_95": null,
            "map75": null,
            "precision": 0,
            "recall": 0,
            "f1": 0,
            "optimalThreshold": 0.5
        }
    ]
}
```

#### 응답(시맨틱 분할)

```json
{
    "taskType": "semantic-segmentation",
    "split": "test",
    "classes": [
        {
            "classID": 3,
            "className": "multi",
            "iou": 0.816,
            "precision": 0.938,
            "recall": 0.862,
            "f1": 0.898,
            "optimalThreshold": 0.0
        }
    ]
}
```

#### 참고

* `taskType` 클래스별 필드 집합을 구분합니다. 탐지 클래스에는 `map50`/`map50_95`/`map75`; 시맨틱 세그멘테이션 클래스에는 `iou` 및 `classID` 대신.
* `optimalThreshold` 신뢰도 스윕에서 얻은 클래스별 F1 최적 신뢰도 임계값입니다.
* `precision`, `recall`, 그리고 `f1` 는 해당 클래스별 최적 임계값에서 보고됩니다.
* 탐지의 경우 mAP 필드는 `null` 해당 분할에 그 클래스의 인스턴스가 없을 때.
* 시맨틱 세그멘테이션의 경우 모든 지표는 픽셀 수준입니다. 하나의 `optimalThreshold` 의 `0.0` 가 유효합니다.

### 혼동 행렬

이미지별 예측에서 파생된 집계 혼동 행렬을 반환합니다. 각 셀은 `matrix[actual][predicted]` 실제 정답 클래스가 `실제` 이고 모델이 `예측`한 인스턴스 수를 나타냅니다. 시맨틱 세그멘테이션 평가에서는 값이 인스턴스 수가 아니라 픽셀 수를 나타냅니다.

이는 앱의 **혼동 행렬** 패널이 읽는 데이터입니다.

```url
https://api.roboflow.com/:workspace/model-evals/:evalId/confusion-matrix
```

```bash
curl "https://api.roboflow.com/my-workspace/model-evals/$EVAL_ID/confusion-matrix?api_key=$ROBOFLOW_API_KEY&split=test"
```

#### 쿼리 매개변수

| 매개변수         | 유형  | 설명                                                   |
| ------------ | --- | ---------------------------------------------------- |
| `split`      | 열거형 | 다음 중 하나 `훈련`, `검증`, `테스트`, 또는 `전체`. 기본값 `테스트`.       |
| `confidence` | 정수  | 신뢰도 임계값 퍼센티지는 `[0, 100]`. 기본값은 정식 파일입니다(일반적으로 `20`). |

#### 응답

```json
{
    "split": "test",
    "confidenceThreshold": 0.2,
    "classes": ["Car-rims", "music-note", "background"],
    "matrix": [
        [20,  0, 0],
        [ 0,  0, 0],
        [80,  0, 0]
    ]
}
```

위 예에서는 신뢰도 임계값 0.2에서:

* 모든 20개의 `Car-rims` 가 올바르게 분류되었습니다(`matrix[0][0] = 20`)
* 모델이 80개의 거짓 양성을 생성했습니다 - 예측한 대상은 `Car-rims` 실제 클래스가 `background` (`matrix[2][0] = 80`)
* 테스트 분할에는 `music-note` 인스턴스가 없습니다

#### 참고

* `confidence` 보고서의 어떤 내부 per-confidence 변형을 집계할지 선택합니다. 서로 다른 임계값은 서로 다른 행렬을 산출합니다.
* `split=all` 훈련, 검증, 테스트 전반의 원시 카운트를 집계합니다.

### 벡터 분석

평가에 대한 이미지 임베딩 클러스터링 결과를 반환합니다 - UMAP으로 투영된 임베딩을 HDBSCAN으로 클러스터링하며, 클러스터별 집계 지표를 제공합니다. 모델이 체계적으로 더 잘 또는 더 나쁘게 수행하는 이미지 그룹을 찾는 데 유용합니다.

이는 앱의 **벡터 분석** 패널이 읽는 데이터입니다.

```url
https://api.roboflow.com/:workspace/model-evals/:evalId/vector-analysis
```

```bash
curl "https://api.roboflow.com/my-workspace/model-evals/$EVAL_ID/vector-analysis?api_key=$ROBOFLOW_API_KEY"
```

#### 쿼리 매개변수

| 매개변수         | 유형 | 설명                                         |
| ------------ | -- | ------------------------------------------ |
| `confidence` | 정수 | 신뢰도 임계값 퍼센티지는 `[0, 100]` (기본값은 정식 보고서입니다). |

#### 응답

```json
{
    "clustering": {
        "method": "hdbscan",
        "nClusters": 54,
        "metrics": {
            "noiseRatio": 0.078125,
            "silhouetteScore": 0.48925095796585083
        },
        "parameters": {
            "min_cluster_size": 2,
            "min_samples": 1,
            "cluster_selection_method": "eom",
            "metric": "euclidean"
        },
        "processingTimeSeconds": 8.36
    },
    "preprocessing": {
        "method": "umap",
        "originalDimensions": 768,
        "targetDimensions": 10,
        "nNeighbors": 30,
        "minDistance": 0.05
    },
    "clusters": [
        {
            "id": -1,
            "numImages": 15,
            "splitDistribution": { "train": 12, "valid": 2, "test": 1 },
            "metrics": {
                "f1Mean": 0.462,
                "f1Std": 0.219,
                "f1Min": 0.129,
                "f1Max": 0.8,
                "precisionMean": 0.330,
                "recallMean": 0.952
            },
            "sampleImages": ["img1.jpg", "img2.jpg"]
        },
        {
            "id": 0,
            "numImages": 3,
            "splitDistribution": { "train": 2, "valid": 1 },
            "metrics": {
                "f1Mean": 0.889,
                "f1Std": 0.157,
                "f1Min": 0.667,
                "f1Max": 1.0,
                "precisionMean": 1.0,
                "recallMean": 0.833
            },
            "sampleImages": ["img3.jpg", "img4.jpg", "img5.jpg"]
        }
    ]
}
```

#### 참고

* 클러스터 ID `-1` 는 노이즈/미클러스터 버킷(HDBSCAN 관례)입니다 - 어떤 밀집 영역에도 들어맞지 않는 이미지들.
* `평균 정밀도` 및 `평균 재현율` 는 클러스터의 모든 이미지에 대해 평균화됩니다.
* 이미지별 임베딩과 클러스터 할당은 다음을 통해 제공됩니다: [이미지별 예측](#per-image-predictions).

### 이미지별 예측

이미지별 예측 기록을 반환합니다 - TP/FP/FN 수, 이미지별 정밀도/재현율/F1, 이미지의 클러스터 ID와 2D 임베딩, 그리고 원시 혼동 항목을 포함합니다. 페이지네이션됩니다.

이는 앱의 **이미지별 예측** 패널이 읽는 데이터입니다.

```url
https://api.roboflow.com/:workspace/model-evals/:evalId/image-predictions
```

```bash
curl "https://api.roboflow.com/my-workspace/model-evals/$EVAL_ID/image-predictions?api_key=$ROBOFLOW_API_KEY&split=test&limit=50"
```

#### 쿼리 매개변수

| 매개변수         | 유형  | 설명                                                              |
| ------------ | --- | --------------------------------------------------------------- |
| `split`      | 열거형 | 다음 중 하나 `훈련`, `검증`, `테스트`, 또는 `전체`. 기본값 `전체`.                   |
| `confidence` | 정수  | 신뢰도 임계값 퍼센티지는 `[0, 100]` (어떤 per-confidence 보고서 변형을 읽을지 선택합니다). |
| `limit`      | 정수  | 페이지 크기; 기본값 `200`, 최대 `1000`.                                   |
| `offset`     | 정수  | 반환하기 전에 이만큼의 레코드를 건너뜁니다. 기본값 `0`.                               |

#### 응답

```json
{
    "split": "test",
    "confidenceThreshold": 0.2,
    "totalImages": 192,
    "offset": 0,
    "limit": 50,
    "images": [
        {
            "imageId": "1QKLCUsfAzFiCIb6YCJj",
            "imageName": "abc.jpg",
            "split": "test",
            "augmentations": 2,
            "cluster": {
                "id": 4,
                "embedding2D": [7.494518280029297, -5.143994331359863]
            },
            "stats": {
                "truePositives": 2,
                "falsePositives": 7,
                "falseNegatives": 0,
                "precision": 0.222,
                "recall": 1.0,
                "f1": 0.364
            },
            "confusion": [
                [0, 0, 2],
                [2, 0, 7]
            ]
        }
    ]
}
```

#### 참고

* `이미지 ID` 는 Roboflow 소스 이미지 ID입니다 - 다른 Roboflow API와 대조할 때 유용합니다.
* `혼동` 항목은 `[actualClassIdx, predictedClassIdx, count]` 삼중 항목입니다; 클래스 인덱스는 [혼동 행렬](#confusion-matrix-1)의 `클래스`.
* `embedding2D` 는 [벡터 분석](#vector-analysis) 플롯에 사용되는 UMAP 투영 2D 좌표입니다.
* 다른 `confidence` 값은 서로 다른 통계를 반환합니다 - 예측은 임계값에 따라 달라집니다. 임의의 `confidence` 값을 검사하는 것은 평가 파이프라인이 생성한 임계값에 대해서만 성공합니다; 생성되지 않은 변형은 `404 report_not_found`.
* **페이지네이션 비용**: 각 페이지는 전체 `model_eval_results.json` 를 스토리지에서 다시 읽어 서버 측에서 분할합니다. 매우 큰 `image_results` 배열이 있는 평가의 경우, 페이지당 고정 비용을 최소화하려면 많은 작은 페이지보다 더 큰 `limit` 값(최대 `1000`)을 선호하세요.

### 권장 사항

완료된 평가에서 생성된 모델 개선 권장 사항을 반환합니다 - 클래스 불균형 경고, 놓친 탐지 패턴, 그리고 데이터셋에 추가하거나 재학습할 내용에 대한 기타 실행 가능한 제안을 포함합니다.

이는 앱의 **모델 개선 권장 사항** 패널이 읽는 데이터입니다.

이 엔드포인트는 **읽기 전용입니다**. 권장 사항은 학습 완료의 부수 효과로 생성되며(또는 기존 앱 내 "권장 사항 새로고침" 작업을 통해 생성됩니다). 아직 생성되지 않았다면 응답은 `200 {"generated": false}` - 참고로 이것은 **아님** 하나의 `409 EVAL_NOT_DONE`. 평가는 *는* 완료되었다는 뜻일 뿐, 선택적 권장 사항 부가 출력이 없다는 뜻입니다. 다른 패널 엔드포인트(`map-results`, `confidence-sweep`, 등)은 `409 EVAL_NOT_DONE` 그 기반 데이터가 누락되었을 때 해당 데이터를 반환합니다. 왜냐하면 그 데이터는 평가의 고유한 일부이지만 권장 사항은 그렇지 않기 때문입니다.

```url
https://api.roboflow.com/:workspace/model-evals/:evalId/recommendations
```

```bash
curl "https://api.roboflow.com/my-workspace/model-evals/$EVAL_ID/recommendations?api_key=$ROBOFLOW_API_KEY"
```

#### 응답(권장 사항 사용 가능)

```json
{
    "generated": true,
    "generatedAt": "2026-04-27T20:05:37.512Z",
    "recommendations": {
        "summary": {
            "confidenceThreshold": 37,
            "split": "test",
            "generatedAt": "2026-04-27T20:05:37.512Z",
            "count": 3,
            "f1": 0.85,
            "precision": 0.85,
            "recall": 0.85
        },
        "items": [
            {
                "id": "56bcd423-38ff-45f9-b3e0-662a71ce44e6",
                "type": "missed_detection",
                "analysis": {
                    "affected_class": "Car-rims",
                    "count": 3
                }
            },
            {
                "id": "150e49a8-3a61-479a-9e18-3eb751494a70",
                "type": "class_imbalance",
                "analysis": {
                    "affected_class": "Car-rims",
                    "current_count": 20,
                    "total_gt_instances": 20,
                    "median_count": 10
                }
            }
        ]
    }
}
```

#### 응답(아직 생성되지 않음)

```json
{
    "generated": false
}
```

## MCP 서버

당신의 AI 에이전트를 [MCP 서버](https://docs.roboflow.com/agents/mcp-server) 에 연결하면 다음 도구로 모델의 성능을 검토할 수 있습니다:

<table data-search="false"><thead><tr><th width="290">도구</th><th>설명</th></tr></thead><tbody><tr><td><code>model_evals_list</code></td><td>워크스페이스의 모델 평가 목록을 가져옵니다.</td></tr><tr><td><code>model_evals_get</code></td><td>하나의 평가에 대한 최상위 요약을 가져옵니다.</td></tr><tr><td><code>model_evals_get_map_results</code></td><td>분할별 mAP 결과를 가져옵니다.</td></tr><tr><td><code>model_evals_get_confusion_matrix</code></td><td>혼동 행렬을 가져옵니다.</td></tr><tr><td><code>model_evals_get_performance_by_class</code></td><td>하나의 분할에 대한 클래스별 성능 지표를 가져옵니다.</td></tr><tr><td><code>model_evals_get_recommendations</code></td><td>사용 가능한 경우, 평가에 대해 생성된 권장 사항을 가져옵니다.</td></tr></tbody></table>
