
Inference Pipeline
InferencePipeline के साथ video streams पर models चलाएँ: video sources, custom inference logic, Workflows, और sinks।
InferencePipeline में प्रत्यक्ष, इन-प्रोसेस वीडियो इंटरफ़ेस है इन्फ़रेंस पायथन पैकेज। इसका उपयोग तब करें जब आपका अनुप्रयोग Inference लाइब्रेरी को एम्बेड करता है और वीडियो फ़्रेम, कस्टम इन्फ़रेंस लॉजिक, या सिंक तक सीधे Python पहुँच की आवश्यकता होती है।
उन अनुप्रयोगों के लिए जो स्वयं-होस्टेड Inference Server चलाते हैं, इसका उपयोग करें Inference SDK WebRTC client के बजाय। नए प्रबंधित लाइव-कैमरा प्रोसेसिंग के लिए, उपयोग करें क्लाउड स्ट्रीमिंग.
त्वरित शुरुआत
Inference के साथ fine-tuned मॉडल का उपयोग करने के लिए, आपको Roboflow API key की आवश्यकता होगी। यदि आपके पास पहले से Roboflow खाता नहीं है, मुफ़्त Roboflow खाता बनाएं। फिर, Roboflow डैशबोर्ड से अपनी API key प्राप्त करें और उसे अपने कोडिंग परिवेश में सेट करें:
export ROBOFLOW_API_KEY=<your api key>Roboflow API key के बारे में और जानें.
फिर, Inference इंस्टॉल करें:
pip install inferenceयदि आपके पास NVIDIA GPU है, तो आप अपने इन्फ़रेंस को इस तरह तेज़ कर सकते हैं:
pip install --extra-index-url https://download.pytorch.org/whl/cu124 inference-gpu
# कृपया --extra-index-url को अपने OS में इंस्टॉल किए गए CUDA संस्करण के अनुसार समायोजित करें
इसके बाद, एक Inference Pipeline बनाएँ:
# InferencePipeline इंटरफ़ेस import करें
from inference import InferencePipeline
# render_boxes नामक built-in sink import करें (sinks वह लॉजिक हैं जो inference के बाद होता है)
from inference.core.interfaces.stream.sinks import render_boxes

api_key = "YOUR_ROBOFLOW_API_KEY"

# एक inference pipeline ऑब्जेक्ट बनाएँ
pipeline = InferencePipeline.init(
    # model id को rfdetr मॉडल पर सेट करें (COCO पर pre-trained)
    model_id="rfdetr-large",
    # वीडियो संदर्भ (वीडियो का स्रोत) सेट करें; यह वीडियो फ़ाइल का लिंक/पथ, RTSP stream URL,
    # या डिवाइस ID दर्शाने वाला पूर्णांक हो सकता है (आमतौर पर अंतर्निर्मित webcams के लिए 0)
    video_reference="https://storage.googleapis.com/com-roboflow-marketing/inference/people-walking.mp4",
    # pipeline को बताएं कि inference परिणामों के साथ क्या करना है। render_boxes एक built-in sink है जो वीडियो के ऊपर boxes render करता है
    on_prediction=render_boxes,
    # roboflow api से मॉडल लोड करने के लिए अपनी roboflow api key प्रदान करें
    api_key=api_key,
)

# पाइपलाइन शुरू करें और वीडियो स्ट्रीम को संसाधित करने वाली thread को join करें।
pipeline.start()
pipeline.join()
वीडियो संदर्भ क्या है?
Inference Pipelines कई विभिन्न प्रकार के वीडियो स्ट्रीम को स्वीकार कर सकते हैं:
डिवाइस ID (पूर्णांक): पूर्णांक प्रदान करने से पाइपलाइन को वेबकैम जैसे स्थानीय डिवाइस से वीडियो स्ट्रीम करने का निर्देश मिलता है। आमतौर पर, अंतर्निहित वेबकैम डिवाइस के रूप में दिखते हैं
0.वीडियो फ़ाइल (स्ट्रिंग): वीडियो फ़ाइल का पथ देने पर पाइपलाइन फ़ाइल के हर फ़्रेम को पढ़ती है, निर्दिष्ट मॉडल के साथ इन्फ़रेंस चलाती है, फिर
on_predictionपद्धति को प्राप्त predictions के प्रत्येक सेट के साथ चलाती है।वीडियो URL (स्ट्रिंग): वीडियो URL प्रदान करना वीडियो फ़ाइल पथ देने के बराबर है और पहले वीडियो डाउनलोड करने की आवश्यकता को समाप्त करता है।
RTSP URL (स्ट्रिंग): RTSP URL प्रदान करने पर पाइपलाइन RTSP स्ट्रीम से फ़्रेमों को यथासंभव तेज़ी से स्ट्रीम करती है, फिर
on_predictionउपलब्ध नवीनतम फ़्रेम पर callback चलाती है।एक सूची ऐसे तत्वों की, जो ऊपर वर्णित किसी भी मान के हो सकते हैं।
कैसे InferencePipeline काम करता है
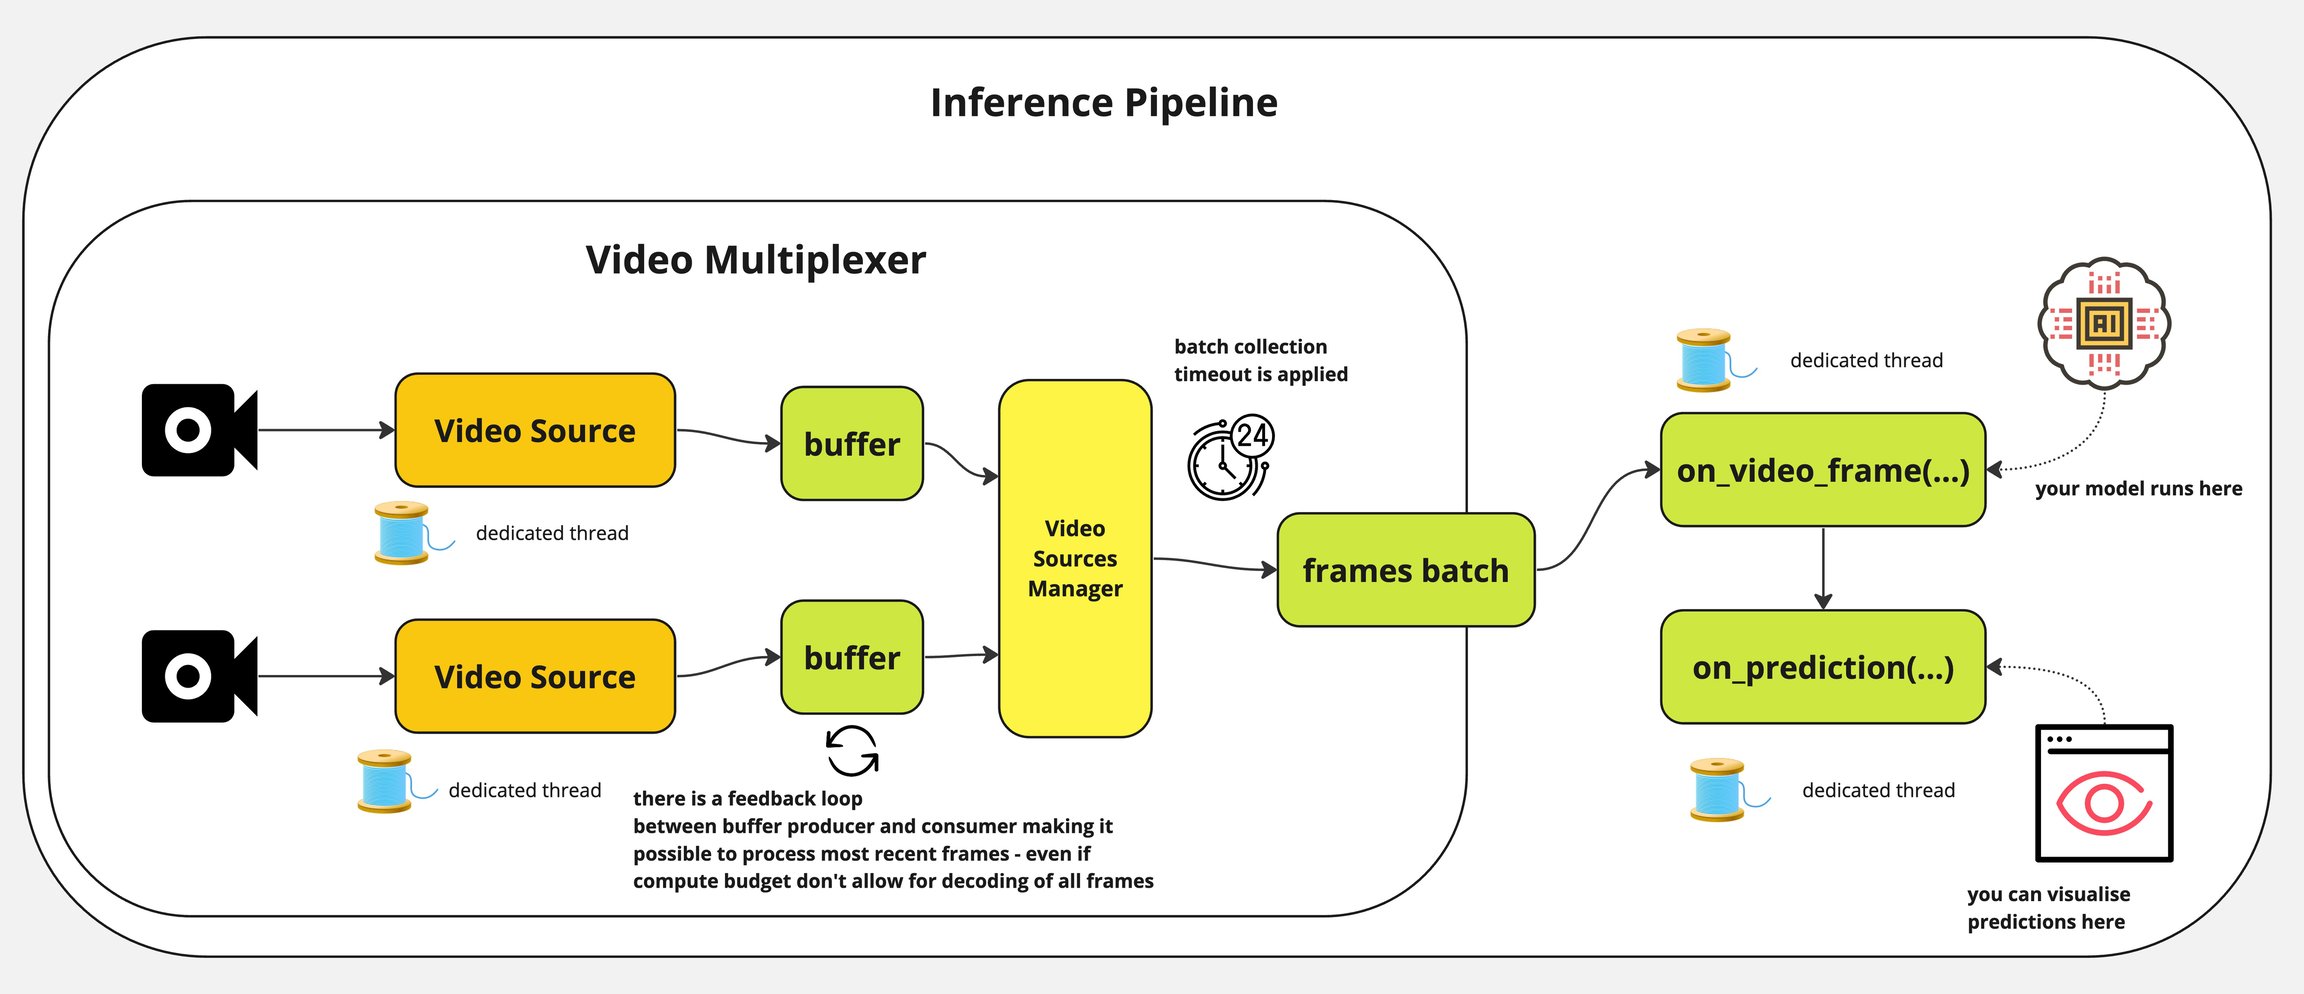
InferencePipeline प्रदान किए गए प्रत्येक वीडियो संदर्भ के लिए एक वीडियो स्रोत consumer thread शुरू करता है। वीडियो से फ़्रेम एक वीडियो मल्टीप्लेक्सर द्वारा लिए जाते हैं जो प्रतीक्षा करता है batch_collection_timeout (यदि कोई स्रोत फ़्रेम प्रदान नहीं करता है, तो एक छोटा batch भेजा जाता है on_video_frame(...)लेकिन गायब फ़्रेम और predictions को भर दिया जाता है None को भेजने से पहले on_prediction(...)). on_prediction(...) में काम कर सकता है SEQUENTIAL मोड (एक समय में केवल एक तत्व), या BATCH मोड (सभी batch तत्व एक साथ); यह नियंत्रित होता है sink_mode पैरामीटर द्वारा।
स्थिर वीडियो फ़ाइलों के लिए, InferencePipeline डिफ़ॉल्ट रूप से सभी फ़्रेमों को संसाधित करता है। स्ट्रीम्स के लिए, बफ़रों से फ़्रेम हटाना संभव है ताकि हमेशा सबसे हालिया डेटा को संसाधित किया जा सके (जब मॉडल इन्फ़रेंस धीमा हो, तो बफ़र में अधिक फ़्रेम जमा हो सकते हैं; स्ट्रीम प्रोसेसिंग पुराने फ़्रेम हटाती है और केवल सबसे हालिया फ़्रेम को संसाधित करती है)।
स्थिरता बढ़ाने के लिए, स्ट्रीम्स को संसाधित करते समय, प्रसंस्करण के दौरान कनेक्टिविटी खोने पर वीडियो स्रोत स्वतः पुनः-कनेक्ट कर दिए जाते हैं। इसका उद्देश्य ऐसे production वातावरण में विफलताओं को रोकना है जहाँ पाइपलाइन लंबे समय तक चल सकती है और स्रोत के डाउन होने को gracefully संभालने की आवश्यकता होती है।
कस्टम इन्फ़रेंस लॉजिक
InferencePipeline कस्टम इन्फ़रेंस लॉजिक चलाने का समर्थन करता है। मॉडल ID देने के बजाय, आप एक कस्टम callable दे सकते हैं। इस callable को एक VideoFrame लेना चाहिए और प्रसंस्करण के परिणामों के साथ एक डिक्शनरी लौटानी चाहिए (जैसे on_video_frame handler)। यह मॉडल predictions हो सकती हैं या किसी अन्य प्रसंस्करण के परिणाम हो सकते हैं जिसे आप निष्पादित करना चाहते हैं।
यह ध्यान देने योग्य है कि उपयोग किया जा रहा sink ( on_prediction handler) को विशिष्ट प्रारूप के अनुसार समायोजित किया जाना चाहिए on_video_frame(...) response। इस तरह, आप वीडियो प्रोसेसिंग को अपनी इच्छानुसार आकार दे सकते हैं।
InferencePipeline Workflows के साथ
InferencePipeline भी चला सकते हैं Roboflow Workflows, जैसा कि नीचे दिखाया गया है:
आप प्रारंभ कर सकते हैं InferencePipeline Roboflow ऐप में पंजीकृत किसी Workflow के साथ, अपना workspace_name और workflow_id:
सिंक
सिंक यह परिभाषित करते हैं कि Inference Pipeline को प्रत्येक prediction के साथ क्या करना चाहिए। sink एक फ़ंक्शन है जिसकी signature निम्नलिखित है:
तर्क हैं:
predictions: एक डिक्शनरी (या कई वीडियो स्रोतों का उपयोग करने पर डिक्शनरियों की सूची) जो मॉडल केinfer(...)method.video_frame: एकVideoFrameऑब्जेक्ट (या ऑब्जेक्ट्स की सूची)VideoFrameजिसमें वीडियो फ़्रेम का मेटाडेटा और पिक्सेल डेटा होता है।
उपयोग
आप यह भी कर सकते हैं कि on_prediction यह अन्य पैरामीटर स्वीकार करे जो इसके व्यवहार को कॉन्फ़िगर करते हैं, लेकिन उन्हें injection से पहले फ़ंक्शन closure में latch करना होगा InferencePipeline init विधियाँ।
कस्टम sink ट्यूटोरियल
आइए चरण दर चरण एक custom sink बनाना समझते हैं। सबसे पहले, एक सरल sink जो फ़्रेम ID प्रिंट करता है:
आउटपुट कुछ इस तरह दिखना चाहिए:
अब कुछ अधिक उपयोगी करते हैं और अपने custom sink का उपयोग predictions को इसके साथ visualise करने के लिए करते हैं Supervision:
आपको अपनी स्क्रीन पर कुछ ऐसा दिखाई देना चाहिए:
कस्टम sinks (उन्नत)
कस्टम sink बनाने के लिए, उपयुक्त signature के साथ एक नया फ़ंक्शन परिभाषित करें।
InferencePipeline प्रदान करता है sink_mode पैरामीटर, जो नियंत्रित करता है कि predictions आपके sink तक कैसे भेजे जाते हैं। के साथ SinkMode.SEQUENTIAL, प्रत्येक फ़्रेम और prediction sink को एक अलग कॉल ट्रिगर करते हैं। के साथ SinkMode.BATCH, फ़्रेमों और predictions की एक सूची sink को प्रदान की जाती है, जो हमेशा वीडियो स्रोतों के क्रम में संरेखित रहती है, साथ None उन वीडियो फ़्रेमों या predictions के स्थान पर मान जिन्हें के कारण छोड़ दिया गया था batch_collection_timeout. SinkMode.ADAPTIVE डिफ़ॉल्ट मोड है: एकल वीडियो इनपुट के लिए, पाइपलाइन ऐसा व्यवहार करती है मानो वह में चल रही हो SinkMode.SEQUENTIAL। कई वीडियो संभालने के लिए, sink को स्वीकार करना होगा predictions: List[Optional[dict]] और video_frame: List[Optional[VideoFrame]]। सरल sinks का उपयोग करके भी कई वीडियो संसाधित करना संभव है, लेकिन तब SinkMode.SEQUENTIAL का उपयोग किया जाना चाहिए, जिससे sink प्रत्येक prediction तत्व पर अलग-अलग कॉल होगा।
क्यों है Optional में List[Optional[dict]] और List[Optional[VideoFrame]]?
ऐसा हो सकता है कि सभी वीडियो स्रोतों से वीडियो फ़्रेम एकत्र करना संभव न हो (उदाहरण के लिए जब स्रोतों में से कोई एक डिस्कनेक्ट हो जाता है और पुनः-कनेक्शन का प्रयास किया जाता है)। predictions और video_frame को इस तरह क्रमबद्ध किया जाता है कि वे के क्रम से मेल खाएँ video_reference सूची के InferencePipeline, और None तत्व गायब फ़्रेमों के स्थान पर दिखाई देते हैं। हम यह जानकारी sink को प्रदान करते हैं, क्योंकि कुछ sinks को batch से सभी predictions और video frames प्रदान किए जाने की आवश्यकता हो सकती है (भले ही वे अनुपलब्ध हों)। उदाहरण के लिए, render_boxes(...) sink को tile mosaic में फ़्रेमों की स्थिति बनाए रखने के लिए उस जानकारी की आवश्यकता होती है।
prediction प्रारूप
Predictions sink को एक डिक्शनरी के रूप में प्रदान किए जाते हैं जिसमें कुंजी होती है predictionsजो एकल फ़्रेम या फ़्रेमों के batch के लिए predictions रखती है। सामग्री इस बात पर निर्भर करती है कि इसके पीछे InferencePipelineकौन सा मॉडल चलता है; Roboflow मॉडलों के लिए यह एक dict या dicts की सूची के रूप में आता है।
मॉडल आउटपुट के आधार पर, predictions अलग-अलग दिखते हैं। आपको sink को prediction प्रारूप के अनुसार समायोजित करना होगा। उदाहरण के लिए, Roboflow object detection prediction में निम्नलिखित कुंजियाँ होती हैं:
x: अनुमानित bounding box का केंद्र x निर्देशांक, पिक्सेल मेंy: अनुमानित bounding box का केंद्र y निर्देशांक, पिक्सेल मेंचौड़ाई: अनुमानित bounding box की चौड़ाई, पिक्सेल मेंऊँचाई: अनुमानित bounding box की ऊँचाई, पिक्सेल मेंविश्वसनीयता: prediction का confidence मान (0 और 1 के बीच)क्लास: अनुमानित class का नामclass_id: अनुमानित class ID
अंतर्निर्मित sinks
Inference में कई अंतर्निर्मित sinks हैं जो उपयोग के लिए तैयार हैं (देखें inference/core/interfaces/stream/sinks.py में Inference रिपॉज़िटरी).
render_boxes(...)
render boxes sink predictions को visualise करता है और उन्हें stream पर overlay करता है। यह predictions को render करने और annotated frame प्रदर्शित करने के लिए Supervision annotators का उपयोग करता है। यह केवल उन Roboflow मॉडलों के लिए काम करता है जो detection-आधारित output देते हैं (object-detection, instance-segmentation, keypoint-detection), और डिफ़ॉल्ट रूप से predictions के सभी विवरण प्रदर्शित नहीं हो सकते (जैसे detected keypoints)।
UDPSink(...)
UDP sink predictions को UDP पोर्ट के माध्यम से प्रसारित करता है। इस पोर्ट को आगे की प्रक्रिया के लिए client code द्वारा सुना जा सकता है। यह Python की डिफ़ॉल्ट JSON serialization का उपयोग करता है, इसलिए predictions serializable होने चाहिए, अन्यथा एक त्रुटि उत्पन्न होती है।
multi_sink(...)
multi-sink कई sinks को जोड़ता है ताकि एक ही inference परिणाम पर कई कार्रवाइयाँ हो सकें।
VideoFileSink(...)
video file sink predictions को visualise करता है, जैसा कि render_boxes(...) sink; हालाँकि, annotated फ़्रेमों को प्रदर्शित करने के बजाय, यह उन्हें एक वीडियो फ़ाइल में सहेजता है। से संबंधित सभी constraints render_boxes(...) लागू होते हैं।
मॉडल weights डाउनलोड
जब आप पहली बार inference चलाते हैं, तो model weights स्वतः डाउनलोड हो जाते हैं। आप इंटरनेट से जुड़े रहते हुए एक बार पाइपलाइन initialize करके weights पहले से डाउनलोड कर सकते हैं:
वैकल्पिक रूप से, उपयोग करें get_model() वेट्स को पहले से डाउनलोड करने के लिए:
आप कैश डायरेक्टरी की जाँच करके कैश किए गए मॉडलों की पुष्टि कर सकते हैं:
आपको प्रत्येक कैश किए गए मॉडल के लिए डायरेक्टरी दिखनी चाहिए, जिनका नाम आमतौर पर मॉडल ID पर रखा जाता है।
अन्य पाइपलाइन कॉन्फ़िगरेशन
इन्फ़रेंस पाइपलाइनें अत्यधिक कॉन्फ़िगर करने योग्य हैं। कॉन्फ़िगरेशन विकल्पों में शामिल हैं:
max_fps: फ्रेम प्रोसेसिंग की अधिकतम दर सेट करने के लिए उपयोग किया जाता है।विश्वसनीयता: इन्फ़रेंस के लिए उपयोग किया जाने वाला कॉन्फ़िडेंस थ्रेशोल्ड।iou_threshold: इन्फ़रेंस के लिए उपयोग किया जाने वाला IoU थ्रेशोल्ड।video_source_properties: वीडियो स्रोत को कॉन्फ़िगर करने के लिए गुणों की वैकल्पिक डिक्शनरी, जो cv2 VideoCapture गुणों के अनुरूप हैcv2.CAP_PROP_*. देखें OpenCV दस्तावेज़ सभी संभावित गुणों की सूची के लिए.
इन्फ़रेंस पाइपलाइन पैरामीटरों की पूरी सूची के लिए देखें inference/core/interfaces/stream/inference_pipeline.py में Inference रिपॉज़िटरी.
अंतिम अपडेट
क्या यह उपयोगी था?