> For the complete documentation index, see [llms.txt](https://docs.roboflow.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.roboflow.com/workflows/ja/burokku/blocks/run-a-model/anthropic-claude.md).

# Anthropic Claude

Workflow から Anthropic の Claude API を呼び出せます。

### このブロックについて

Anthropic Claudeブロックを使うと、ワークフローからAnthropic Claude APIを呼び出せます。

このブロックは、Workflowsでサポートされているあらゆるマルチモーダルタスクに使用できます。

その後、APIの結果をワークフローの出力に直接返すことができます。

また、その結果を他のブロックへの入力として使用することもできます。たとえば、Claudeにはい/いいえの質問をし、VLM as Classifierブロックで結果を処理したうえで、Continue-Ifブロックを使ってその情報に基づいてワークフローの流れを制御できます。

このブロックを使用するには、Anthropic APIキーが必要です。 [Anthropic APIキーの作成方法を学ぶ。](https://docs.anthropic.com/en/api/admin-api/apikeys/get-api-key)
<figure><img src="https://4077895066-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FoO0Ceoy9R0lHDZATcPyh%2Fuploads%2Fgit-blob-19b43d5ac9c5165cb5dd02ce772735b3722bb51b%2FScreenshot%202025-05-23%20at%2019.06.00.png?alt=media" alt=""><figcaption><p>単一ラベル分類モデルブロック。</p></figcaption></figure>

### このブロックに入力できるもの

Object Detection Modelブロックは次の対象に対して実行できます:

1. ワークフローに送信した画像
2. ワークフローに送信した動画フレーム
3. ワークフロー内で計算される画像の切り抜き領域（つまり Cropブロックを使用したもの）

### ブロックの設定方法

このブロックを設定するときは、次のものを指定する必要があります:

* タスクタイプ。
* Claudeに送信するプロンプト。
* Anthropic APIキー

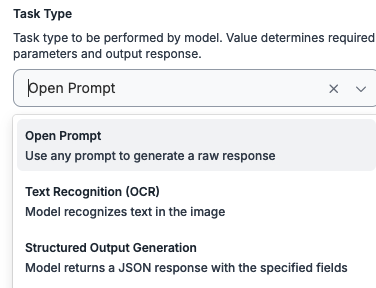
Open Promptはデフォルトのタスクタイプです。これにより独自のプロンプトをClaudeに送信できます。

単一ラベル分類や複数ラベル分類など、他のタスクタイプを選ぶこともできます。これらのタスクは、他のWorkflowブロックが理解できる形式でデータを返すように設定されています。Claudeをワークフロー内の他のブロックと併用する予定がある場合に最適です。

<figure><img src="https://4077895066-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FoO0Ceoy9R0lHDZATcPyh%2Fuploads%2Fgit-blob-c0b3e6b0ea45f10fbef04b6439a7e464aaa040ea%2FScreenshot%202025-05-23%20at%2019.16.25.png?alt=media" alt=""><figcaption></figcaption></figure>

追加プロパティセクションから、使用するモデルバージョンも選択できます:

<figure><img src="https://4077895066-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FoO0Ceoy9R0lHDZATcPyh%2Fuploads%2Fgit-blob-e90b9ed56f3600d869116403a593d609d283791e%2FScreenshot%202025-05-23%20at%2019.09.42.png?alt=media" alt=""><figcaption><p>モデルバージョンを選択してください。</p></figcaption></figure>

### このブロックが返すもの

### 使用例

このブロックは、クラウドの視覚言語モデル（VLM）を呼び出したいあらゆるワークフローで便利です。

自前のハードウェアで動作するVLMが必要な場合は、Qwen-VL 2.5ブロックを試すことをおすすめします。

### 予測形式

この下のカードを展開すると、このブロックが返すJSONデータを確認できます。

<details>

<summary>予測形式</summary>

Open Promptリクエストでは、このブロックは次の形式でデータを返します:

```json
[
  {
    "output":  , 
    "anthropic_claude": {
      "output": "画像には、AIモデルのタスク設定用のユーザーインターフェースが表示されています。インターフェースには、\"Task Type\"セクションがあり、\"Open Prompt\"が選択されています。その下に\"Prompt\"フィールドがあり、次のテキストが入力されています: \"ドック番号は何ですか？ A1のように返してください。\"

また、\"API Key\"フィールドもあり、マスクされた値（セキュリティのためドットで表示）が入力されているようです。

画像自体にはドック番号は見当たりません。プロンプト欄のテキストは、AIモデルにドック番号を識別し、応答を特定の形式（\"A1\"のように）で返すよう指示する内容のようですが、共有された画像には実際のドック番号は含まれていません。"
      "classes": null
    }
  }
]
```

</details>

### 導入時の考慮事項

このブロックを使用するには、インターネット接続が必要です。つまり、インターネット接続がない限り、このブロックをエッジにデプロイすることはできません。