> For the complete documentation index, see [llms.txt](https://docs.roboflow.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/create-a-block.md).
# Workflowブロックを作成
Workflowブロックを書くための完全な開発者ガイド: マニフェスト、入力、出力、バッチ処理、フロー制御、次元。
{% hint style="info" %}
これは、PythonでBlockクラスを作成するための詳細ガイドです。1つのWorkflow内で少しだけカスタムロジックが必要なだけなら、 [動的なPythonブロック](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/dynamic-python-blocks.md) をWorkflow Definition内でインライン定義するだけで通常は十分です。詳しくは [カスタムブロック](https://docs.roboflow.com/workflows/ja/burokku/blocks/custom-blocks.md).
{% endhint %}
Workflowsブロックの開発には、Workflowエコシステムの理解が必要です。詳細に入る前に、必要な知識を要約しましょう:
理解しておくべきこと: [Workflowの実行](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/workflow-execution.md)、特に次の点です:
* WorkflowブロックとWorkflow定義内のステップの関係
* Workflowブロックとそのmanifestがどのように使われるか、 [Workflows Compiler](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/compiler.md)
* 何が `次元レベル` で、Workflowを流れるバッチ指向データの
* どのように [Execution Engine](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/execution-engine.md) ステップと、その入力および出力に関してやり取りするか
* 〜の性質と役割とは何か [Workflow `種類`](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/kinds.md)
* どのように [`pydantic`](https://docs.pydantic.dev/latest/) が動作するか
## 環境のセットアップ
まもなく分かるように、Workflowブロックの作成は、特定のインターフェースを実装するPythonクラスを定義するだけです。この設計により、他のPythonコードと同じようにPythonインタプリタでブロックを実行できます。ただし、Workflow実行中には通常ほかのブロックから供給されるはずの必要な入力をすべて組み立てる際に、困難に直面することがあります。そのため、スムーズに作業するには開発環境を適切にセットアップすることが重要です。標準的な開発プロセスの一部として、以下の手順に従うことをおすすめします(後続の貢献では最初の手順は省略できます):
1. **〜をセットアップする `conda` 環境** そして次の主要依存関係をインストールする: `inference`、で説明されているとおり [`inference` contributor guide](https://github.com/roboflow/inference/blob/main/CONTRIBUTING.md).
2. **Workflowsのコードベースの構成に慣れてください。**
3. **最小限のブロックを作成する** — これを行う方法は次のセクションで学びます。まずは、シンプルなブロックmanifestと基本ロジックを実装して、ブロックが期待どおりに動作することを確認しましょう。
4. **プラグインにブロックを追加する** — ブロックを作成したら、プラグインからエクスポートされるブロック一覧に追加します。Roboflow Coreプラグインに追加する場合は、 [loader.py](https://github.com/roboflow/inference/blob/main/workflows/roboflow_workflows/core_steps/loader.py). **この手順を忘れると、ブロックは表示されません!**
5. **ブロックを反復して改善する** — 満足のいく結果になるまで、ブロックの開発と実行を続けてください。以下のセクションでは、さまざまなシナリオでブロックを反復改善する方法を説明します。
### Workflows UIを使ってブロックを実行する
マウント済みボリュームを使って inference サーバーを実行することをおすすめします(毎回サーバーを再ビルドするよりはるかに高速です `inference` )。
```bash
inference_repo$ docker run -p 9001:9001 \
-v ./inference:/app/inference \
roboflow/roboflow-inference-server-cpu:latest
```
そしてローカルサーバーをRoboflow UIに接続します:
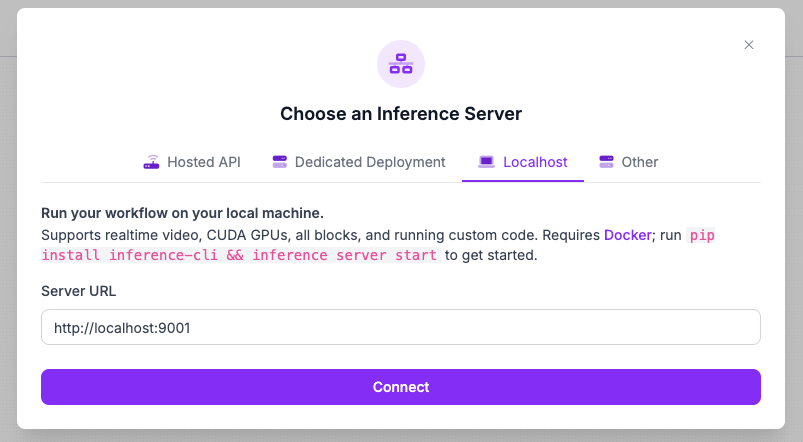 プレビューをすばやく実行するには:
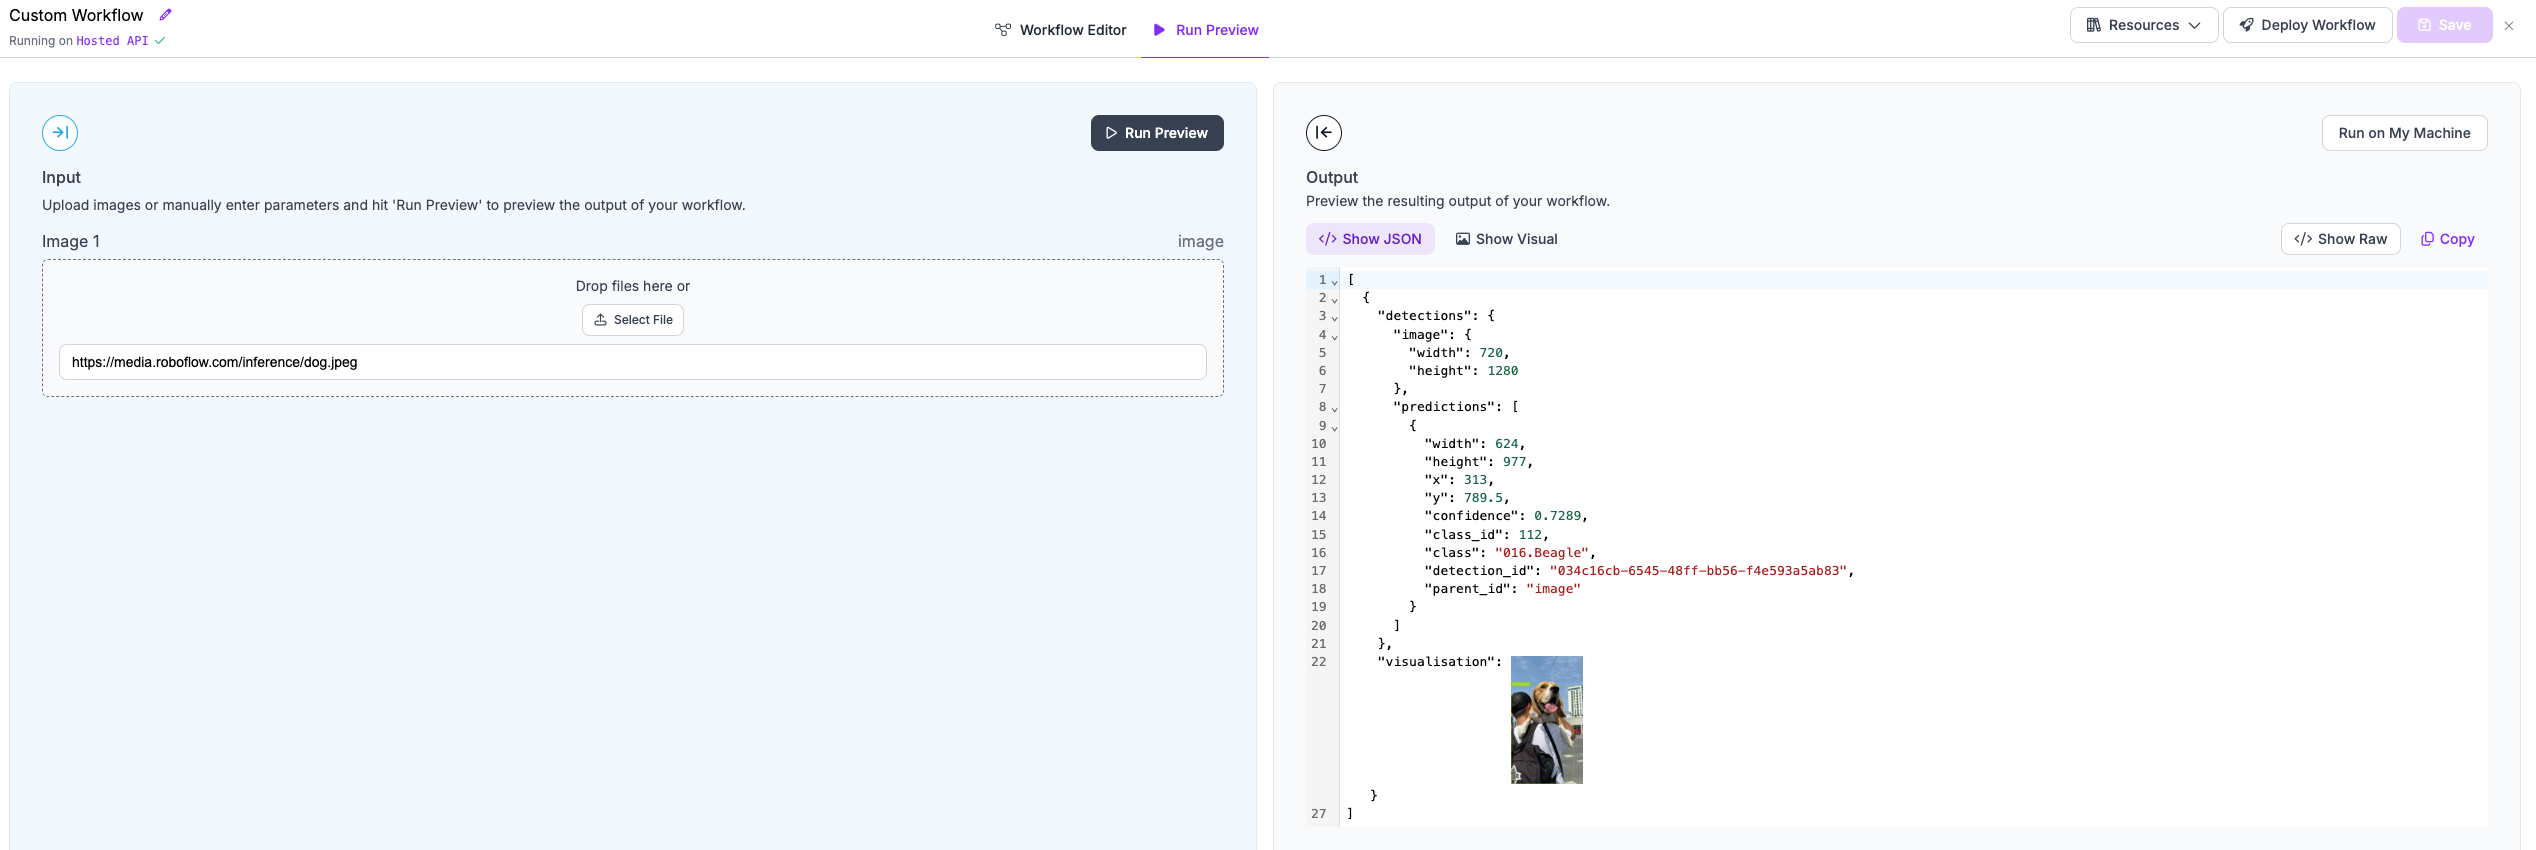
私のブロックには追加の依存関係が必要です。事前ビルド済みの`inference`サーバーは使えません
ブロックが追加の依存関係を必要とすることはよくあります。依存関係を追加するには、単に以下のいずれかに含めるだけです [requirementsファイル](https://github.com/roboflow/inference/tree/main/requirements)を、関連するDockerイメージ(通常は [CPUビルド](https://github.com/roboflow/inference/blob/main/docker/dockerfiles/Dockerfile.onnx.cpu) の `inference` サーバー)にインストールされているもの。
その後、次を実行します:
```bash
inference_repo$ docker build \
-t roboflow/roboflow-inference-server-cpu:test \
-f docker/dockerfiles/Dockerfile.onnx.cpu .
```
その後、作成したテストタグを指定してローカルビルドを実行できます:
```bash
inference_repo$ inference_repo$ docker run -p 9001:9001 \
-v ./inference:/app/inference \
roboflow/roboflow-inference-server-cpu:test
```
### Workflows UIなしでブロックを実行する
Roboflowプラットフォームにアクセスできないコントリビューターには、上記のセクションで述べたようにサーバーを実行することをおすすめします。ただし、UIエディタの代わりに、シンプルなWorkflow定義を作成してサーバーにリクエストを送る必要があります。
UIなしでWorkflowを実行する
以下のコードスニペットは、 `inference` サーバーにWorkflowの実行リクエストを送る方法を示しています。 `inference_sdk` は `inference` パッケージに、サーバー向けの軽量クライアントライブラリとして含まれています。
```python
from inference_sdk import InferenceHTTPClient, InferenceConfiguration
YOUR_WORKFLOW_DEFINITION = ...
client = InferenceHTTPClient(
api_url=object_detection_service_url,
api_key="XXX", # オプション。WorkflowがRoboflow Platformを使用する場合のみ必要
).configure(InferenceConfiguration(api_key_transport="header"))
result = client.run_workflow(
specification=YOUR_WORKFLOW_DEFINITION,
images={
"image": your_image_np, # これは入力例です。適宜変更してください
},
parameters={
"my_parameter": 37, # これは入力例です。適宜変更してください
},
)
```
### 通常のコントリビューターに推奨される方法
〜に統合テストを作成することは `tests/workflows/integration_tests/execution` ディレクトリに統合テストを作成することは、開発の反復プロセスの自然な一部です。この方法では、開発とテストを同時に進められるため、コードを洗練させながら貴重なフィードバックを得られます。ある程度の経験は必要ですが、長期的なコード保守性を大きく高めます。
手順はシンプルです:
1. **新しいテストモジュールを作成する:** たとえば、次のような名前にします `test_workflows_with_my_custom_block.py`.
2. **サンプルWorkflowを作成する**:1つ以上のサンプルWorkflowを作成します。ブロックがエコシステム内の他のブロックと連携できると理想的です。
3. **サンプルデータでテストを実行する:** テスト内でこれらのWorkflowをサンプルデータを使って実行します( [fixtures](https://github.com/roboflow/inference/blob/main/tests/workflows/integration_tests/execution/conftest.py) を参照すると、通常使用するサンプルデータを見つけられます)。
4. **期待される結果を検証する:** 結果が期待通りであることを検証します。
開発フローにテストを組み込むことで、ブロックが長期にわたって安定し、既存のブロックと効果的に連携し、あなたの作業の表現力を高められます!
次のコマンドでテストを実行できます:
```bash
pytest tests/workflows/integration_tests/execution/test_workflows_with_my_custom_block
```
他のテストを例として参照するか、以下のテンプレートを使ってください:
統合テストのテンプレート
```python
def test_detection_plus_classification_workflow_when_XXX(
model_manager: ModelManager,
dogs_image: np.ndarray,
roboflow_api_key: str,
) -> None:
# 準備
workflow_init_parameters = {
"workflows_core.model_manager": model_manager,
"workflows_core.api_key": roboflow_api_key,
"workflows_core.step_execution_mode": StepExecutionMode.LOCAL,
}
execution_engine = ExecutionEngine.init(
workflow_definition=,
init_parameters=workflow_init_parameters,
max_concurrent_steps=WORKFLOWS_MAX_CONCURRENT_STEPS,
)
# 実行
result = execution_engine.run(
runtime_parameters={
"image": dogs_image,
}
)
# 検証
assert isinstance(result, list), "リストが返されることを期待"
assert len(result) == 1, "1枚の入力画像に対して出力は1要素であることを期待"
assert set(result[0].keys()) == {
"predictions",
}, "宣言されたすべての出力が返されることを期待"
assert (
len(result[0]["predictions"]) == 2
), "入力画像に犬の切り出しが2つあることを期待しているため、ネストされた分類結果は2つになるはず"
assert [result[0]["predictions"][0]["top"], result[0]["predictions"][1]["top"]] == [
"116.Parson_russell_terrier",
"131.Wirehaired_pointing_griffon",
], "予測結果が参照実行で測定されたものと一致することを期待"
```
* 〜行目に `2`、 `model_manager` fixtureがあります。これは通常、モデルブロックで必要になります。このfixtureは `ModelManager` の抽象化を提供し、 `inference`モデルの読み込みとアンロードに使用されます。
* 行 `3` は、2匹の犬の画像を含むfixtureを定義しています(他のfixtureも参照すると、さらに例の画像を見つけられます)。
* 行 `4` は、テスト対象のWorkflow内のいずれかのブロックがRoboflow APIキーを必要とする場合に使える任意のfixtureです。その場合は、 `ROBOFLOW_API_KEY` 有効なキーを設定したROBOFLOW\_API\_KEY環境変数を、テスト実行前にエクスポートしてください。
* 複数行 `7-11` は、Workflow定義に基づいてExecution Engineが実行時に生成するブロックの初期化パラメータのセットアップを提供します。
* 複数行 `19-23` は、入力パラメータを注入してWorkflowを実行する方法を示しています。runtime\_parameters内のキーが、Workflow定義で宣言された入力と一致していることを確認してください。
* 〜行目から `26`、テスト内に例のアサーションがあります。
## プロトタイプ
Workflowブロックを作成するには、Workflowsライブラリのコアからいくつかのインポートが必要です。ブロック作成時に役立つインポート一覧を以下に示します:
```python
from inference.core.workflows.execution_engine.entities.base import (
Batch, # データのバッチはBatch[X]コンテナで渡されます
OutputDefinition, # manifestで出力を宣言するために使うクラス
WorkflowImageData, # 画像の内部表現
# - 入力の種類がimageの場合に使用
)
from inference.core.workflows.prototypes.block import (
BlockResult, # `run(...)`メソッドの結果の型エイリアス
WorkflowBlock, # ブロックの基底クラス
WorkflowBlockManifest, # ブロックmanifestの基底クラス
)
from inference.core.workflows.execution_engine.entities.types import *
# コアライブラリの`kinds`を含むモジュール
```
特に重要なのは次のとおりです:
* `WorkflowBlock` — ブロックの基底クラス
* `WorkflowBlockManifest` — block manifestの基底クラス
{% hint style="warning" %}
**内部データ表現を理解する**
お気づきかもしれませんが、私たちは次のインポートを推奨しています `Batch` および `WorkflowImageData` クラスです。これらは、私たちのシステムで構成要素を作る際に使われる基本コンポーネントです。これらのクラスが全体アーキテクチャにどう組み込まれるかをより深く理解するには、 [Data Representations](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/data-representations.md) ページをご参照ください。
{% endhint %}
## ブロック manifest
manifestは、Workflowブロックの重要なコンポーネントであり、ブロックを使用するためにWorkflow定義に配置できるステップ宣言のプロトタイプを定義します。特に、次の役割があります:
* **使用する `pydantic` ことでWorkflows定義の構文解析を支えます:** 次を継承します: [`pydantic BaseModel`](https://docs.pydantic.dev/latest/api/base_model/) の機能により、Workflow定義を解析・検証します。このスキーマは、 `pydanticの` OpenAPI標準との統合のおかげで、Workflows UI互換の形式へ自動的にエクスポートすることもできます。
* **データバインディングを定義する:** manifest内のどのフィールドが、実行中にWorkflowを流れるデータのセレクタであるかを指定し、その種類を示します。
* **ブロックの出力を記述する:** ブロックが生成する出力を概説します。
* **次元性を指定する:** 入力と出力の次元性に関連するプロパティを詳述します。
* **バッチ入力と空値を示す:** そのステップがバッチ入力と空値を受け付けるかどうかをExecution Engineに知らせます。
* **互換性を確保する:** 安定性を維持するために、異なるExecution Engineバージョンとの互換性を規定します。詳細は [バージョニング](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/versioning.md).
### manifestの雛形
manifestの仕組みを理解するために、ステップごとに定義してみましょう。ここで作成する例のブロックは、画像の類似度を計算するものです。まずはインポートとクラスの骨組みから始めます:
```python
from typing import Literal
from inference.core.workflows.prototypes.block import (
WorkflowBlockManifest,
)
class ImagesSimilarityManifest(WorkflowBlockManifest):
type: Literal["my_plugin/images_similarity@v1"]
name: str
```
これはmanifestの最小限の表現です。CompilerとExecution Engineにとって重要な2つの特別なフィールドを定義します:
* `type` — 動的なブロックプールに基づくWorkflows定義の構文を解析するために必要です。これは [`pydantic` type discriminator](https://docs.pydantic.dev/latest/concepts/unions/#discriminated-unions) で、CompilerがWorkflow定義内の特定のステップを解析するときに、どのブロックmanifestを検証すべきかを理解できるようにします
* `name` — このプロパティはステップに一意の名前を付け、他のステップがセレクタ経由でそれを選択できるようにするために使われます
### 入力の追加
このステップには、比較する2つの画像入力を取らせたいと考えています。
入力の追加
これらの入力定義をmanifestに追加する方法を見てみましょう:
```python
from typing import Literal, Union
from pydantic import Field
from inference.core.workflows.prototypes.block import (
WorkflowBlockManifest,
)
from inference.core.workflows.execution_engine.entities.types import (
Selector,
IMAGE_KIND,
)
class ImagesSimilarityManifest(WorkflowBlockManifest):
type: Literal["my_plugin/images_similarity@v1"]
name: str
# `type`と`name`以外のすべてのプロパティは、
# ハードコードされたパラメータかデータセレクタとして扱われます。データセレクタは
# `$steps.` または `$inputs.` で始まる文字列で、データ参照を示します
# 実行時に利用可能なデータを参照します。ここでは通常、データの種類を指定します
# これにより、Compilerにデータの見た目について期待する内容を伝えます。
image_1: Selector(kind=[IMAGE_KIND]) = Field(
description="類似度を計算する最初の画像",
)
image_2: Selector(kind=[IMAGE_KIND]) = Field(
description="類似度を計算する2番目の画像",
)
```
* の各行で `2-9`、必要なものがすべて揃うように、いくつかのインポートを追加しました
* 行目で `20` は定義します `image_1` パラメータ。manifestはWorkflow Definitionのプロトタイプなので、ステップで使用する画像を指定する唯一の方法はセレクタを与えることです。コアライブラリにはこれに使える専用の型があります。 `Selector`。コードベースを詳しく見ると、これは型エイリアスを構築する関数であることが分かります。 `pydantic` これは次の文字列パターンに一致する文字列を期待するように `$inputs.{name}` および `$steps.{name}.*` というパターンをそれぞれ期待し、さらに追加のスキーマフィールドメタデータを提供して、Workflowsエコシステムの各コンポーネントに、セレクタの背後にあるデータの `種類` が [image](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/kinds/image.md). **重要な注意:** 私たちは *種類* をリストとして表します。特定の種類のリストは *種類の共用体* としてExecution Engineに解釈されます。
* を表す `pydantic` `Field(...)` 属性は行末の方にあります `20` 。これは任意ですが、特にWorkflows UIと連携することを想定したブロックでは有用です
* 〜行目から `23`、 `image_2` に非常によく似たパラメータの定義があります `image_1`.
このようなmanifest定義により、Workflow定義内の次のステップ宣言を処理できます:
```json
{
"type": "my_plugin/images_similarity@v1",
"name": "my_step",
"image_1": "$inputs.my_image",
"image_2": "$steps.image_transformation.image"
}
```
この定義により、CompilerとExecution Engineは次のことを行います:
* typeを宣言しているWorkflowブロックからステップを初期化する `my_plugin/images_similarity@v1`
* ステップのrunメソッドに2つのパラメータを供給する:
* `input_1` という型の `WorkflowImageData` これには、Workflow実行入力として送信された画像が次の名前で格納されます `my_image`.
* `imput_2` という型の `WorkflowImageData` これは、次の名前の別のステップによって実行時に生成されます `image_transformation`
### manifestにパラメータを追加する
では、ステップの実行に影響するパラメータを追加しましょう。
manifestにパラメータを追加する
```python
from typing import Literal, Union
from pydantic import Field
from inference.core.workflows.prototypes.block import (
WorkflowBlockManifest,
)
from inference.core.workflows.execution_engine.entities.types import (
Selector,
IMAGE_KIND,
FLOAT_ZERO_TO_ONE_KIND,
)
class ImagesSimilarityManifest(WorkflowBlockManifest):
type: Literal["my_plugin/images_similarity@v1"]
name: str
# `type`と`name`以外のすべてのプロパティは、
# ハードコードされたパラメータかデータセレクタとして扱われます。データセレクタは
# `$steps.` または `$inputs.` で始まる文字列で、データ参照を示します
# 実行時に利用可能なデータを参照します。ここでは通常、データの種類を指定します
# これにより、Compilerにデータの見た目について期待する内容を伝えます。
image_1: Selector(kind=[IMAGE_KIND]) = Field(
description="類似度を計算する最初の画像",
)
image_2: Selector(kind=[IMAGE_KIND]) = Field(
description="類似度を計算する2番目の画像",
)
similarity_threshold: Union[
float,
Selector(kind=[FLOAT_ZERO_TO_ONE_KIND]),
] = Field(
default=0.4,
description="画像が類似しているとみなすしきい値",
)
```
* 行目で `9` インポート [`float_zero_to_one`](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/kinds/float-zero-to-one.md) `種類` パラメータを定義するために使用する定義。
* 〜行目で `27` 次の名前のパラメータの定義を開始します `similarity_threshold`。manifestは、float値、または次の型のworkflow入力へのセレクタのいずれかを受け入れます `種類` [`float_zero_to_one`](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/kinds/float-zero-to-one.md)、次の行でインポートした `9`.
このようなmanifest定義により、Workflow定義内の次のステップ宣言を処理できます:
```json
{
"type": "my_plugin/images_similarity@v1",
"name": "my_step",
"image_1": "$inputs.my_image",
"image_2": "$steps.image_transformation.image",
"similarity_threshold": "$inputs.my_similarity_threshold"
}
```
あるいは次のようにも書けます:
```json
{
"type": "my_plugin/images_similarity@v1",
"name": "my_step",
"image_1": "$inputs.my_image",
"image_2": "$steps.image_transformation.image",
"similarity_threshold": 0.5
}
```
### ブロック出力の宣言
ブロックの入力は正常に定義できましたが、ブロックを正常に実行するために必要な要素がまだいくつか不足しています。ブロックの出力を定義しましょう。
ブロック出力の宣言
必要最小限の情報は、出力の説明です。さらに、ブロックの安定性を高めるため、Execution Engineとの互換性に関する情報を提供することを推奨します。
```python
from typing import Literal, Union
from pydantic import Field
from inference.core.workflows.prototypes.block import (
WorkflowBlockManifest,
OutputDefinition,
)
from inference.core.workflows.execution_engine.entities.types import (
Selector,
IMAGE_KIND,
FLOAT_ZERO_TO_ONE_KIND,
BOOLEAN_KIND,
)
class ImagesSimilarityManifest(WorkflowBlockManifest):
type: Literal["my_plugin/images_similarity@v1"]
name: str
image_1: Selector(kind=[IMAGE_KIND]) = Field(
description="類似度を計算する最初の画像",
)
image_2: Selector(kind=[IMAGE_KIND]) = Field(
description="類似度を計算する2番目の画像",
)
similarity_threshold: Union[
float,
Selector(kind=[FLOAT_ZERO_TO_ONE_KIND]),
] = Field(
default=0.4,
description="画像が類似しているとみなすしきい値",
)
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [
OutputDefinition(
name="images_match",
kind=[BOOLEAN_KIND],
)
]
@classmethod
def get_execution_engine_compatibility(cls) -> Optional[str]:
return ">=1.3.0,<2.0.0"
```
* 行目で `5` ステップ出力を説明するために使用されるクラスをインポートします
* 行目で `11` インポート [`ブール値`](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/kinds/boolean.md) `種類` 出力定義で使用するための
* 行 `32-39` ブロックの出力を指定するクラスメソッドを定義します。リストの各項目は、各バッチ要素ごとに1つの戻り値プロパティを定義し、その `種類`。このブロックはブールフラグを返します `images_match` 各画像ペアごとに。
* 行 `41-43` ブロックのExecution Engineとの互換性を宣言します - 参照 [バージョニングページ](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/versioning.md) 詳細はこちら
それらの変更の結果:
* Execution Engineは、このブロックに基づいて作成されたステップが指定された出力を返すことを理解し、他のステップは入力でそれらの出力を参照できます
* ブロックの読み込み機構は、Execution Engineがバージョンでないため、そのブロックを読み込みません `v1`
詳しく見る: 動的出力
一部のブロックは、解析後に利用可能なステップマニフェストの内容にかかわらず、classmethodを使って出力を任意に定義できない場合があります。これをサポートするために、次の規約を導入しました:
* classmethod `describe_outputs(...)` nameを1要素とするリストを返す必要があります `*` およびkind `*` (別名 `WILDCARD_KIND`)
* さらに、ブロックマニフェストはインスタンスメソッドを実装する必要があります `get_actual_outputs(...)` これは、入力済みマニフェストデータに基づいて生成可能な実際の出力のリストを提供します
```python
from typing import Literal, Union, List, Optional
from pydantic import Field
from inference.core.workflows.prototypes.block import (
WorkflowBlockManifest,
OutputDefinition,
)
from inference.core.workflows.execution_engine.entities.types import (
Selector,
IMAGE_KIND,
FloatZeroToOne,
FLOAT_ZERO_TO_ONE_KIND,
BOOLEAN_KIND,
WILDCARD_KIND,
)
class ImagesSimilarityManifest(WorkflowBlockManifest):
type: Literal["my_plugin/images_similarity@v1"]
name: str
image_1: Selector(kind=[IMAGE_KIND]) = Field(
description="類似度を計算する最初の画像",
)
image_2: Selector(kind=[IMAGE_KIND]) = Field(
description="類似度を計算する2番目の画像",
)
similarity_threshold: Union[
float,
Selector(kind=[FLOAT_ZERO_TO_ONE_KIND]),
] = Field(
default=0.4,
description="画像が類似しているとみなすしきい値",
)
outputs: List[str]
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [
OutputDefinition(
name="*",
kind=[WILDCARD_KIND],
),
]
def get_actual_outputs(self) -> List[OutputDefinition]:
# ここでは `self` にアクセスできます:
return [
OutputDefinition(name=e, kind=[BOOLEAN_KIND])
for e in self.outputs
]
```
## ブロッククラスの定義
この段階で、シンプルなブロックのマニフェストは準備できました。ここから例を続けます。詳細は今は邪魔になるだけなので、 [高度なトピック](#advanced-topics) セクションを参照してください。今は詳細が気を散らすだけです。
### 基本実装
マニフェストの準備ができたので、ブロックの基本実装を用意できます。
ブロックの足場づくり
```python
from typing import Literal, Union, List, Optional, Type
from pydantic import Field
from inference.core.workflows.prototypes.block import (
WorkflowBlockManifest,
WorkflowBlock,
BlockResult,
)
from inference.core.workflows.execution_engine.entities.base import (
OutputDefinition,
WorkflowImageData,
)
from inference.core.workflows.execution_engine.entities.types import (
Selector,
IMAGE_KIND,
FloatZeroToOne,
FLOAT_ZERO_TO_ONE_KIND,
BOOLEAN_KIND,
)
class ImagesSimilarityManifest(WorkflowBlockManifest):
type: Literal["my_plugin/images_similarity@v1"]
name: str
image_1: Selector(kind=[IMAGE_KIND]) = Field(
description="類似度を計算する最初の画像",
)
image_2: Selector(kind=[IMAGE_KIND]) = Field(
description="類似度を計算する2番目の画像",
)
similarity_threshold: Union[
FloatZeroToOne,
Selector(kind=[FLOAT_ZERO_TO_ONE_KIND]),
] = Field(
default=0.4,
description="画像が類似しているとみなすしきい値",
)
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [
OutputDefinition(
name="images_match",
kind=[BOOLEAN_KIND],
),
]
@classmethod
def get_execution_engine_compatibility(cls) -> Optional[str]:
return ">=1.3.0,<2.0.0"
class ImagesSimilarityBlock(WorkflowBlock):
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return ImagesSimilarityManifest
def run(
self,
image_1: WorkflowImageData,
image_2: WorkflowImageData,
similarity_threshold: float,
) -> BlockResult:
pass
```
* 行 `1`, `5-6` および `8-11` ブロッククラスとそのすべてのメソッドシグネチャを正しく定義するために必要な追加シンボルを提供するため、インポート構造に変更を加えました
* 行 `53-55` クラスメソッドを定義します `get_manifest(...)` 先ほど作成したマニフェストクラスを単純に返すためのものです
* 行 `57-63` 定義する `run(...)` 関数で、Execution Engineがデータを使って目的の結果を取得するために呼び出します。なお、入力を定義するマニフェストフィールドは [image](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/kinds/image.md) kindが `WorkflowImageData` - これは、内部データ表現に準拠しています `image` に記載されているkind [kindのドキュメント](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/kinds/image.md).
### ブロックロジックの実装を提供する
それでは、のサンプル実装を追加しましょう `run(...)` メソッドをこのブロックに追加し、意味のある結果を生成できるようにします。
{% hint style="info" %}
このセクションの内容は、ブロック作成者としてWorkflowエコシステムとどのようにやり取りするかの例を示すことを目的としており、ブロックの堅牢な実装を提供するものではありません。
{% endhint %}
`run(...)` メソッドの実装
```python
from typing import Literal, Union, List, Optional, Type
from pydantic import Field
import cv2
from inference.core.workflows.prototypes.block import (
WorkflowBlockManifest,
WorkflowBlock,
BlockResult,
)
from inference.core.workflows.execution_engine.entities.base import (
OutputDefinition,
WorkflowImageData,
)
from inference.core.workflows.execution_engine.entities.types import (
Selector,
IMAGE_KIND,
FloatZeroToOne,
FLOAT_ZERO_TO_ONE_KIND,
BOOLEAN_KIND,
)
class ImagesSimilarityManifest(WorkflowBlockManifest):
type: Literal["my_plugin/images_similarity@v1"]
name: str
image_1: Selector(kind=[IMAGE_KIND]) = Field(
description="類似度を計算する最初の画像",
)
image_2: Selector(kind=[IMAGE_KIND]) = Field(
description="類似度を計算する2番目の画像",
)
similarity_threshold: Union[
FloatZeroToOne,
Selector(kind=[FLOAT_ZERO_TO_ONE_KIND]),
] = Field(
default=0.4,
description="画像が類似しているとみなすしきい値",
)
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [
OutputDefinition(
name="images_match",
kind=[BOOLEAN_KIND],
),
]
@classmethod
def get_execution_engine_compatibility(cls) -> Optional[str]:
return ">=1.3.0,<2.0.0"
class ImagesSimilarityBlock(WorkflowBlock):
def __init__(self):
self._sift = cv2.SIFT_create()
self._matcher = cv2.FlannBasedMatcher(dict(algorithm=1, trees=5), dict(checks=50))
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return ImagesSimilarityManifest
def run(
self,
image_1: WorkflowImageData,
image_2: WorkflowImageData,
similarity_threshold: float,
) -> BlockResult:
image_1_gray = cv2.cvtColor(image_1.numpy_image, cv2.COLOR_BGR2GRAY)
image_2_gray = cv2.cvtColor(image_2.numpy_image, cv2.COLOR_BGR2GRAY)
kp_1, des_1 = self._sift.detectAndCompute(image_1_gray, None)
kp_2, des_2 = self._sift.detectAndCompute(image_2_gray, None)
matches = self._matcher.knnMatch(des_1, des_2, k=2)
good_matches = []
for m, n in matches:
if m.distance < similarity_threshold * n.distance:
good_matches.append(m)
return {
"images_match": len(good_matches) > 0,
}
```
* 〜行目で `3` OpenCVをインポートします
* 行 `55-57` ブロックコンストラクタを定義します。これにより、ブロックの状態は一度だけ初期化され、連続する `run(...)` メソッドの呼び出しを通じて保持されます。たとえば、Execution Engineが動画の連続フレーム上で実行される場合です
* 行 `69-80` ブロック機能の実装を提供します。詳細はWorkflowエコシステムにとって本当に重要ではありませんが、注目すべき点がいくつかあります:
* 行 `69` および `70` を活用する `WorkflowImageData` 抽象化を用いて、どのように `numpy_image` プロパティを使って取得できるかを示しています `np.ndarray` Workflow内の画像の内部表現から。残りの `WorkflowImageData` プロパティも探索して、さらに詳しく知ることをおすすめします。
* ワークフローブロック実行の結果で、行で宣言されています `78-80` は、この場合は単なる辞書です **そのキーはマニフェストで宣言された出力名です**、行の `43`にあるとおりです。宣言されたすべての出力を必ず提供してください。そうしないとExecution Engineがエラーを発生させます。
## でブロックを公開する `プラグイン`
これでブロックは使用可能な状態ですが、Execution Engineはその存在を認識していません。これは、登録済みのプラグインが今作成したブロックをエクスポートしていないためです。ブロックのバンドルに関する詳細は [別ページ](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/block-bundling.md)に記載されていますが、残る作業はプラグインの `load_blocks(...)` 関数から返されるリストにブロッククラスを追加することです:
```python
# あなたのプラグインの __init__.py(または `inference` に直接貢献する場合の roboflow_core プラグイン)
from my_plugin.images_similarity.v1 import ImagesSimilarityBlock
# これは例のインポートです!調整が必要です
def load_blocks():
return [ImagesSimilarityBlock]
```
## 高度なトピック
### 入力のバッチを処理するブロック
場合によっては、すべての入力データを一度にバッチとして処理すると、ブロックの性能が向上することがあります。これはGPUで実行されるモデルで起こり得ます。この動作モードはWorkflowブロックでサポートされています。ここでは、そのブロックでの使い方の例を示します。
バッチを受け取るブロックの実装
```python
from typing import Literal, Union, List, Optional, Type
from pydantic import Field
import cv2
from inference.core.workflows.prototypes.block import (
WorkflowBlockManifest,
WorkflowBlock,
BlockResult,
)
from inference.core.workflows.execution_engine.entities.base import (
OutputDefinition,
WorkflowImageData,
Batch,
)
from inference.core.workflows.execution_engine.entities.types import (
Selector,
IMAGE_KIND,
FloatZeroToOne,
FLOAT_ZERO_TO_ONE_KIND,
BOOLEAN_KIND,
)
class ImagesSimilarityManifest(WorkflowBlockManifest):
type: Literal["my_plugin/images_similarity@v1"]
name: str
image_1: Selector(kind=[IMAGE_KIND]) = Field(
description="類似度を計算する最初の画像",
)
image_2: Selector(kind=[IMAGE_KIND]) = Field(
description="類似度を計算する2番目の画像",
)
similarity_threshold: Union[
FloatZeroToOne,
Selector(kind=[FLOAT_ZERO_TO_ONE_KIND]),
] = Field(
default=0.4,
description="画像が類似しているとみなすしきい値",
)
@classmethod
def get_parameters_accepting_batches(cls) -> bool:
return ["image_1", "image_2"]
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [
OutputDefinition(
name="images_match",
kind=[BOOLEAN_KIND],
),
]
@classmethod
def get_execution_engine_compatibility(cls) -> Optional[str]:
return ">=1.3.0,<2.0.0"
class ImagesSimilarityBlock(WorkflowBlock):
def __init__(self):
self._sift = cv2.SIFT_create()
self._matcher = cv2.FlannBasedMatcher(dict(algorithm=1, trees=5), dict(checks=50))
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return ImagesSimilarityManifest
def run(
self,
image_1: Batch[WorkflowImageData],
image_2: Batch[WorkflowImageData],
similarity_threshold: float,
) -> BlockResult:
results = []
for image_1_element, image_2_element in zip(image_1, image_2):
image_1_gray = cv2.cvtColor(image_1_element.numpy_image, cv2.COLOR_BGR2GRAY)
image_2_gray = cv2.cvtColor(image_2_element.numpy_image, cv2.COLOR_BGR2GRAY)
kp_1, des_1 = self._sift.detectAndCompute(image_1_gray, None)
kp_2, des_2 = self._sift.detectAndCompute(image_2_gray, None)
matches = self._matcher.knnMatch(des_1, des_2, k=2)
good_matches = []
for m, n in matches:
if m.distance < similarity_threshold * n.distance:
good_matches.append(m)
results.append({"images_match": len(good_matches) > 0})
return results
```
* 行目で `13` インポート `Batch` workflowsライブラリのコアから。このクラスは、バッチ要素を保持するための、リストに非常によく似た(ただし読み取り専用の)コンテナを表します
* 行 `40-42` ブロックのデフォルト動作を変更し、バッチを処理できるようにするクラスメソッドを定義します。ここでは、各パラメータのうち `run(...)` メソッドが **バッチ指向として認識するものを**.
* 上記の変更により、のシグネチャが変更されました `run(...)` メソッドが変わり、現在では `image_1` および `image_2` は `WorkflowImageData`のインスタンスではなく、この型の要素のバッチです。 **重要な注意:** 複数のバッチ指向パラメータがある場合、各バッチの対応する位置に関連する要素があることを期待します。つまり、たとえば画像を比較するこのブロックが `image_1[1]` を `image_2[1]` 実際に論理的に意味のある操作を行うようにする、ということです。
* 行 `74-77`, `85-86` すべてのバッチ要素にわたって処理を実行するために導入する必要があった変更を示します。必要に応じてバッチ要素を反復処理する方法も示しています
* 出力が行でどのように構築されるかに注意することが重要です `85` - バッチの各要素には、返されるリスト内にそれぞれのエントリが与えられます `run(...)` メソッド。順序はバッチ要素の順序と一致していなければなりません。各出力辞書は、ブロック出力で宣言されたすべてのキーを提供する必要があります。
バッチとスカラーの両方を受け付ける入力
それは **比較的まれですが、**ブロックが単一の入力パラメータでバッチ指向データとスカラーの両方を受け取る必要がある場合があります。Execution Engineは、 `get_parameters_accepting_batches_and_scalars(...)` ブロックマニフェストのメソッドを使ってそれを認識します。以下の例をご覧ください:
```python
from typing import Literal, Union, List, Optional, Type, Any, Dict
from pydantic import Field
from inference.core.workflows.prototypes.block import (
WorkflowBlockManifest,
WorkflowBlock,
BlockResult,
)
from inference.core.workflows.execution_engine.entities.base import (
OutputDefinition,
Batch,
)
from inference.core.workflows.execution_engine.entities.types import (
Selector,
)
class ExampleManifest(WorkflowBlockManifest):
type: Literal["my_plugin/example@v1"]
name: str
param_1: Selector()
param_2: List[Selector()]
param_3: Dict[str, Selector()]
@classmethod
def get_parameters_accepting_batches_and_scalars(cls) -> bool:
return ["param_1", "param_2", "param_3"]
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [OutputDefinition(name="dummy")]
@classmethod
def get_execution_engine_compatibility(cls) -> Optional[str]:
return ">=1.3.0,<2.0.0"
class ExampleBlock(WorkflowBlock):
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return ExampleManifest
def run(
self,
param_1: Any,
param_2: List[Any],
param_3: Dict[str, Any],
) -> BlockResult:
batch_size = None
if isinstance(param_1, Batch):
param_1_result = ... # バッチ指向パラメータで何かを行う
batch_size = len(param_1)
else:
param_1_result = ... # スカラーパラメータで何かを行う
for element in param_2:
if isinstance(element, Batch):
...
else:
...
for key, value in param_3.items():
if isinstance(element, value):
...
else:
...
if batch_size is None:
return {"dummy": "some_result"}
result = []
for _ in range(batch_size):
result.append({"dummy": "some_result"})
return result
```
* 行 `20-22` 混在した(スカラーとバッチ指向の両方の)入力データを受け取ることが想定されるマニフェストパラメータを指定します。この段階では、定義は前の例と違いがないことに注意してください。
* 行 `24-26` 指定する `get_parameters_accepting_batches_and_scalars(...)` Execution Engineに対してブロックが `run(...)` メソッドが指定されたパラメータについてスカラー入力とバッチ指向入力の両方を扱えることを伝える
* 行 `45-47` 混在した性質を持つパラメータを `run(...)` メソッドシグネチャで表します。
* 行目で `49` 期待される出力サイズを追跡する必要があることを示しています **ブロックロジック内で**。そのため、混在入力を持つブロックの実装はかなり難しいのです。通常、ブロックの `run(...)` メソッドがスカラーを扱う場合、ほとんどのケース(例外は下で説明します)では、メソッドは単一の出力辞書を構築します。同様に、バッチ指向入力が受け付けられる場合、それらの入力が期待される出力サイズを定義します。ただしこの場合は、バッチを手動で検出し、そのサイズを取得する必要があります。
* 行 `50-54` バッチ指向データが検出されたときに異なるロジックを適用することで、混在パラメータを通常どのように扱うかを示します
* 先ほど述べたように、出力の構築も混在入力の性質に合わせて調整する必要があります。これは行で示されています `65-70`
### フロー制御ブロックの実装
フロー制御ブロックは、単にデータを処理する他のブロックとはかなり異なります。ここではフロー制御ブロックの作成方法を示しますが、その前に少し理論的な説明をします:
* フロー制御ブロックとは、マニフェスト内のステップセレクターとの互換性を宣言するブロックです(ステップへのセレクターは次のように定義されます `$steps.{step_name}` - ステップ出力セレクターに似ていますが、出力名の指定がありません)
* フロー制御ブロックは出力を登録できず、返すことを想定されています `FlowControl` オブジェクト
* `FlowControl` オブジェクトは、次に進むべき次のステップ(ステップマニフェストで提供されたセレクターから)を指定します。これは、指定されたバッチ要素(SIMDフロー制御)またはワークフロー全体の実行(非SIMDフロー制御)に対して適用されます
フロー制御の実装
例では、random continueブロックの実装を示し、コメントアウトしています
```python
from typing import List, Literal, Optional, Type, Union
import random
from pydantic import Field
from inference.core.workflows.execution_engine.entities.base import (
OutputDefinition,
WorkflowImageData,
)
from inference.core.workflows.execution_engine.entities.types import (
StepSelector,
Selector,
IMAGE_KIND,
)
from inference.core.workflows.execution_engine.v1.entities import FlowControl
from inference.core.workflows.prototypes.block import (
BlockResult,
WorkflowBlock,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
type: Literal["my_plugin/random_continue@v1"]
name: str
image: Selector(kind=[IMAGE_KIND]) = ImageInputField
probability: float
next_steps: List[StepSelector] = Field(
description="式が真と評価された場合に実行されるステップへの参照",
examples=[["$steps.on_true"]],
)
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return []
@classmethod
def get_execution_engine_compatibility(cls) -> Optional[str]:
return ">=1.2.0,<2.0.0"
class RandomContinueBlockV1(WorkflowBlock):
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return BlockManifest
def run(
self,
image: WorkflowImageData,
probability: float,
next_steps: List[str],
) -> BlockResult:
if not next_steps or random.random() > probability:
return FlowControl()
return FlowControl(context=next_steps)
```
* 行目で `10` ブロックがフローを制御することをExecution Engineに通知するために使用されるステップセレクターの型注釈をインポートします
* 行目で `14` インポート `FlowControl` フロー制御ブロックから返せる唯一の有効な応答となるクラス
* 行目で `28` ステップセレクターのリストを定義します **これにより、ブロックは実質的にフロー制御ブロックになります**
* 行 `55` および `56` 出力の構築方法を示します - `FlowControl` オブジェクトはコンテキストとして `None`, `文字列` または `文字列のリスト` - `None` バッチ要素に対するフローの終了を表します。文字列は、入力で渡される次のステップのセレクターであることが想定されています。
フロー制御の実装 - バッチ版
例では、random continueブロックの実装を示し、コメントアウトしています
```python
from typing import List, Literal, Optional, Type, Union
import random
from pydantic import Field
from inference.core.workflows.execution_engine.entities.base import (
OutputDefinition,
WorkflowImageData,
Batch,
)
from inference.core.workflows.execution_engine.entities.types import (
StepSelector,
Selector,
IMAGE_KIND,
)
from inference.core.workflows.execution_engine.v1.entities import FlowControl
from inference.core.workflows.prototypes.block import (
BlockResult,
WorkflowBlock,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
type: Literal["my_plugin/random_continue@v1"]
name: str
image: Selector(kind=[IMAGE_KIND]) = ImageInputField
probability: float
next_steps: List[StepSelector] = Field(
description="式が真と評価された場合に実行されるステップへの参照",
examples=[["$steps.on_true"]],
)
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return []
@classmethod
def get_parameters_accepting_batches(cls) -> List[str]:
return ["image"]
@classmethod
def get_execution_engine_compatibility(cls) -> Optional[str]:
return ">=1.3.0,<2.0.0"
class RandomContinueBlockV1(WorkflowBlock):
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return BlockManifest
def run(
self,
image: Batch[WorkflowImageData],
probability: float,
next_steps: List[str],
) -> BlockResult:
result = []
for _ in image:
if not next_steps or random.random() > probability:
result.append(FlowControl())
result.append(FlowControl(context=next_steps))
return result
```
* 行目で `11` ブロックがフローを制御することをExecution Engineに通知するために使用されるステップセレクターの型注釈をインポートします
* 行目で `15` インポート `FlowControl` フロー制御ブロックから返せる唯一の有効な応答となるクラス
* 行 `29-32` ステップセレクターのリストを定義します **これにより、ブロックは実質的にフロー制御ブロックになります**
* 行 `38-40` の定義を含みます `get_parameters_accepting_batches(...)` ブロックが `run(...)` メソッドがバッチ指向の `image` パラメータを期待することをExecution Engineに伝えます
* 行目で `59` バッチの各要素ごとにフロー制御ガイドを返す必要があることを示しています `image` バッチ。
* そのために、行で `60` バッチの内容を反復処理します。
* 行 `61-63` 出力の構築方法を示します - `FlowControl` オブジェクトはコンテキストとして `None`, `文字列` または `文字列のリスト` - `None` バッチ要素に対するフローの終了を表します。文字列は、入力で渡される次のステップのセレクターであることが想定されています。
### ネストされたセレクター
一部のブロックでは、ブロックマニフェストフィールドにセレクターのリストまたはセレクターの辞書を指定する必要があります。バージョン `v1` のExecution Engineはネストを1階層しかサポートしていないため、セレクターのリストのリストや、セレクターのリストを含む辞書は正しく認識されません。
ネストされたセレクターの使用例を示す実用的なユースケースを以下に示します。
#### 可変数のモデルからの予測の融合
複数の分類器の予測に対して多数決を行うブロックを作成したいと仮定しましょう。その場合、runメソッドは次のようになります:
```python
# ここに疑似コード
def run(self, predictions: List[dict]) -> BlockResult:
predicted_classes = [p["class"] for p in predictions]
counts = Counter(predicted_classes)
return {"top_class": counts.most_common(1)[0]}
```
ネストされたセレクター - モデルアンサンブル
```python
from typing import List, Literal, Optional, Type
from pydantic import Field
import supervision as sv
from inference.core.workflows.execution_engine.entities.base import (
OutputDefinition,
)
from inference.core.workflows.execution_engine.entities.types import (
Selector,
OBJECT_DETECTION_PREDICTION_KIND,
)
from inference.core.workflows.prototypes.block import (
BlockResult,
WorkflowBlock,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
type: Literal["my_plugin/fusion_of_predictions@v1"]
name: str
predictions: List[Selector(kind=[OBJECT_DETECTION_PREDICTION_KIND])] = Field(
description="ステップ出力へのセレクター",
examples=[["$steps.model_1.predictions", "$steps.model_2.predictions"]],
)
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [
OutputDefinition(
name="predictions",
kind=[OBJECT_DETECTION_PREDICTION_KIND],
)
]
@classmethod
def get_execution_engine_compatibility(cls) -> Optional[str]:
return ">=1.3.0,<2.0.0"
class FusionBlockV1(WorkflowBlock):
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return BlockManifest
def run(
self,
predictions: List[sv.Detections],
) -> BlockResult:
merged = sv.Detections.merge(predictions)
return {"predictions": merged}
```
* 行 `23-26` セレクターのリストを受け取れるマニフェストフィールドの定義方法を示します
* 行目で `50` ブロックの入力として何 `run(...)` を期待するかを示します `predictions` フィールドは `List[Batch[sv.Detections]`
このようなブロックは、次のステップ宣言と互換性があります:
```json
{
"type": "my_plugin/fusion_of_predictions@v1",
"name": "my_step",
"predictions": [
"$steps.model_1.predictions",
"$steps.model_2.predictions"
]
}
```
#### 動的パラメータを許可するデータ変換付きブロック
場合によっては、ブロックが「名前付き」セレクタのグループを受け入れる必要があります。これらの名前と値は Workflow 定義の作成者が定義します。そのような場合、ブロックの manifest はセレクタの辞書を受け入れる必要があり、キーがそれらのセレクタ名として機能します。
ネストされたセレクタ - 名前付きセレクタ
```python
from typing import List, Literal, Optional, Type, Any
from pydantic import Field
import supervision as sv
from inference.core.workflows.execution_engine.entities.base import (
OutputDefinition,
)
from inference.core.workflows.execution_engine.entities.types import (
Selector
)
from inference.core.workflows.prototypes.block import (
BlockResult,
WorkflowBlock,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
type: Literal["my_plugin/named_selectors_example@v1"]
name: str
data: Dict[str, Selector()] = Field(
description="ステップ出力へのセレクター",
examples=[{"a": $steps.model_1.predictions", "b": "$Inputs.data"}],
)
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [
OutputDefinition(name="my_output", kind=[]),
]
@classmethod
def get_execution_engine_compatibility(cls) -> Optional[str]:
return ">=1.3.0,<2.0.0"
class BlockWithNamedSelectorsV1(WorkflowBlock):
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return BlockManifest
def run(
self,
data: Dict[str, Any],
) -> BlockResult:
...
return {"my_output": ...}
```
* 行 `22-25` セレクタの辞書を受け入れ可能な manifest フィールドを定義する方法を示します。セレクタ名と値の対応を提供します
* 行目で `46` ブロックの入力として何 `run(...)` メソッド - セレクタで参照されるオブジェクトの辞書です。ブロックがバッチを受け入れる場合、入力型は `data` フィールドは `Dict[str, Union[Batch[Any], Any]]`。バッチなしの場合、セレクタで参照される非バッチ指向データは自動的にブロードキャストされます。一方、バッチを受け入れるブロックでは - `Batch` コンテナはバッチ指向入力のみを包み、他の入力は単一値として渡されます。
このようなブロックは、次のステップ宣言と互換性があります:
```json
{
"type": "my_plugin/named_selectors_example@v1",
"name": "my_step",
"data": {
"a": "$steps.model_1.predictions",
"b": "$inputs.my_parameter"
}
}
```
実際の影響は次のとおりです:
* の下の `data["a"]` 内の `run(...)` モデルの予測を見つけられます。たとえば `sv.Detections` もし `model_1` が物体検出モデルであれば
* の下の `data["b"]` 内の `run(...)`、という名前の入力パラメータの値を見つけられます `my_parameter`
### 入力と出力の次元 vs `run(...)` メソッドが
ブロック入力の次元は、形成において重要な役割を果たします `run(...)` メソッドのシグネチャを形作る上で重要であり、そのためシステムは入力間の次元レベル差に厳格な上限を課しています(許容される最大差は `1`)。この制約は、ブロック作成時の一貫性と予測可能性を確保するために重要です。
次元差が制御されていなければ、 `run(...)` メソッドの構造を予測するのが難しくなり、開発はより困難で信頼性も低くなります。そのため、このプロパティの検証は Workflow のコンパイル時に厳格に強制されます。
同様に、出力の次元もメソッドシグネチャと期待される出力形式に影響します。エコシステムは以下のシナリオをサポートします:
* すべての入力が **同じ次元を持ち** 、出力は **変化しない** 次元 - 基本ケース
* すべての入力が **同じ次元を持ち** 、出力は **減少する** 次元
* すべての入力が **同じ次元を持ち** 、出力は **増加する** 次元
* 入力が **異なる次元を持つ** 、出力は次の次元を維持できます **参照入力の**
入力/出力の次元のその他の組み合わせは、一貫性を確保し、メソッドシグネチャの曖昧さを防ぐため許可されません。
`run(...)` メソッドに対する次元の影響 - バッチ無効
**出力次元の増加**
この例では、予測に基づいて画像を動的にクロップします。
```python
from typing import Dict, List, Literal, Optional, Type, Union
from uuid import uuid4
from inference.core.workflows.execution_engine.constants import DETECTION_ID_KEY
from inference.core.workflows.execution_engine.entities.base import (
OutputDefinition,
WorkflowImageData,
ImageParentMetadata,
)
from inference.core.workflows.execution_engine.entities.types import (
IMAGE_KIND,
OBJECT_DETECTION_PREDICTION_KIND,
Selector,
)
from inference.core.workflows.prototypes.block import (
BlockResult,
WorkflowBlock,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
type: Literal["my_block/dynamic_crop@v1"]
image: Selector(kind=[IMAGE_KIND])
predictions: Selector(
kind=[OBJECT_DETECTION_PREDICTION_KIND],
)
@classmethod
def get_output_dimensionality_offset(cls) -> int:
return 1
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [
OutputDefinition(name="crops", kind=[IMAGE_KIND]),
]
@classmethod
def get_execution_engine_compatibility(cls) -> Optional[str]:
return ">=1.3.0,<2.0.0"
class DynamicCropBlockV1(WorkflowBlock):
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return BlockManifest
def run(
self,
image: WorkflowImageData,
predictions: sv.Detections,
) -> BlockResult:
crops = []
for (x_min, y_min, x_max, y_max) in predictions.xyxy.round().astype(dtype=int):
cropped_image = image.numpy_image[y_min:y_max, x_min:x_max]
parent_metadata = ImageParentMetadata(parent_id=f"{uuid4()}")
if cropped_image.size:
result = WorkflowImageData(
parent_metadata=parent_metadata,
numpy_image=cropped_image,
)
else:
result = None
crops.append({"crops": result})
return crops
```
* 行では `28-30` manifest クラスは出力の次元オフセットを宣言しています。値 `1` は、次元レベルに `1` を加えるものと理解してください
* また、行 `63`では、ブロックは空の画像を以降の処理から除外しますが、 `None` 出力付きの辞書の代わりに配置します。これは条件付き実行で使われるのと同じ Execution Engine の挙動を利用します。データポイントは下流処理から除外されます(ただし、下流に空入力を要求するステップがある場合を除く)。
* 行では `64-65` 単一入力に対する結果 `image` および `predictions` が収集されます。これは、登録済みのすべての出力をキーとする辞書のリストであることを意味します。Execution Engine は、このステップが各入力要素に対する要素のバッチを返すことを理解し、下流ステップの実行中に追跡できるよう、入れ子構造のインデックスを作成します。
**出力次元の減少**
この例では、ブロックはクロップ予測を可視化し、すべてのクロップ予測を 1 つの出力画像にまとめたタイルを作成します。
```python
from typing import List, Literal, Type, Union
import supervision as sv
from inference.core.utils.drawing import create_tiles
from inference.core.workflows.execution_engine.entities.base import (
Batch,
OutputDefinition,
WorkflowImageData,
)
from inference.core.workflows.execution_engine.entities.types import (
IMAGE_KIND,
OBJECT_DETECTION_PREDICTION_KIND,
Selector,
)
from inference.core.workflows.prototypes.block import (
BlockResult,
WorkflowBlock,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
type: Literal["my_plugin/tile_detections@v1"]
crops: Selector(kind=[IMAGE_KIND])
crops_predictions: Selector(
kind=[OBJECT_DETECTION_PREDICTION_KIND]
)
scalar_parameter: Union[float, Selector()]
@classmethod
def get_output_dimensionality_offset(cls) -> int:
return -1
@classmethod
def get_parameters_enforcing_auto_batch_casting(cls) -> List[str]:
return ["crops", "crops_predictions"]
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [
OutputDefinition(name="visualisations", kind=[IMAGE_KIND]),
]
class TileDetectionsBlock(WorkflowBlock):
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return BlockManifest
def run(
self,
crops: Batch[WorkflowImageData],
crops_predictions: Batch[sv.Detections],
scalar_parameter: float,
) -> BlockResult:
annotator = sv.BoxAnnotator()
visualisations = []
for image, prediction in zip(crops, crops_predictions):
annotated_image = annotator.annotate(
image.numpy_image.copy(),
prediction,
)
visualisations.append(annotated_image)
tile = create_tiles(visualisations)
return {"visualisations": tile}
```
* 行では `30-32` manifest クラスは出力の次元オフセットを宣言しています。値 `-1` は、次元レベルを次の分だけ減少させるものと理解してください `1`
* 行では `34-36` manifest クラスは `run(...)` シグネチャが常に安定になるよう、オートバッチキャストの対象となるメソッド入力を宣言しています。オートバッチキャストは Execution Engine に導入されました `v0.1.6.0`
* を参照してください [変更履歴](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/execution-engine-changelog.md) 詳細は
* 行では `53-55` 出力次元の減少がメソッドシグネチャに与える影響を確認できます。最初の 2 つの入力(行で宣言された `36`)は、人工的に次の中に包まれます `Batch[]` コンテナ。一方、 `scalar_parameter` はプリミティブ型のままです。これは、すべての入力が同じ次元を持つ場合に、最終次元レベルを占めるすべての要素へアクセスできるようにするため、出力次元の減少時に Execution Engine が自動的に行うものです。もちろん、トップレベルのバッチ内で同じ要素に関連する要素のみがグループ化されます。たとえば、2 枚の入力画像をクロップした場合、それぞれの画像からのクロップは別々にグループ化されます。
* 行 `65-66` 出力がどのように構築されるかを示します。単一の値が返され、その値は次元が減少した出力バッチ内で Execution Engine によってインデックス付けされます
**異なる入力次元**
この例では、ブロックは元画像のクロップに基づいて予測された検出結果を統合します。結果として、部分的なものをすべて統合した単一の検出結果を提供します。
```python
from copy import deepcopy
from typing import Dict, List, Literal, Optional, Type, Union
import numpy as np
import supervision as sv
from inference.core.workflows.execution_engine.entities.base import (
Batch,
OutputDefinition,
WorkflowImageData,
)
from inference.core.workflows.execution_engine.entities.types import (
OBJECT_DETECTION_PREDICTION_KIND,
Selector,
IMAGE_KIND,
)
from inference.core.workflows.prototypes.block import (
BlockResult,
WorkflowBlock,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
type: Literal["my_plugin/stitch@v1"]
image: Selector(kind=[IMAGE_KIND])
image_predictions: Selector(
kind=[OBJECT_DETECTION_PREDICTION_KIND],
)
@classmethod
def get_input_dimensionality_offsets(cls) -> Dict[str, int]:
return {
"image": 0,
"image_predictions": 1,
}
@classmethod
def get_dimensionality_reference_property(cls) -> Optional[str]:
return "image"
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [
OutputDefinition(
name="predictions",
kind=[
OBJECT_DETECTION_PREDICTION_KIND,
],
),
]
class StitchDetectionsNonBatchBlock(WorkflowBlock):
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return BlockManifest
def run(
self,
image: WorkflowImageData,
image_predictions: Batch[sv.Detections],
) -> BlockResult:
image_predictions = [deepcopy(p) for p in image_predictions if len(p)]
for p in image_predictions:
coords = p["parent_coordinates"][0]
p.xyxy += np.concatenate((coords, coords))
return {"predictions": sv.Detections.merge(image_predictions)}
```
* 行では `31-36` manifest クラスは入力の次元オフセットを宣言しており、 `image` パラメータがトップレベルであること、および `image_predictions` 予測のネストされたバッチであることを示しています
* 異なる入力次元が宣言される場合は、次元参照プロパティを指定する必要があります(行を参照 `38-40`)- この次元レベルが出力次元の計算に使用されます - この場合、 `image`。この選択は、期待される結果形式に影響します。選択したシナリオでは、登録済み出力キーをすべて含む単一の辞書を返す必要があります。もし選択が `image_predictions`なら、辞書のリスト(サイズは `image_predictions` バッチの長さに等しい)を返します。言い換えると、 `get_dimensionality_reference_property(... )` どの次元レベルを出力に関連付けるべきかを示します
* 行 `63-64` 行で指定された次元オフセットの影響を示します `31-36`。明らかに `image_predictions` は、 `image`に関するネストされたバッチです。もちろん、特定の `画像` に関連するネストされた予測のみがバッチとしてまとめられ、実行時にメソッドへ渡されます。
* 前述のとおり、行 `69` は、出力を単一の辞書として構築します。これは、出力を次の次元レベルで登録しているためです `image` (これも単一要素として送られました)
`run(...)` メソッドに対する次元の影響 - バッチ有効
**出力次元の増加**
この例では、予測に基づいて画像を動的にクロップします。
```python
from typing import Dict, List, Literal, Optional, Type, Union
from uuid import uuid4
from inference.core.workflows.execution_engine.constants import DETECTION_ID_KEY
from inference.core.workflows.execution_engine.entities.base import (
OutputDefinition,
WorkflowImageData,
ImageParentMetadata,
Batch,
)
from inference.core.workflows.execution_engine.entities.types import (
IMAGE_KIND,
OBJECT_DETECTION_PREDICTION_KIND,
Selector,
)
from inference.core.workflows.prototypes.block import (
BlockResult,
WorkflowBlock,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
type: Literal["my_block/dynamic_crop@v1"]
image: Selector(kind=[IMAGE_KIND])
predictions: Selector(
kind=[OBJECT_DETECTION_PREDICTION_KIND],
)
@classmethod
def get_parameters_accepting_batches(cls) -> bool:
return ["image", "predictions"]
@classmethod
def get_output_dimensionality_offset(cls) -> int:
return 1
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [
OutputDefinition(name="crops", kind=[IMAGE_KIND]),
]
@classmethod
def get_execution_engine_compatibility(cls) -> Optional[str]:
return ">=1.3.0,<2.0.0"
class DynamicCropBlockV1(WorkflowBlock):
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return BlockManifest
def run(
self,
image: Batch[WorkflowImageData],
predictions: Batch[sv.Detections],
) -> BlockResult:
results = []
for single_image, detections in zip(image, predictions):
crops = []
for (x_min, y_min, x_max, y_max) in detections.xyxy.round().astype(dtype=int):
cropped_image = single_image.numpy_image[y_min:y_max, x_min:x_max]
parent_metadata = ImageParentMetadata(parent_id=f"{uuid4()}")
if cropped_image.size:
result = WorkflowImageData(
parent_metadata=parent_metadata,
numpy_image=cropped_image,
)
else:
result = None
crops.append({"crops": result})
results.append(crops)
return results
```
* 行では `29-31` manifest は、ブロックが入力のバッチを受け入れることを宣言しています
* 行では `33-35` manifest クラスは出力の次元オフセットを宣言しています。値 `1` は、次元レベルに `1` を加えるものと理解してください
* 行では `55-66`、入力パラメータのシグネチャは、それを反映して `run(...)` メソッドは同じ次元の入力に対して実行され、それらの入力はバッチとして提供されます
* また、行 `70`では、ブロックは空の画像を以降の処理から除外しますが、 `None` 出力付きの辞書の代わりに配置します。これは条件付き実行で使われるのと同じ Execution Engine の挙動を利用します。データポイントは下流処理から除外されます(ただし、下流に空入力を要求するステップがある場合を除く)。
* 行で示されている出力の構築は `71-73` 2 つのネスト階層を示しています。まず、ブロックはバッチ上で動作するため、出力のリスト、つまり入力バッチ要素ごとに 1 つの出力を返すことが期待されます。さらに、各入力バッチ要素のこの出力要素はネストされたバッチであることがわかります。そのため、各入力画像と予測に対して、ブロックは出力のリストを生成します。そのリストの各要素は、宣言された各出力の値を提供する辞書です。
**出力次元の減少**
この例では、ブロックはクロップ予測を可視化し、すべてのクロップ予測を 1 つの出力画像にまとめたタイルを作成します。
```python
from typing import List, Literal, Type, Union
import supervision as sv
from inference.core.utils.drawing import create_tiles
from inference.core.workflows.execution_engine.entities.base import (
Batch,
OutputDefinition,
WorkflowImageData,
)
from inference.core.workflows.execution_engine.entities.types import (
IMAGE_KIND,
OBJECT_DETECTION_PREDICTION_KIND,
Selector,
)
from inference.core.workflows.prototypes.block import (
BlockResult,
WorkflowBlock,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
type: Literal["my_plugin/tile_detections@v1"]
images_crops: Selector(kind=[IMAGE_KIND])
crops_predictions: Selector(
kind=[OBJECT_DETECTION_PREDICTION_KIND]
)
@classmethod
def get_parameters_accepting_batches(cls) -> bool:
return ["images_crops", "crops_predictions"]
@classmethod
def get_output_dimensionality_offset(cls) -> int:
return -1
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [
OutputDefinition(name="visualisations", kind=[IMAGE_KIND]),
]
class TileDetectionsBlock(WorkflowBlock):
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return BlockManifest
def run(
self,
images_crops: Batch[Batch[WorkflowImageData]],
crops_predictions: Batch[Batch[sv.Detections]],
) -> BlockResult:
annotator = sv.BoxAnnotator()
visualisations = []
for image_crops, crop_predictions in zip(images_crops, crops_predictions):
visualisations_batch_element = []
for image, prediction in zip(image_crops, crop_predictions):
annotated_image = annotator.annotate(
image.numpy_image.copy(),
prediction,
)
visualisations_batch_element.append(annotated_image)
tile = create_tiles(visualisations_batch_element)
visualisations.append({"visualisations": tile})
return visualisations
```
* 行 `29-31` manifest は、ブロックが入力としてバッチを受け取ることを期待していることを示しています
* 行では `33-35` manifest クラスは出力の次元オフセットを宣言しています。値 `-1` は、次元レベルを次の分だけ減少させるものと理解してください `1`
* 行では `52-53` 出力次元の減少とバッチ処理がメソッドシグネチャに与える影響を確認できます。最初の「層」は `Batch[]` manifest がブロックに入力バッチの受け入れを宣言していることの副作用です。2 つ目の「層」は出力次元の減少に由来します。Execution Engine は、減少させる次元を追加の `Batch[]` 入力として提供されたコンテナに包み込むため、プログラマは特定のトップレベルバッチ要素に属するすべてのネストされたバッチ要素を収集できます。
* 行 `66-67` 出力がどのように構築されるかを示します。各トップレベルバッチ要素について、ブロックはすべてのクロップと予測を集約し、1 つのタイルを作成します。ブロックは入力バッチを受け入れるため、この処理の結果、トップレベルバッチ要素ごとに 1 つのタイルが作られます。そのため、辞書のリストを返すことが期待されます。
**異なる入力次元**
この例では、ブロックは元画像のクロップに基づいて予測された検出結果を統合します。結果として、部分的なものをすべて統合した単一の検出結果を提供します。
```python
from copy import deepcopy
from typing import Dict, List, Literal, Optional, Type, Union
import numpy as np
import supervision as sv
from inference.core.workflows.execution_engine.entities.base import (
Batch,
OutputDefinition,
WorkflowImageData,
)
from inference.core.workflows.execution_engine.entities.types import (
OBJECT_DETECTION_PREDICTION_KIND,
Selector,
IMAGE_KIND,
)
from inference.core.workflows.prototypes.block import (
BlockResult,
WorkflowBlock,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
type: Literal["my_plugin/stitch@v1"]
images: Selector(kind=[IMAGE_KIND])
images_predictions: Selector(
kind=[OBJECT_DETECTION_PREDICTION_KIND],
)
@classmethod
def get_parameters_accepting_batches(cls) -> bool:
return ["images", "images_predictions"]
@classmethod
def get_input_dimensionality_offsets(cls) -> Dict[str, int]:
return {
"image": 0,
"image_predictions": 1,
}
@classmethod
def get_dimensionality_reference_property(cls) -> Optional[str]:
return "image"
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [
OutputDefinition(
name="predictions",
kind=[
OBJECT_DETECTION_PREDICTION_KIND,
],
),
]
class StitchDetectionsBatchBlock(WorkflowBlock):
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return BlockManifest
def run(
self,
images: Batch[WorkflowImageData],
images_predictions: Batch[Batch[sv.Detections]],
) -> BlockResult:
result = []
for image, image_predictions in zip(images, images_predictions):
image_predictions = [deepcopy(p) for p in image_predictions if len(p)]
for p in image_predictions:
coords = p["parent_coordinates"][0]
p.xyxy += np.concatenate((coords, coords))
merged_prediction = sv.Detections.merge(image_predictions)
result.append({"predictions": merged_prediction})
return result
```
* 行 `31-33` manifest は、ブロックが入力としてバッチを受け取ることを期待していることを示しています
* 行では `35-40` manifest クラスは入力の次元オフセットを宣言しており、 `image` パラメータがトップレベルであること、および `image_predictions` 予測のネストされたバッチであることを示しています
* 異なる入力次元が宣言される場合は、次元参照プロパティを指定する必要があります(行を参照 `42-44`)- この次元レベルが出力次元の計算に使用されます - この場合、 `image`。この選択は、期待される結果形式に影響します。選択したシナリオでは、 `image` バッチの各要素ごとに単一の辞書を返す必要があります。もし選択が `image_predictions`なら、ネストされた `image_predictions` バッチの長さに等しい辞書のリストを、各入力 `image` バッチ要素ごとに返します。
* 行 `66-67` 行で指定された次元オフセットの影響を示します `35-40` および行でのバッチ処理の宣言も `32-34`。最初の「層」は `Batch[]` コンテナは後者のネストされた `Batch[Batch[]]` に由来し、 `images_predictions` 入力次元オフセットの定義に基づいています。明らかに `image_predictions` は、特定の要素に関連する予測のバッチを保持しています `image` バッチ。
* 前述のとおり、行 `76-77` は、各 `image` バッチ要素ごとに単一の辞書となる出力を構築します
### 空の入力を受け入れるブロック
前述のとおり、Workflow の実行中に一部のバッチ要素が「空」になることがあります。これはいくつかの要因で起こりえます:
* **フロー制御の仕組み:** 実行の特定分岐が、特定のバッチ要素を隠し、後続ステップで処理されないようにすることがあります。
* **データ処理ブロックでは:** 場合によっては、ブロックが特定のデータポイントに対して意味のある出力を生成できないことがあります。たとえば、Dynamic Crop ブロックは、バウンディングボックスのサイズが 0 の場合にクロップ画像を生成できません。
一部のブロックは、欠落した出力をデフォルト値で置き換えるような、これらの空入力を処理するよう設計されています。このブロックは、Workflow で構造化された出力を構築する際に特に役立ちます。いくつかの要素が空でも出力に欠落要素がなくなるため、解析しにくくなります。
空の入力を受け入れるブロック
```python
from typing import Any, List, Literal, Optional, Type
from inference.core.workflows.execution_engine.entities.base import (
Batch,
OutputDefinition,
)
from inference.core.workflows.execution_engine.entities.types import Selector
from inference.core.workflows.prototypes.block import (
BlockResult,
WorkflowBlock,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
type: Literal["my_plugin/first_non_empty_or_default@v1"]
data: List[Selector()]
default: Any
@classmethod
def accepts_empty_values(cls) -> bool:
return True
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [OutputDefinition(name="output")]
@classmethod
def get_execution_engine_compatibility(cls) -> Optional[str]:
return ">=1.3.0,<2.0.0"
class FirstNonEmptyOrDefaultBlockV1(WorkflowBlock):
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return BlockManifest
def run(
self,
data: Batch[Optional[Any]],
default: Any,
) -> BlockResult:
result = default
for data_element in data:
if data_element is not None:
return {"output": data_element}
return {"output": result}
```
* 行では `20-22` ブロックが空入力を受け入れると宣言している記述を見つけるかもしれません
* 行の結果として `20-22` は行に見られます `41`。シグネチャが入力が `Batch` 空要素を含みうることを示している場合です。実際には、このブロックは空の値を置き換える「人工的」な出力を生成します。これにより、このブロックの出力を参照する、空入力を受け入れないブロックに対して、それらの出力を「見える」ようにできます。Execution Engine が実行時に生成されたデータで置き換える各入力は、オプション要素を含む可能性があると考えるべきです。
### カスタムコンストラクターパラメータを持つブロック
一部のブロックは、動作するために外部で構築されたオブジェクトを必要とすることがあります。そのような場合、Workflows Execution Engine の役割はそれらのエンティティをブロックに渡し、使用可能にすることです。その仕組みは [Workflows Compiler を紹介するページで説明されています](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/compiler.md)。これは、ブロッククラスからステップを動的に構築する責任を持つコンポーネントだからです。
コンストラクターパラメータは次の条件を満たす必要があります:
* ブロックによって要求される - クラスメソッドを使用して `WorkflowBlock.get_init_parameters(... )`
* Workflows Execution Engine を実行している環境で提供される:
* 次のように直接 [この](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/execution-engine.md#running-the-execution-engine-in-python) 例
* デフォルトを使用して [Workflow プラグインに登録された](https://docs.roboflow.com/workflows/ja/gaido/developer-guide/block-bundling.md)
ブロックを定義しながら init パラメータを要求する方法を見てみましょう。
コンストラクターパラメータを要求するブロック
```python
from typing import Any, List, Literal, Optional, Type
from inference.core.workflows.execution_engine.entities.base import (
Batch,
OutputDefinition,
)
from inference.core.workflows.execution_engine.entities.types import Selector
from inference.core.workflows.prototypes.block import (
BlockResult,
WorkflowBlock,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
type: Literal["my_plugin/example@v1"]
data: List[Selector()]
@classmethod
def describe_outputs(cls) -> List[OutputDefinition]:
return [OutputDefinition(name="output")]
@classmethod
def get_execution_engine_compatibility(cls) -> Optional[str]:
return ">=1.0.0,<2.0.0"
class ExampleBlock(WorkflowBlock):
def __init__(my_parameter: int):
self._my_parameter = my_parameter
@classmethod
def get_init_parameters(cls) -> List[str]:
return ["my_parameter"]
@classmethod
def get_manifest(cls) -> Type[WorkflowBlockManifest]:
return BlockManifest
def run(
self,
data: Batch[Any],
) -> BlockResult:
pass
```
* 行 `30-31` パラメータなしではないクラスコンストラクタを宣言します
* ブロックがカスタム初期化を必要とすることを Execution Engine に知らせるために `get_init_parameters(...)` 行の `33-35` 提供されなければならないすべてのパラメータ名を列挙します
### エアギャップ / オフライン可用性メタデータ
インターネット接続なしで動作する可能性のある環境(エアギャップ展開)向けにブロックを作成する場合、 `WorkflowBlockManifest` 3 つのオプションの classmethod を公開します。これらをオーバーライドすると、エアギャップ対応の workflow ビルダーがどのブロックをオフラインで使用できるか判断しやすくなります。
3 つすべてに妥当なデフォルトがあるため、既存のブロックには **変更は不要です**.
#### `get_air_gapped_availability()`
ブロックがインターネットなしで動作できるかを宣言します。OpenAI、Anthropic などのクラウド API を呼び出すブロックでは、これをオーバーライドしてください。
```python
from inference.core.workflows.prototypes.block import (
AirGappedAvailability,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
# ...
@classmethod
def get_air_gapped_availability(cls) -> AirGappedAvailability:
return AirGappedAvailability(
available=False,
reason="requires_internet",
)
```
デフォルトでは次を返します `AirGappedAvailability(available=True)` - 純粋なロジックブロック、ローカルネットワークブロック、および外部接続を必要としないすべてのブロックに適しています。
#### `get_supported_model_variants()`
ローカルに事前キャッシュできる重みを持つ基盤モデルブロックでは、モデルバリアント ID のリストを返します。ブロックは次の場合にオフラインで利用可能と見なされます **いずれかの** バリアントにキャッシュ済みアーティファクトがあること。
```python
class BlockManifest(WorkflowBlockManifest):
# ...
@classmethod
def get_supported_model_variants(cls) -> Optional[List[str]]:
return [
"sam2/hiera_large",
"sam2/hiera_small",
"sam2/hiera_tiny",
"sam2/hiera_b_plus",
]
```
デフォルトでは次を返します `None`、つまりこのブロックはローカルにキャッシュされたモデル重みに依存しません。
#### `get_compatible_task_types()`
Roboflow モデルを受け入れるブロックについて、そのブロックが処理できるタスクタイプを返します。エアギャップ環境のビルダーは、キャッシュされたユーザーモデルを互換性のあるブロックに対応付けるためにこれを使用します。
```python
class BlockManifest(WorkflowBlockManifest):
# ...
@classmethod
def get_compatible_task_types(cls) -> Optional[List[str]]:
return ["object-detection"]
```
デフォルトでは次を返します `None` - Roboflow モデルでパラメータ化されないブロック(基盤モデル、ロジックブロック、シンクなど)に適しています。
### ランタイム制約
一部のブロックは、デプロイ先のランタイム(ホスト型サーバーレス、専用デプロイ、自ホスト、推論パイプライン)、ステップ実行モード(ローカル vs. リモート)、入力モード(画像 vs. 動画)によって、動作が異なったり、まったく失敗したりします。 `get_restrictions()` に `WorkflowBlockManifest` これらの注意点をブロック内に一度だけ宣言しておけば、実行エンジン、スキーマエンドポイント、自動生成されるブロックギャラリーのすべてで一貫して表示できます。
デフォルトでは次を返します `[]`そのため、既存のブロックは **変更は不要です**.
#### 重大度: `ソフト` 対 `ハード`
各制約には `重大度`:
* **`Severity.SOFT`** - ブロックは最後まで実行され、正しい出力形状を返しますが、値が劣化していたり無意味だったりします(たとえば、リクエスト間でトラッカー ID がリセットされる、クールダウンがスロットリングしない、ファイルが一時ディスクに書き込まれるなど)。ワークフロー自体は動きますが、結果はユーザーの期待どおりではありません。
* **`Severity.HARD`** - ブロックは実行されない/例外を送出する/このランタイムでは利用可能な出力を生成できません。エンジンはコンパイルを拒否するか、即時失敗すべきです。
#### 制約の適用範囲を限定する
ある `RuntimeRestriction` 3つの軸の任意の組み合わせに沿って自身の適用範囲を定められます。ある軸が `None`のままなら、その制約はその軸のすべての値に適用されます。
* `applies_to_runtimes`: `Runtime.HOSTED_SERVERLESS`, `Runtime.DEDICATED_DEPLOYMENT`, `Runtime.SELF_HOSTED_CPU`, `Runtime.SELF_HOSTED_GPU`, `Runtime.INFERENCE_PIPELINE`.
* `applies_to_step_execution_modes`: `StepExecutionMode.LOCAL`, `StepExecutionMode.REMOTE`.
* `applies_to_input_modes`: `RuntimeInputMode.IMAGE`, `RuntimeInputMode.VIDEO`.
その `注記` フィールドは、失敗モードや劣化した挙動についての、人間が読める1行の説明です。何が起きるのか(例: "track\_ids reset between requests", "writes to ephemeral /tmp")を述べてください。抽象的な前提条件ではありません。
#### 共有プリセット
ほとんどの注意点は共通パターンのどれかに当てはまるため、再利用可能なプリセットがデータクラスと並んでエクスポートされ、コードベース全体で文言の一貫性を保っています。まずはこちらを使ってください:
* `STATEFUL_VIDEO_HTTP_SOFT_RESTRICTION` - 動画トラッキング/カウント/集計ブロック向け。動画ごとの状態がプロセスメモリにあり、ステートレスな HTTP リクエスト間でリセットされます。
* `COOLDOWN_HTTP_SOFT_RESTRICTION` - クールダウン/レート制限タイマーがプロセスメモリに保持されるブロック向けで、そのため複数レプリカの HTTP ランタイムではスロットリングしません。
* `STILL_IMAGE_INPUT_SOFT_RESTRICTION` - 時間的コンテキスト(動画や繰り返しフレーム)に依存し、静止画像では利点がほとんど、またはまったくないブロック向けです。
#### 例
動画ごとの状態を保持し、静止画像では無意味でもあるラインカウンター・ブロックは、両方の制約を宣言します:
```python
from typing import List
from inference.core.workflows.prototypes.block import (
STATEFUL_VIDEO_HTTP_SOFT_RESTRICTION,
STILL_IMAGE_INPUT_SOFT_RESTRICTION,
RuntimeRestriction,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
# ...
@classmethod
def get_restrictions(cls) -> List[RuntimeRestriction]:
return [
STATEFUL_VIDEO_HTTP_SOFT_RESTRICTION,
STILL_IMAGE_INPUT_SOFT_RESTRICTION,
]
```
カスタム制約(たとえば `Severity.HARD` ホスト型サーバーレス ランタイムには存在しない GPU ハードウェアを必要とするブロック)は、インラインで宣言します:
```python
from inference.core.workflows.prototypes.block import (
Runtime,
RuntimeRestriction,
Severity,
WorkflowBlockManifest,
)
class BlockManifest(WorkflowBlockManifest):
# ...
@classmethod
def get_restrictions(cls) -> List[RuntimeRestriction]:
return [
RuntimeRestriction(
severity=Severity.HARD,
note="このブロックには CUDA GPU が必要です。CPU のみのワーカーでは例外を送出します。",
applies_to_runtimes=[
Runtime.HOSTED_SERVERLESS,
Runtime.SELF_HOSTED_CPU,
],
),
]
```
このように宣言された制約は、次の3か所に表示されます:
1. その `describe_interface` HTTP ペイロード( `RuntimeRestriction.to_dict()`)を通じて、ワークフローのクライアントやビルダーがワークフロー実行前にユーザーへ警告できるようになります。
2. ブロックの自動生成ブロックギャラリーページで、「Runtime compatibility」セクションの直後にある **プロパティ**.
3. 実行エンジン。これは、 `Severity.HARD` 現在のランタイムに対する制約について fail-fast するかを選べます。
### 依存リソースの宣言
多くのブロックは実行時に外部リソースを必要とします。たとえば、Roboflow で学習したモデルや基盤モデルの重み、Roboflow プロジェクト(例: アクティブラーニングの対象、データセットのアップロード先)、またはサードパーティのホスト型モデル(OpenAI、Anthropic、OpenRouter など)です。ワークフローが実際に実行されるまで、システム内の何もどのリソースが必要になるかを知りません。
オーバーライドすることで `discover_dependent_resources()` ブロックマニフェスト上でそのギャップを埋めます。このメソッドは **解析済みマニフェストインスタンス**に対して呼び出されるため、特定のステップの具体的なフィールド値から宣言を計算できます。これにより呼び出し側は、何も実行せずにコンパイル時にワークフロー全体のリソースを静的に列挙できます。これは、予測可能な実行時間のためにモデル重みを事前ロードしたり、API キーが参照されるすべてのモデルとプロジェクトにアクセスできるかを事前に検証したりする用途を可能にします。
```python
def discover_dependent_resources(self) -> Optional[List[DependentResource]]:
...
```
デフォルトでは次を返します `None`つまり、このブロックは **宣言しません** 依存関係を。呼び出し側はこれを *不明*と扱う必要があります。これは意図的に、 `[]`、これはブロックが外部リソースを必要としないことを明示的に宣言します。既存のブロックに変更は不要です。リソースを使うブロックはオーバーライドしてください。
#### リソース・エンベロープ
ブロックはリソースの形を勝手に作り出しません。エンベロープは Execution Engine によって管理されます。ある `DependentResource` は `resource_type` を、その型に登録された型付き(pydantic)メタデータエンティティと組み合わせます:
* `DependentResourceType.ROBOFLOW_PLATFORM_MODEL` → `RoboflowPlatformModelMetadata(model_id, required_action, execution_location)` — Roboflow プラットフォーム経由で提供されるモデル。合成された ID を持つ基盤/コアモデルも含みます(例: `clip/ViT-B-32`). `required_action` は使用の性質を示します: `ModelRequiredAction.EXECUTION` (重みが取得される、または推論が要求される)か `ModelRequiredAction.ACCESS` (モデルエンティティがプラットフォーム上で到達可能であればよいだけです。たとえば、メタデータを付与する監視シンクなど)。実行時には、 `execution_location` は `LOCAL`, `REMOTE`、または `ENVIRONMENT_DEFINED` ローカル/リモートの別が実行時に `WORKFLOWS_STEP_EXECUTION_MODE` によって決まり、コンパイル時には判断できない場合です(ステップ実行モードで分岐するモデルブロックのデフォルトです)。
* `DependentResourceType.ROBOFLOW_PLATFORM_PROJECT` → `RoboflowPlatformProjectMetadata(project_url)` — ブロックが読み取り先または書き込み先とする Roboflow プロジェクトです。
* `DependentResourceType.THIRD_PARTY_MODEL` → `ThirdPartyModelMetadata(provider, model_id)` — 外部プロバイダーによって実行されるモデルです。定義上、リモート実行です。
ファクトリヘルパーを使うと、実装を1行で済ませられます: `roboflow_platform_model()`, `roboflow_platform_project()`, `third_party_model()`.
#### セレクター値とランタイム解決
マニフェストのフィールドには、具体的な値の代わりにワークフローセレクターが入ることがあります。この宣言はそのような値を **そのまま** — ブロックはセレクターを解決しません。呼び出し側は `$inputs.` 参照を、ランタイムパラメータが分かり次第置き換えられます。 `$steps..` 参照は静的にはまったく解決できません。すべてのメタデータエンティティは `requires_runtime_resolution()` を公開しているため、呼び出し側は具体的な識別子と、まだ解決が必要な参照を区別できます。
最終的な識別子が *関数* である場合(たとえば `clip/`のようなファミリープレフィックスやカタログ検索など)、置換された入力値だけでは実行される ID にはなりません。そのような宣言には **`model_id_resolver`** — 必要なものをすべてクロージャに保持した呼び出し可能オブジェクトで、置換後の値を最終 ID に変換します。この resolver はプロセス内専用の補助であり、シリアライズ、JSON スキーマ、等価性の対象外です。プロセス内の呼び出し側(たとえばエンジンの初回実行時の事前読み込み)は、入力値を置換した後にこれを呼び出します。resolver は `None` 値が静的には解決不能であることを宣言するために返してもかまいません(最終 ID がその1つの値だけに依存しない)— 呼び出し側はそのような依存関係をスキップし、実行時に解決されます。例外を送出する場合、その値は本当に無効です。
#### 何を反映するかというと `run()` が読み込む内容
宣言された識別子は、まさに `run()` が要求するものと同一でなければなりません。バージョンフィールドから合成される ID も含みます。ブロックが `f"my_family/{self.version}"` を `load_core_model(...)` の呼び出し箇所で組み立てるなら、宣言も同じ ID を組み立てなければなりません(そして version フィールドにセレクターが入っている場合は、そのままのセレクターにフォールバックします)。
#### 例
モデルと、任意のアクティブラーニング対象プロジェクトを宣言するモデルブロック:
```python
from inference.core.workflows.prototypes.block import (
DependentResource,
WorkflowBlockManifest,
roboflow_platform_model,
roboflow_platform_project,
)
class BlockManifest(WorkflowBlockManifest):
# ...
def discover_dependent_resources(self) -> Optional[List[DependentResource]]:
resources = [roboflow_platform_model(model_id=self.model_id)]
if self.active_learning_target_dataset is not None:
resources.append(
roboflow_platform_project(
project_url=self.active_learning_target_dataset
)
)
return resources
```
version フィールドからモデル ID が合成されるブロック:
```python
from inference.core.workflows.prototypes.block import (
DependentResource,
WorkflowBlockManifest,
is_workflow_selector,
roboflow_platform_model,
)
class BlockManifest(WorkflowBlockManifest):
# ...
def discover_dependent_resources(self) -> Optional[List[DependentResource]]:
if is_workflow_selector(self.version):
# セレクターはそのまま返されます。resolver が最終 ID を生成します
# 入力値が置換された後に。
return [
roboflow_platform_model(
model_id=self.version,
model_id_resolver=lambda version: f"clip/{version}",
)
]
return [roboflow_platform_model(model_id=f"clip/{self.version}")]
```
実行せずにモデルエンティティを参照するだけのシンク:
```python
from inference.core.workflows.prototypes.block import (
DependentResource,
ModelRequiredAction,
WorkflowBlockManifest,
roboflow_platform_model,
)
class BlockManifest(WorkflowBlockManifest):
# ...
def discover_dependent_resources(self) -> Optional[List[DependentResource]]:
return [
roboflow_platform_model(
model_id=self.model_id,
required_action=ModelRequiredAction.ACCESS,
)
]
```
#### 宣言しない場合
単に *含む* モデル ID や project-kind の値を汎用ペイロードとして持ち運ぶだけ(たとえば、値をクエリパラメータとして転送する webhook シンク)なら、リソース依存関係ではありません。そのようなブロックは意図的にデフォルトのままにします。
コアリポジトリの貢献者は、ユニットテスト(`tests/workflows/unit_tests/core_steps/test_dependent_resources.py`)が境界を守っていることを認識してください。マニフェストで次の `roboflow_model_id` または `roboflow_project` kind を宣言するすべてのコアブロックは、必ずオーバーライドするか `discover_dependent_resources()` あるいは、明示的に carry-only として許可リストに入れられていなければなりません。
モデル重みを読み込むブロックは **model manager の外で** (何をしているかを確認してください。実際に何をするかを確認し、 `run()` 実際に何をするかではなく、 `model_manager` init パラメータに現れるかどうかではありません)は、当面このメソッドを実装すべきではありません。依存関係は未宣言のままです(`None`).
カスタム Python ブロックは常に `None`を報告します。コードは静的解析からは不可視なので、 *不明* が唯一の正直な答えです。